GitHub Copilot HydraFusion: den Multi-Modell-Orchestrator aktivieren
Was GitHub Copilot HydraFusion ist (ein Research-Preview-Orchestrator, kein Modell), wie du ihn in Copilot CLI, VS Code und der Copilot app aktivierst, wie die Ausführungsmuster Single, Cascade und Critique funktionieren, wann sich HydraFusion Max lohnt und was er abrechnet — alles an echten Screen-Recordings.
HydraFusion auf einen Blick
- HydraFusion ist ein Orchestrator, kein Modell: Er liest jeden Prompt selbst und wählt Ausführungsmuster, Reasoning-Aufwand pro Durchlauf und die Modelle aus — du wählst nie manuell ein Modell.
- Drei Ausführungsmuster: Single (ein Modell macht alles), Cascade (günstiger Entwurf → Judge → Eskalation nur, wenn der Check scheitert) und Critique (Frontier-Entwurf → günstiger Kritiker → einmal überarbeiten).
- In drei Schritten aktiviert: copilot update → copilot --experimental → /model → HydraFusion (Research Preview). VS Code 1.140+ nutzt die Einstellung chat.copilot.hydraFusion.enabled; die Copilot app hat einen Schalter unter Settings → Experimental.
- Abgerechnet wird pro Modell zum jeweiligen Standardtarif — es gibt keinen separaten HydraFusion-Aufschlag, und der Auto-Rabatt bei der Modellwahl greift nicht. /usage zeigt die AI-Credits pro Modell.
- HydraFusion Max (hinzugefügt am 2026-10-14) ergänzt einen extra-hohen Reasoning-Aufwand für anspruchsvolle Aufgaben. Verworfene Entwürfe machen ihre Dateiänderungen nicht automatisch rückgängig — vor dem Commit prüfen.
Project HydraFusion: Multi-model orchestration in GitHub Copilot
KanalGitHub14:27
Using HydraFusion — GitHub Copilot documentation
Dokudocs.github.com
Die Frames stammen aus GitHubs eigenem Copilot-Day-Deep-Dive und dem offiziellen Introducing Project HydraFusion-Trailer — Vollbild-Demo-Mitschnitte ohne Facecam und ohne eingebrannte Untertitel in jedem behaltenen Frame. Die Fakten sind gegen die Using-HydraFusion-Dokumentation und den Changelog vom 2026-10-14 geprüft. Die eingeblendeten Modellnamen zeigen den Pool zum Launch (GPT-5.6 Sol, Claude Opus 5, Fable 5.1); der Pool wurde inzwischen auf Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna aktualisiert.
Die Rechte an den Videoframes bleiben bei ihren Urhebern; sie sind hier als Schritt-für-Schritt-Dokumentation mit Quellenangabe und Deep-Links eingebettet.
HydraFusion Schritt für Schritt aktivieren und nutzen
Schritt 1 — Wissen, was du aktivierst
- 1
Verstehen, was HydraFusion ist
HydraFusion steht in der Modellauswahl, ist aber kein Modell, sondern ein Orchestrator, der jeden Prompt als Optimierungsproblem behandelt. Pro Anfrage wählt er das Ausführungsmuster (Single, Cascade oder Critique), einen Reasoning-Aufwand für jeden Durchlauf und welche Modelle welchen Durchlauf übernehmen — gestützt auf Capability-Signale für Reasoning, Code-Generierung, Debugging und Tool-Nutzung. Die Entscheidung fällt pro Prompt: Zwei Prompts in einer Session können also komplett unterschiedliche Pläne fahren — und der Router selbst generiert keinen Teil der Antwort.
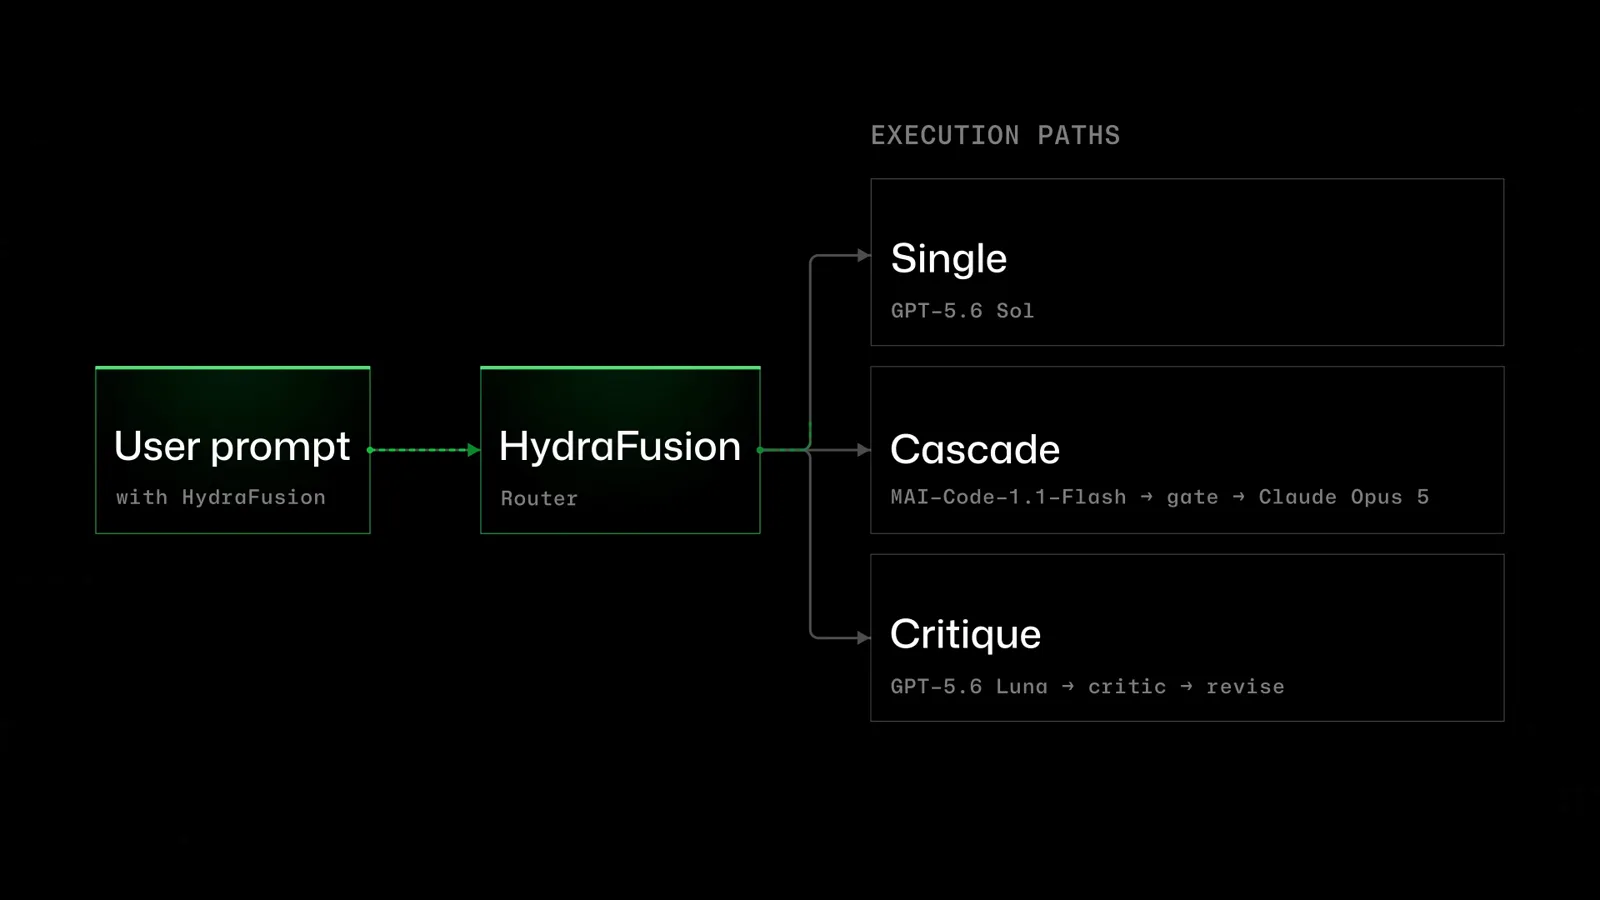
Das Ausführungswege-Diagramm aus GitHubs Intro-Animation: ein Nutzer-Prompt, vom HydraFusion-Router zu Single, Cascade (Entwurf → Gate → stärkeres Modell) und Critique (Entwurf → Kritiker → Überarbeitung) geroutet.Ansehen bei 0:42 - 2
Prüfen, ob du ihn überhaupt bekommst
HydraFusion ist eine Research Preview: keine SLA, nichts für Produktions-Workloads, Änderungen vorbehalten. Er ist in drei Oberflächen verfügbar — Copilot CLI, VS Code 1.140+ (oder Insiders) und die GitHub Copilot app. An einer Hürde scheitern viele: Die Auswahl bietet HydraFusion nur an, wenn dein Plan und die Modellrichtlinien deiner Organisation mindestens einige Modelle aus seinem Pool erlauben. Qualifiziert sich kein erlaubtes Modell, erscheint der Eintrag einfach nie — und in verwalteten Enterprise-Umgebungen muss ein Admin zunächst Preview-Funktionen freischalten.
- 3
Zuerst die Copilot CLI updaten
Führe zuerst copilot update aus — der HydraFusion-Eintrag ist ein junges Feature, ältere Builds listen ihn nicht. Wenn /model nach dem nächsten Schritt immer noch nichts zeigt, holt /update prerelease die CLI auf den Prerelease-Kanal, auf dem die Preview zuerst ausgerollt wird. VS Code braucht 1.140 oder neuer (oder Insiders); die Copilot app braucht nur den neuesten Build.
Schritt 2 — Einschalten und den ersten Prompt senden
- 4
Experimentelle Funktionen einschalten
HydraFusion versteckt sich hinter dem Experimental-Flag. Für einen einmaligen Lauf übergibst du es inline: copilot --experimental --model hydrafusion -p "YOUR-PROMPT". Um ihn in jeder Session zu haben, führe /experimental on aus und starte die CLI neu. In VS Code aktivierst du die Einstellung chat.copilot.hydraFusion.enabled; in der Copilot app klickst du dich durch Settings → Experimental → HydraFusion.
- 5
HydraFusion in der Modellauswahl wählen
Öffne /model und wähle HydraFusion (Research Preview) — er erscheint in der Liste wie ein Modell, obwohl er keines ist. Lies die zwei Zeilen, die die Auswahl ausgibt, bevor du weitermachst: "HydraFusion routes the first eligible turn and may use multiple models. Premium usage varies with the selected route." Die Änderung gilt nur für die aktuelle Session; mit /config model machst du sie zum Standard für künftige Sessions.
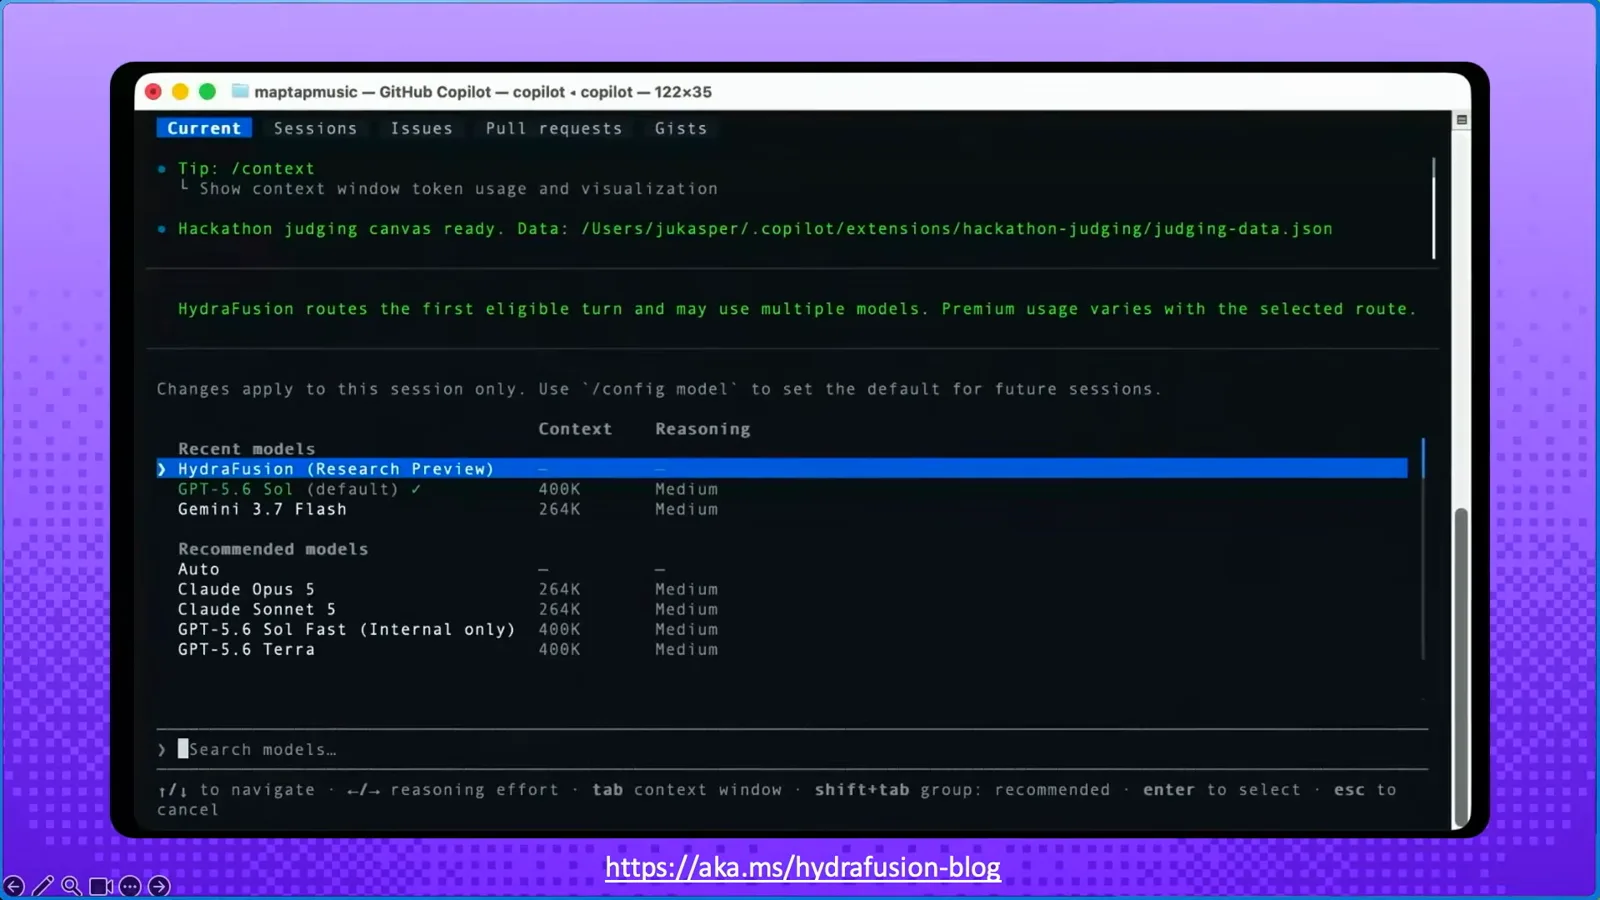
Die Modellauswahl der Copilot CLI mit hervorgehobenem HydraFusion (Research Preview) unter Recent models, über dem Pool zum Launch: GPT-5.6 Sol (Standard), Gemini 3.7 Flash, Claude Opus 5, Claude Sonnet 5 und GPT-5.6 Terra.Ansehen bei 1:00 - 6
Prompt senden und zusehen, wie der Plan entsteht
Schick eine echte Aufgabe, und die Fortschrittsansicht zeigt, was der Router entschieden hat: das gewählte Muster, den Status jedes Durchlaufs, die aktuelle Aktivität und die verstrichene Zeit — "Fusion · selecting an approach…", "Fusion · drafting…", "Fusion · checking…", "Fusion · preparing final response…". Mit Esc brichst du einen Lauf ab; eine Zusammenfassung bleibt danach in der Konversation. In VS Code und der Copilot app zeigt der Hover über den Antwort-Footer, welche Modelle im Einsatz waren.
Schritt 3 — Die drei Ausführungswege lesen
- 7
Einen SINGLE-Plan lesen: ein Modell reichte
Bei der Type-Hints-und-Docstrings-Aufgabe wählte der Router SINGLE: einen SOLVE-Durchlauf mit gpt-5.6-sol — kein zweites Modell, kein Review-Schritt. Die CLI vermaß die ganze Aufgabe mit 5,3 AIU, während Opus 5 allein 32,1 und Fable 5.1 allein 20,3 auf denselben Prompt verbrannte. SINGLE bekommst du bei klar umrissener Arbeit: Der Router zahlt kein Review, das er nicht braucht.
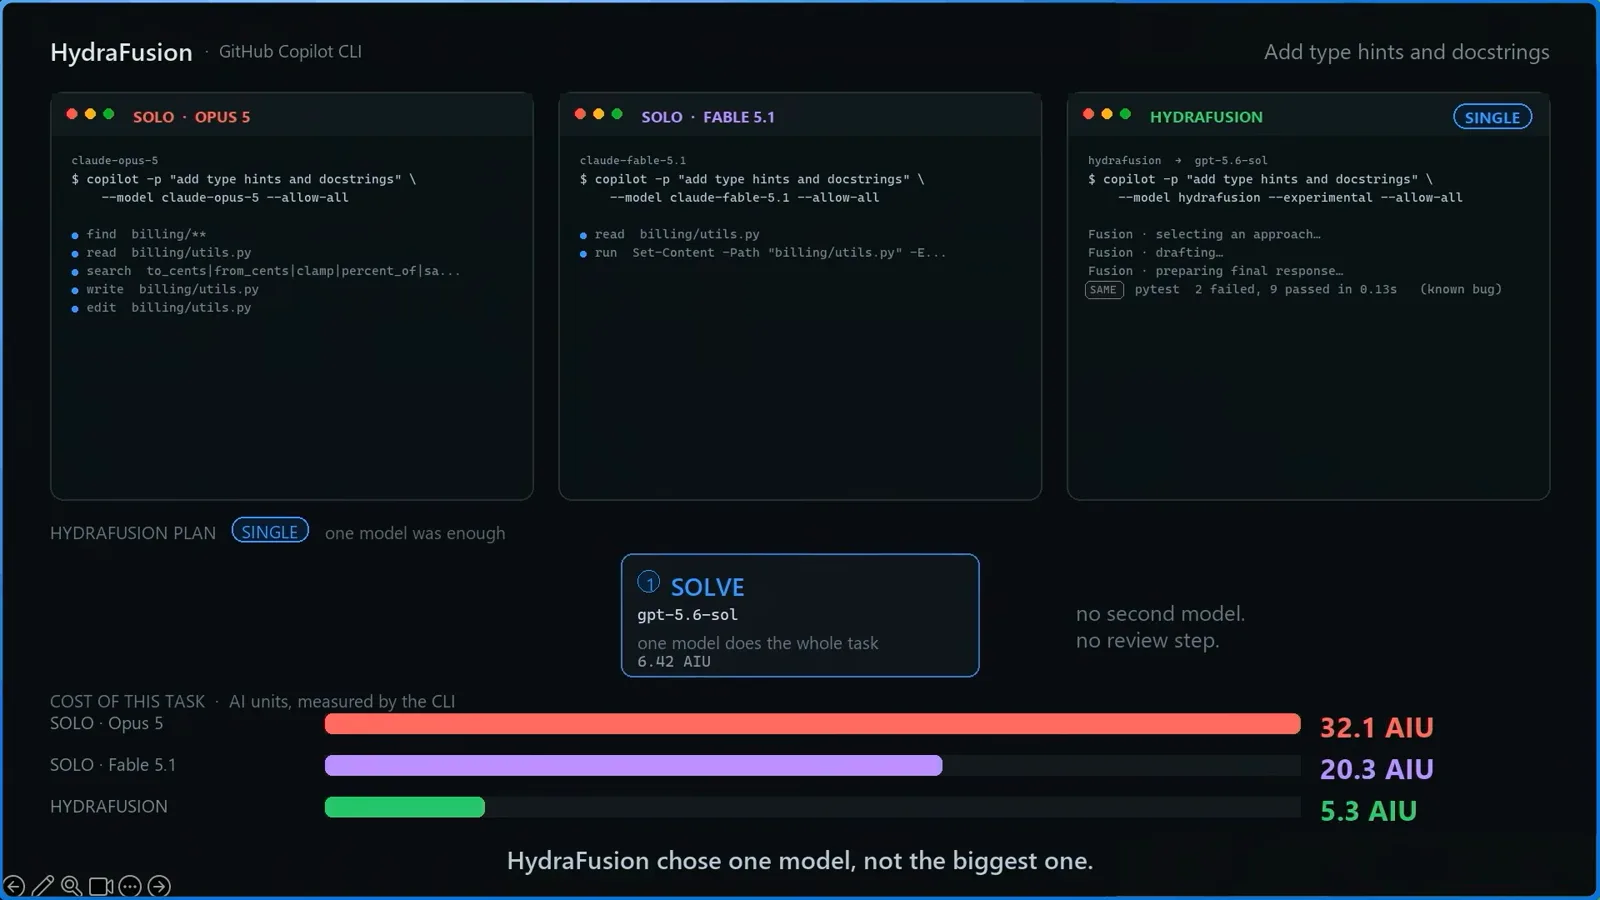
Die SINGLE-Plan-Karte — SOLVE mit gpt-5.6-sol, „one model does the whole task“ — neben den Kostenbalken: HydraFusion 5,3 AIU vs. Opus 5 allein mit 32,1 und Fable 5.1 allein mit 20,3 bei derselben Type-Hints-Aufgabe.Ansehen bei 6:40 - 8
Einen CASCADE-Plan lesen: günstig entwerfen, nur bei Scheitern eskalieren
Bei „fix the failing retry tests“ fuhr der Router CASCADE: gpt-5.6-luna entwarf für 0,86 AIU, ein gpt-5.6-sol-Judge bewertete den Versuch für 0,22 und druckte „verdict: reject“, dann machte gpt-5.6-sol die Arbeit für 5,25 neu — danach schlug die Suite grün an (pytest 11 passed). Insgesamt: 5,5 AIU gegenüber 27,2 für Opus 5 allein. Cascade zahlt den Eskalationspreis nur, wenn der billige Entwurf den Check wirklich nicht besteht.
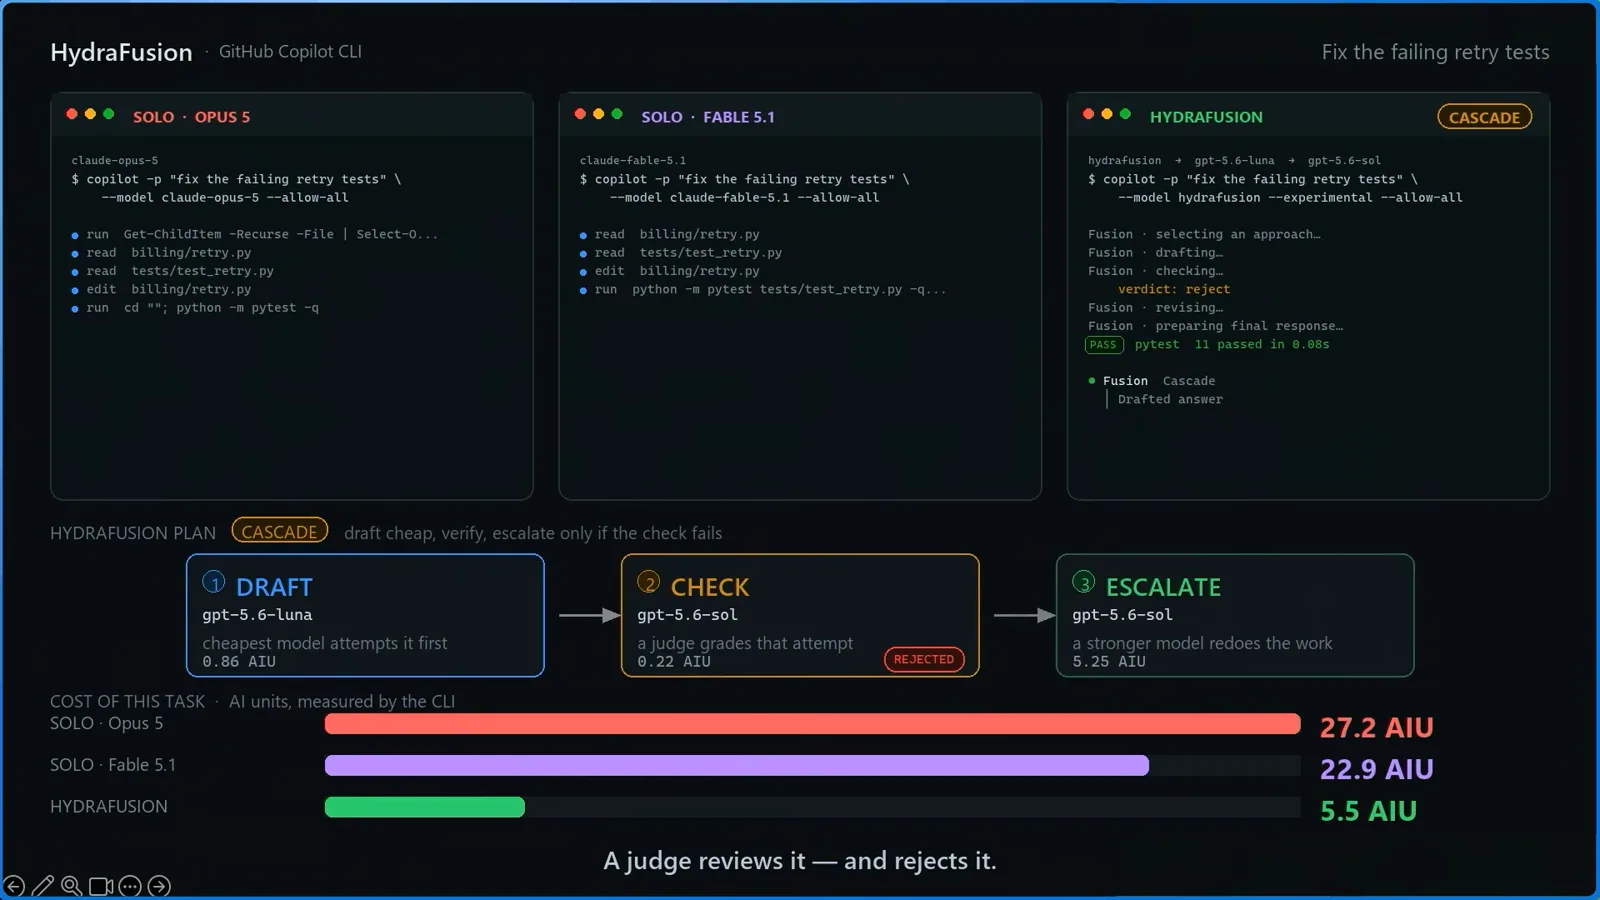
Die CASCADE-Kette bei der Retry-Tests-Aufgabe: DRAFT gpt-5.6-luna (0,86 AIU) → CHECK-Judge (0,22 AIU) mit REJECTED abgestempelt → ESCALATE gpt-5.6-sol (5,25 AIU), die Aufgabenbalken summieren sich auf 5,5 AIU.Ansehen bei 7:40 - 9
Einen CRITIQUE-Plan lesen: ein zweites Modell reviewen lassen
Bei der Migration des Charge-Endpoints — mit großem Blastradius — griff der Router zu CRITIQUE: claude-opus-5 entwarf (47,16 AIU), gpt-5.6-sol prüfte den Entwurf für 0,60 und stempelte ihn SENT BACK, dann überarbeitete claude-opus-5 einmal für 15,86, bis die Suite durchlief. Critique ist das teure Muster — hier 60,7 AIU, mehr als Opus 5 allein mit 39,9 — und genau das reserviert der Router für Arbeit, bei der ein falscher Merge mehr kostet als das Review.
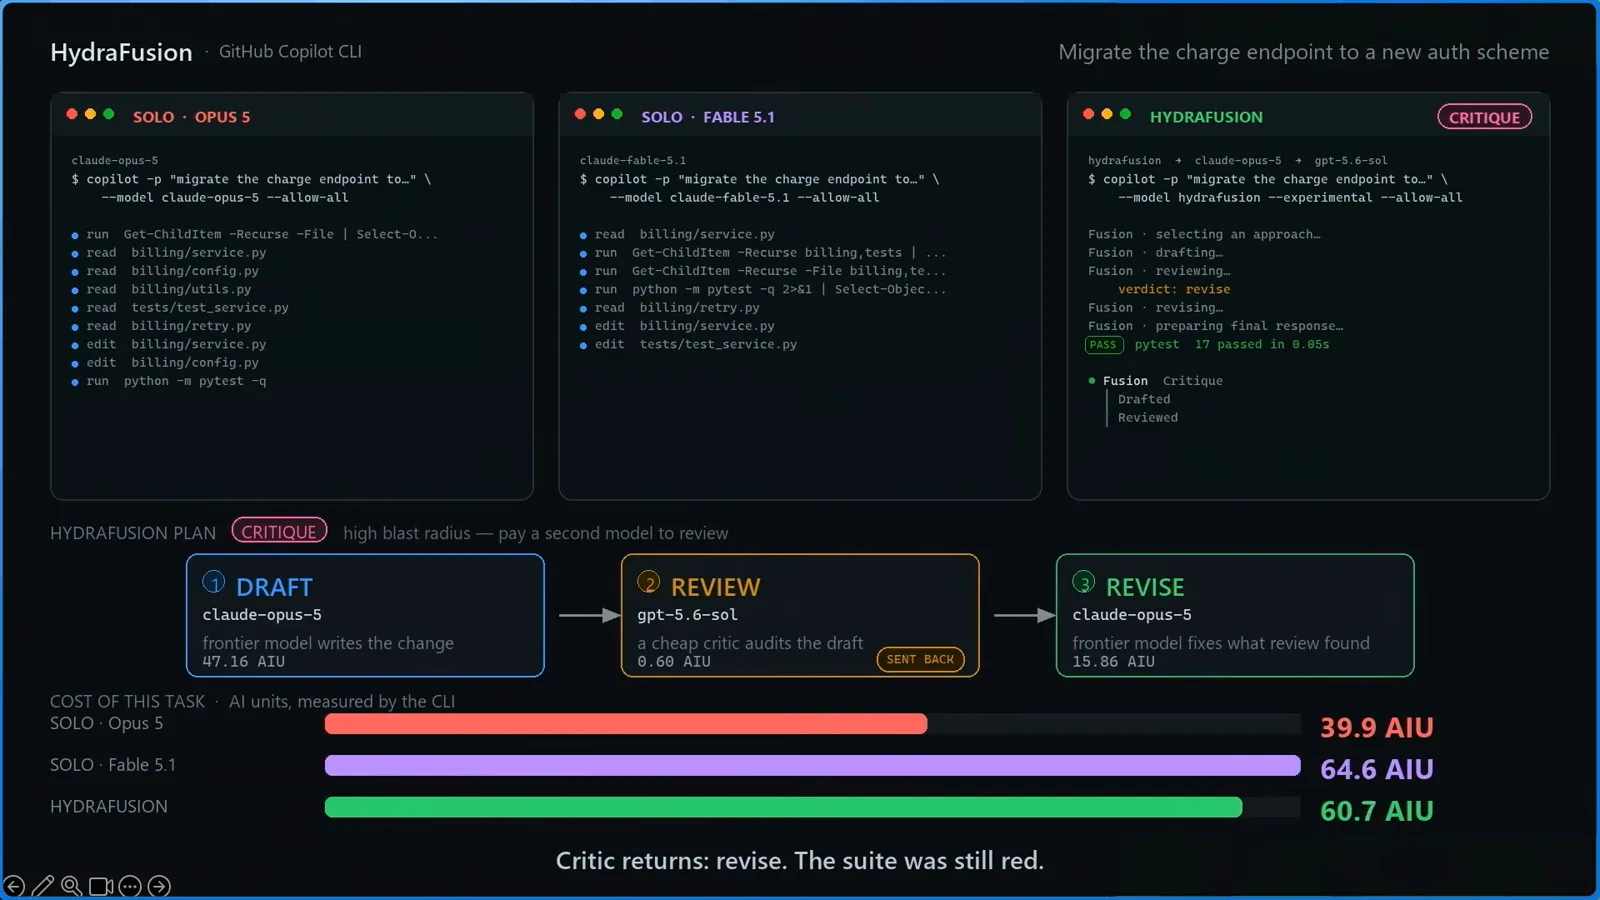
Die CRITIQUE-Kette bei der Endpoint-Migrations-Aufgabe: DRAFT claude-opus-5 → REVIEW gpt-5.6-sol (SENT BACK) → REVISE claude-opus-5, insgesamt 60,7 AIU gegenüber Opus 5 allein mit 39,9 und Fable 5.1 allein mit 64,6.Ansehen bei 8:20
Schritt 4 — Max, Abrechnung und sauberes Aussteigen
- 10
Für anspruchsvolle Aufgaben zu HydraFusion Max wechseln
Der Changelog vom 2026-10-14 ergänzte die Auswahl um einen zweiten Eintrag: HydraFusion Max. Standard-HydraFusion entwirft mit mittlerem Reasoning-Aufwand und reviewt mit hohem, positioniert für substanzielle, klar umrissene Arbeit — komplexe Bugfixes, Multi-File-Änderungen. Max ergänzt einen extra-hohen Reasoning-Aufwand und ist auf Frontier-Capability für die anspruchsvollsten Aufgaben getrimmt. Gewählt wird er aus derselben /model-Liste; alles andere am Workflow bleibt identisch.
- 11
Die Rechnung mit /usage prüfen
HydraFusion rechnet pro Modell zum jeweiligen Standardtarif ab — kein separater HydraFusion-Aufschlag, und der Auto-Rabatt bei der Modellwahl greift nicht. Führe /usage in der CLI aus, um die AI-Credits pro Modell zu sehen. Im aufgezeichneten Lauf über vier Aufgaben lagen die Summen bei 84,8 AIU für HydraFusion gegenüber 146,5 für Opus 5 allein und 159,0 für Fable 5.1 allein — 42 % und 47 % günstiger — aber allein die critique-lastige Aufgabe kostete 63,6: Der Routenmix treibt die Rechnung.
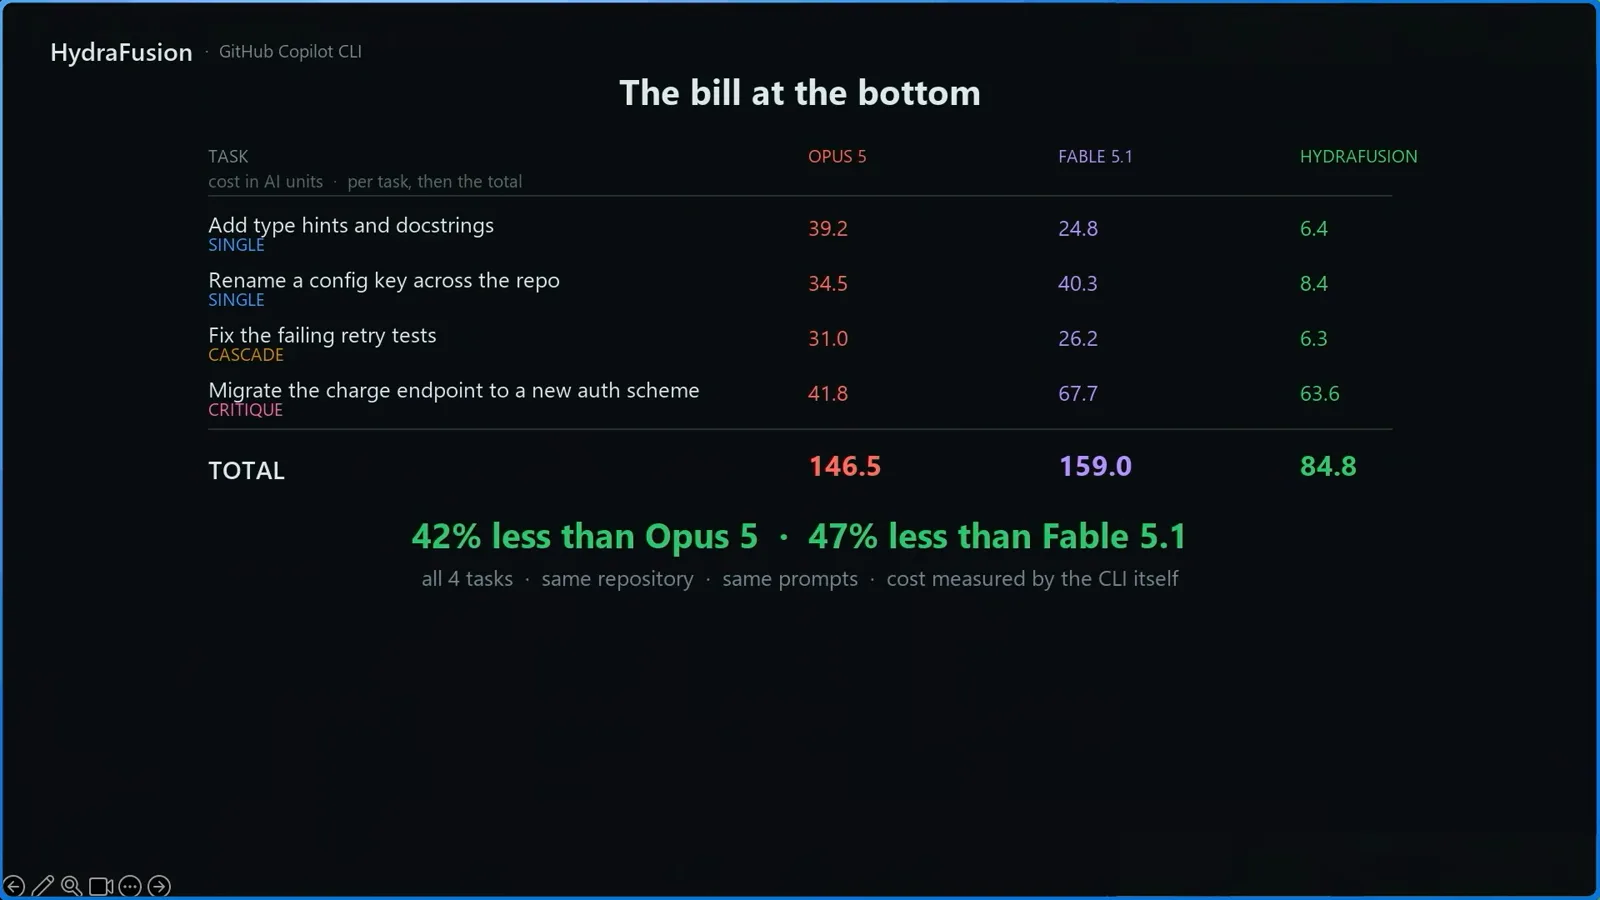
Die Folie „The bill at the bottom“: AIU pro Aufgabe für die vier Demo-Aufgaben und die Summen — HydraFusion 84,8 vs. Opus 5 allein mit 146,5 und Fable 5.1 allein mit 159,0, 42 % und 47 % günstiger.Ansehen bei 9:00 - 12
Verworfene Entwürfe vor dem Commit prüfen
Zwei Preview-Einschränkungen, die du dir angewöhnen solltest. Erstens: Wird ein Durchlauf verworfen — ein Cascade-Entwurf, den der Judge ablehnt, ein Critique-Durchlauf, der zurückgeschickt wird —, werden die Workspace-Änderungen, die er bereits gemacht hat, nicht automatisch rückgängig gemacht; also Diff ansehen und prüfen, bevor du committest. Zweitens: HydraFusion arbeitet weder mit Subagents zusammen noch startet er welche. Für Routine-Prompts bleibt das schlichte Auto die günstige Voreinstellung; die offiziellen Benchmarks behaupten TerminalBench 2.1 mit 67 % niedrigeren Kosten plus 4,9 Qualitätspunkten, DeepSWE 36 % niedriger (−1,5 Punkte) und CheckpointBench 65 % niedriger (−0,1 Punkte) gegenüber Opus 5.
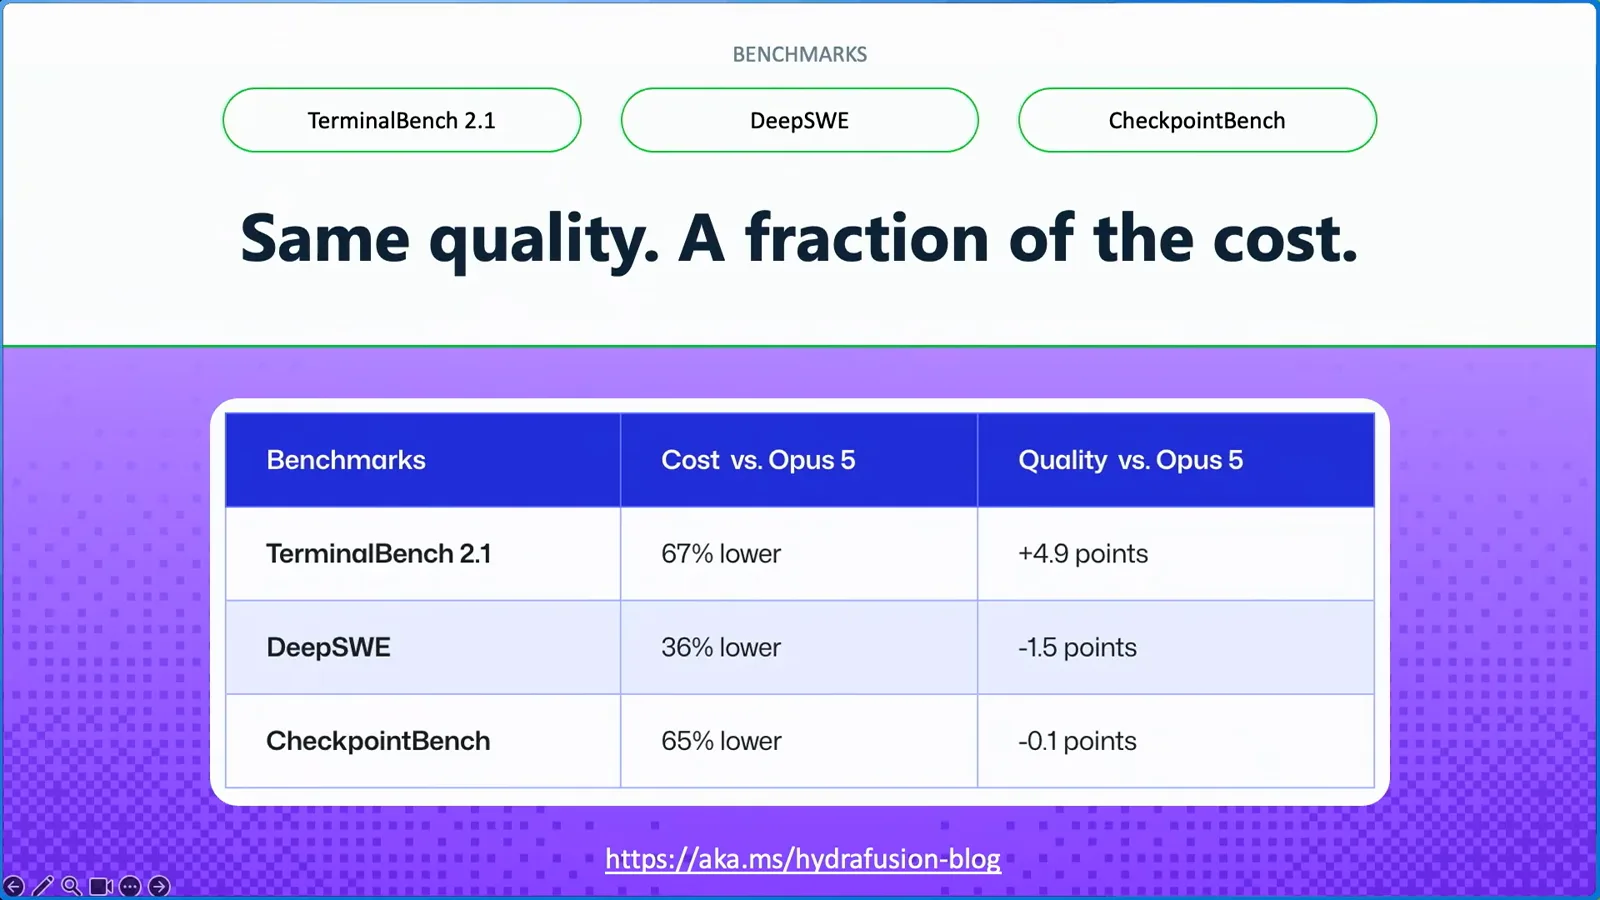
Die Benchmark-Tabelle aus dem offiziellen Walkthrough: TerminalBench 2.1 mit 67 % niedrigeren Kosten und +4,9 Qualitätspunkten gegenüber Opus 5, DeepSWE 36 % niedriger, CheckpointBench 65 % niedriger.Ansehen bei 10:25
HydraFusion vs. HydraFusion Max
Beide Einträge leben in derselben Modellauswahl und fahren denselben Router — der Unterschied ist, wie hart jeder Durchlauf denken darf. GitHub hat die Max-Option im Changelog vom 2026-10-14 („HydraFusion updates and new Max option“) ausgeliefert, zusammen mit dem aktualisierten Modell-Pool (Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna), dem Reasoning-Aufwand pro Schritt und dem Cascade-Judging-Schritt.
- 1Standard-HydraFusion ist der Ausgleichsmodus: Entwürfe laufen mit mittlerem Reasoning-Aufwand, Reviews mit hohem — positioniert für substanzielle, klar umrissene Aufgaben wie komplexe Bugfixes und Multi-File-Änderungen.
- 2HydraFusion Max ergänzt einen extra-hohen Reasoning-Aufwand — die Doku beschreibt ihn als „tuned for frontier capability on more demanding tasks“, für das tiefste Reasoning und die gründlichste Analyse.
- 3Beide werden aus derselben Auswahl gewählt (HydraFusion und HydraFusion Max, beide als Research Preview gelabelt), und du kannst pro Session mit /model zwischen ihnen wechseln.
- 4Max multipliziert den Token-Verbrauch: Multi-Pass-Ausführung plus extra-hoher Aufwand pro Durchlauf verbrennt AI-Credits spürbar schneller als Standard — und jeder Durchlauf wird trotzdem zum Standardtarif seines Modells abgerechnet.
- 5Keiner der Einträge hat eine SLA, beide können sich während der Preview ändern, und keiner arbeitet mit Subagents zusammen — Max ist ein Capability-Regler, keine Stabilitätsstufe.
- 6Praktische Aufteilung: Standard-HydraFusion für die tägliche Multi-File-Arbeit, Max für die Aufgabe, die du sonst dem teuersten Solo-Modell geben würdest, und das schlichte Auto für Routine-Prompts, bei denen sich nicht mal der Router-Aufschlag lohnt.
Der aufgezeichnete Deep Dive ist älter als Max, seine Zahlen — 84,8 AIU über vier Aufgaben, 42–47 % unter den Solo-Modellen — messen also nur Standard-HydraFusion. Behandle sie als Untergrenze der Single-Route: Critique-lastige Aufgaben unter Max landen höher.