HydraFusion 速览
- HydraFusion 是编排器,不是模型:它读取每条 prompt,自己挑执行模式、每一轮的推理力度和用哪些模型——你从头到尾不用手动选模型。
- 三种执行模式:Single(一个模型包办全部)、Cascade(便宜的草稿 → 评审 → 只有检查不过才升级)和 Critique(旗舰草稿 → 便宜的批评者 → 修订一次)。
- 三步启用:copilot update → copilot --experimental → /model → HydraFusion (Research Preview)。VS Code 1.140+ 用 chat.copilot.hydraFusion.enabled 设置;Copilot 应用里有 Settings → Experimental 开关。
- 按模型计费,走该模型的标准费率——没有单独的 HydraFusion 费用,Auto 模型选择的折扣也不适用。/usage 按模型显示 AI 积分。
- HydraFusion Max(2026-10-14 加入)为吃重的任务增加 extra-high 推理力度。被丢弃的草稿不会自动撤销它已经做出的文件改动——提交前先审查一遍。
Project HydraFusion: Multi-model orchestration in GitHub Copilot
频道GitHub14:27
Using HydraFusion — GitHub Copilot documentation
文档docs.github.com
画面全部来自 GitHub 自家的 Copilot Day 深潜演示和官方《Introducing Project HydraFusion》预告片——保留帧均为全屏演示画面,没有人脸摄像头,也没有烧录字幕。事实核对的依据是 Using HydraFusion 官方文档和 2026-10-14 的更新日志。屏幕上的模型名显示的是发布时的模型池(GPT-5.6 Sol、Claude Opus 5、Fable 5.1);模型池此后已更新为 Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna。
视频截图版权归原创作者所有,此处以图文教程形式引用并署名、深链。
一步一步启用并读懂 HydraFusion
第 1 步 — 先弄清你启用的是什么
- 1
弄明白 HydraFusion 是什么
HydraFusion 出现在模型选择器里,但它不是模型——它是一个把每条 prompt 当成优化问题来处理的编排器。对每个请求,它依据推理、代码生成、调试和工具使用方面的能力信号,挑出执行模式(Single、Cascade 或 Critique)、每一轮的推理力度,以及哪个模型跑哪一轮。选择按 prompt 逐条进行,所以同一个会话里的两条 prompt 可能跑出完全不同的计划——而且路由器本身不生成答案的任何部分。
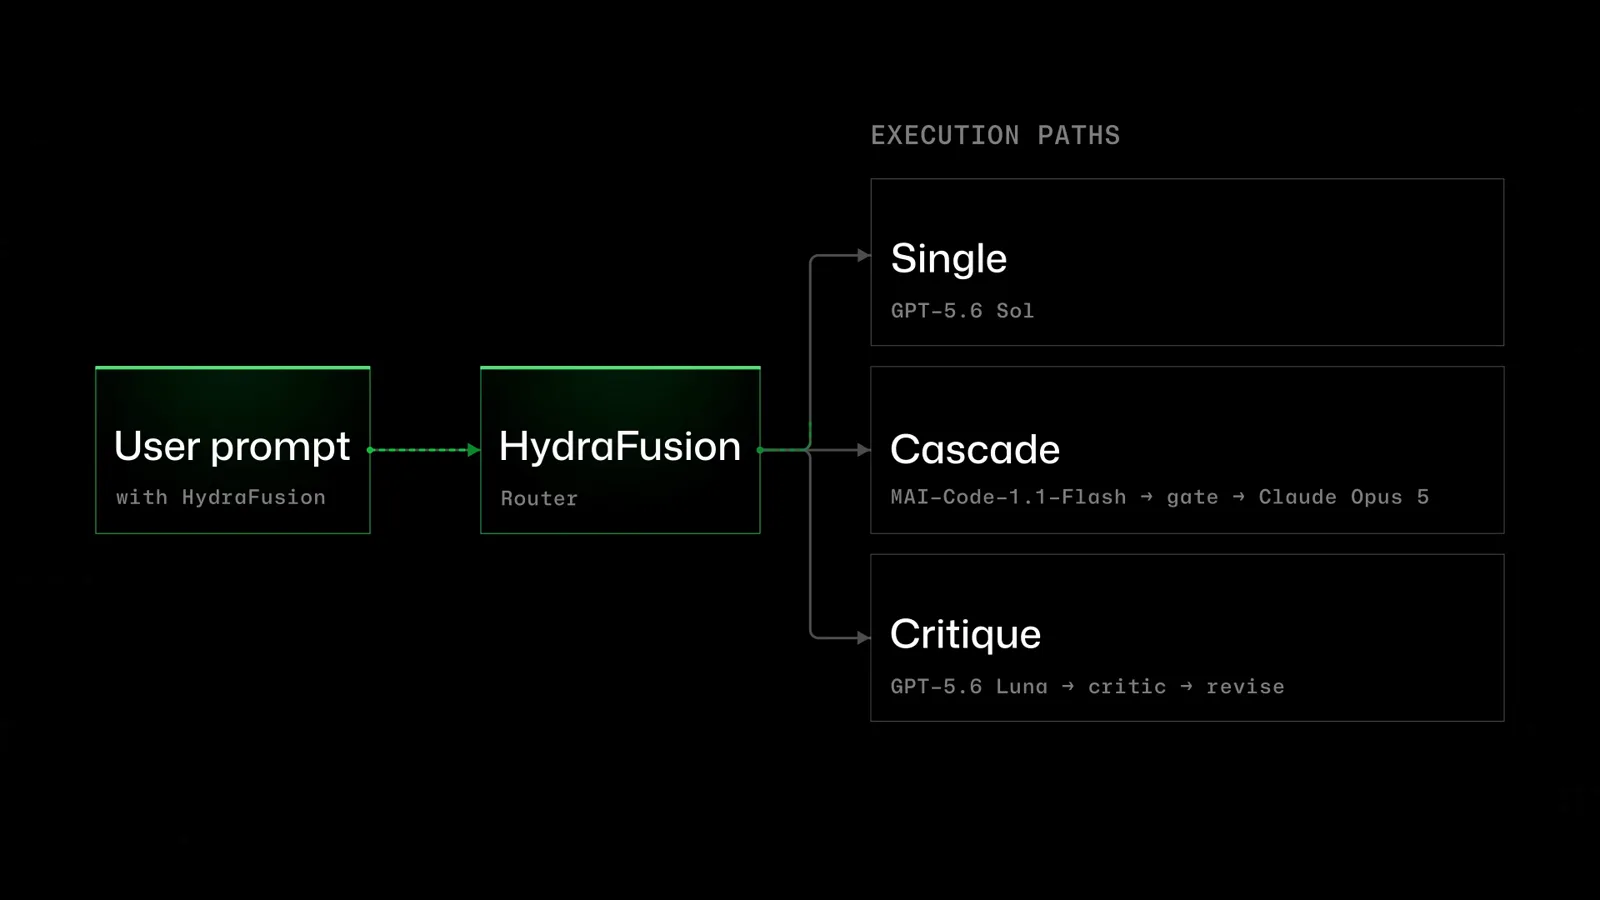
GitHub 片头动画里的执行路径图:一条用户 prompt 被 HydraFusion 路由器分派进 Single、Cascade(草稿 → 门禁 → 更强模型)和 Critique(草稿 → 批评者 → 修订)。在 0:42 观看 - 2
确认你真的能用上它
HydraFusion 是研究预览:没有 SLA,不面向生产负载,随时可能变化。它提供三个入口——Copilot CLI、VS Code 1.140+(或 Insiders)和 GitHub Copilot 应用。有一个门槛最容易绊倒人:只有当你的套餐和你组织的模型策略允许其模型池里至少一部分模型时,选择器才会提供 HydraFusion。如果没有任何被允许的模型符合条件,这个入口会悄无声息地永远不出现——而在受管的企业环境里,还得先由管理员启用预览功能。
- 3
先更新 Copilot CLI
先跑 copilot update 再做别的——HydraFusion 入口是新加的,旧版本不会列出它。如果做完下一步 /model 还是看不到,/update prerelease 会把 CLI 切到预发布通道,预览功能在那里最先上线。VS Code 需要 1.140 或更高(或 Insiders);Copilot 应用只要更新到最新版就行。
第 2 步 — 打开开关,发出第一条 prompt
- 4
打开实验功能
HydraFusion 藏在实验开关后面。只想跑一次,就内联带上:copilot --experimental --model hydrafusion -p "YOUR-PROMPT"。想让每个会话都有它,运行 /experimental on 然后重启 CLI。VS Code 里启用 chat.copilot.hydraFusion.enabled 设置;Copilot 应用里拨动 Settings → Experimental → HydraFusion。
- 5
在模型选择器里选 HydraFusion
打开 /model,选 HydraFusion (Research Preview)——虽然它不是模型,却像模型一样列在列表里。继续之前先读选择器打出的两行字:"HydraFusion routes the first eligible turn and may use multiple models. Premium usage varies with the selected route."(HydraFusion 会接管第一个符合条件的回合,可能使用多个模型;Premium 用量随所选路径而变。)这次更改只对当前会话生效;/config model 可以把它设成以后会话的默认值。
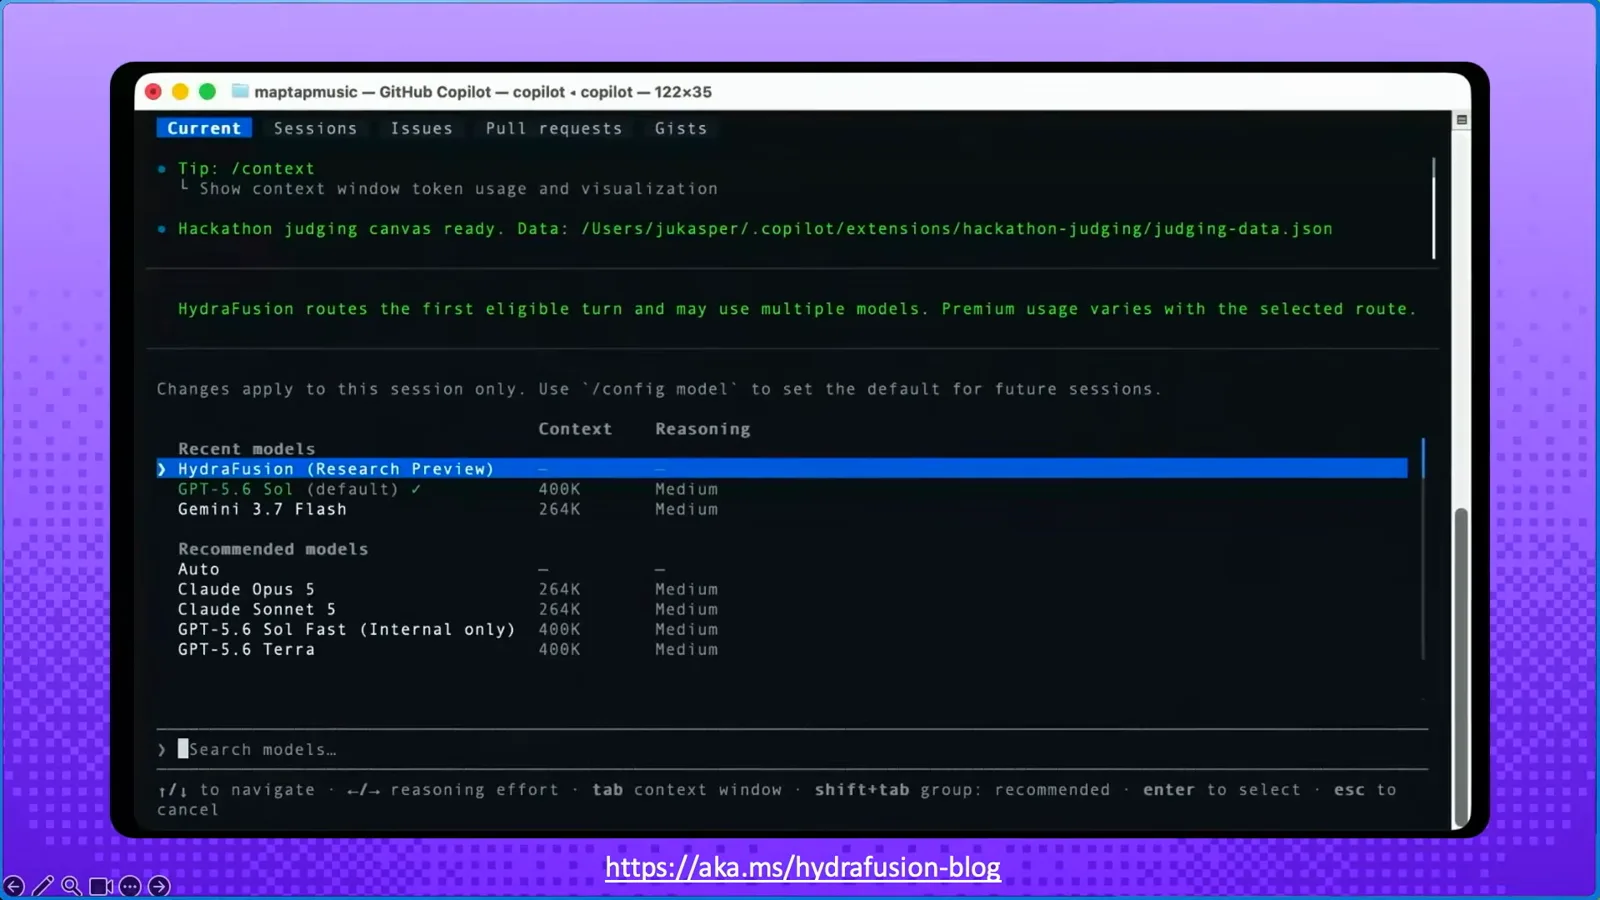
Copilot CLI 模型选择器:HydraFusion (Research Preview) 在 Recent models 分组里高亮,位于发布时模型池的上方——GPT-5.6 Sol(默认)、Gemini 3.7 Flash、Claude Opus 5、Claude Sonnet 5 和 GPT-5.6 Terra。在 1:00 观看 - 6
发出 prompt,看计划成形
发一个真实任务,进度视图会显示路由器的决定:选中的模式、每一轮的状态、当前活动和已用时间——"Fusion · selecting an approach…"、"Fusion · drafting…"、"Fusion · checking…"、"Fusion · preparing final response…"。按 Esc 可以中断一次运行;事后会话里会留下一条摘要。在 VS Code 和应用里,把鼠标悬停在回复页脚上,就能看到用了哪些模型。
第 3 步 — 读懂三条执行路径
- 7
读懂 SINGLE 计划:一个模型就够了
在类型注解和 docstring 任务上,路由器选了 SINGLE:只用 gpt-5.6-sol 跑一轮 SOLVE——没有第二个模型,没有评审环节。CLI 统计整个任务花了 5.3 AIU,而同一 prompt 上单干的 Opus 5 烧掉 32.1,单干的 Fable 5.1 烧掉 20.3。范围清晰的工作拿到的就是 SINGLE:路由器不会为不需要的评审买单。
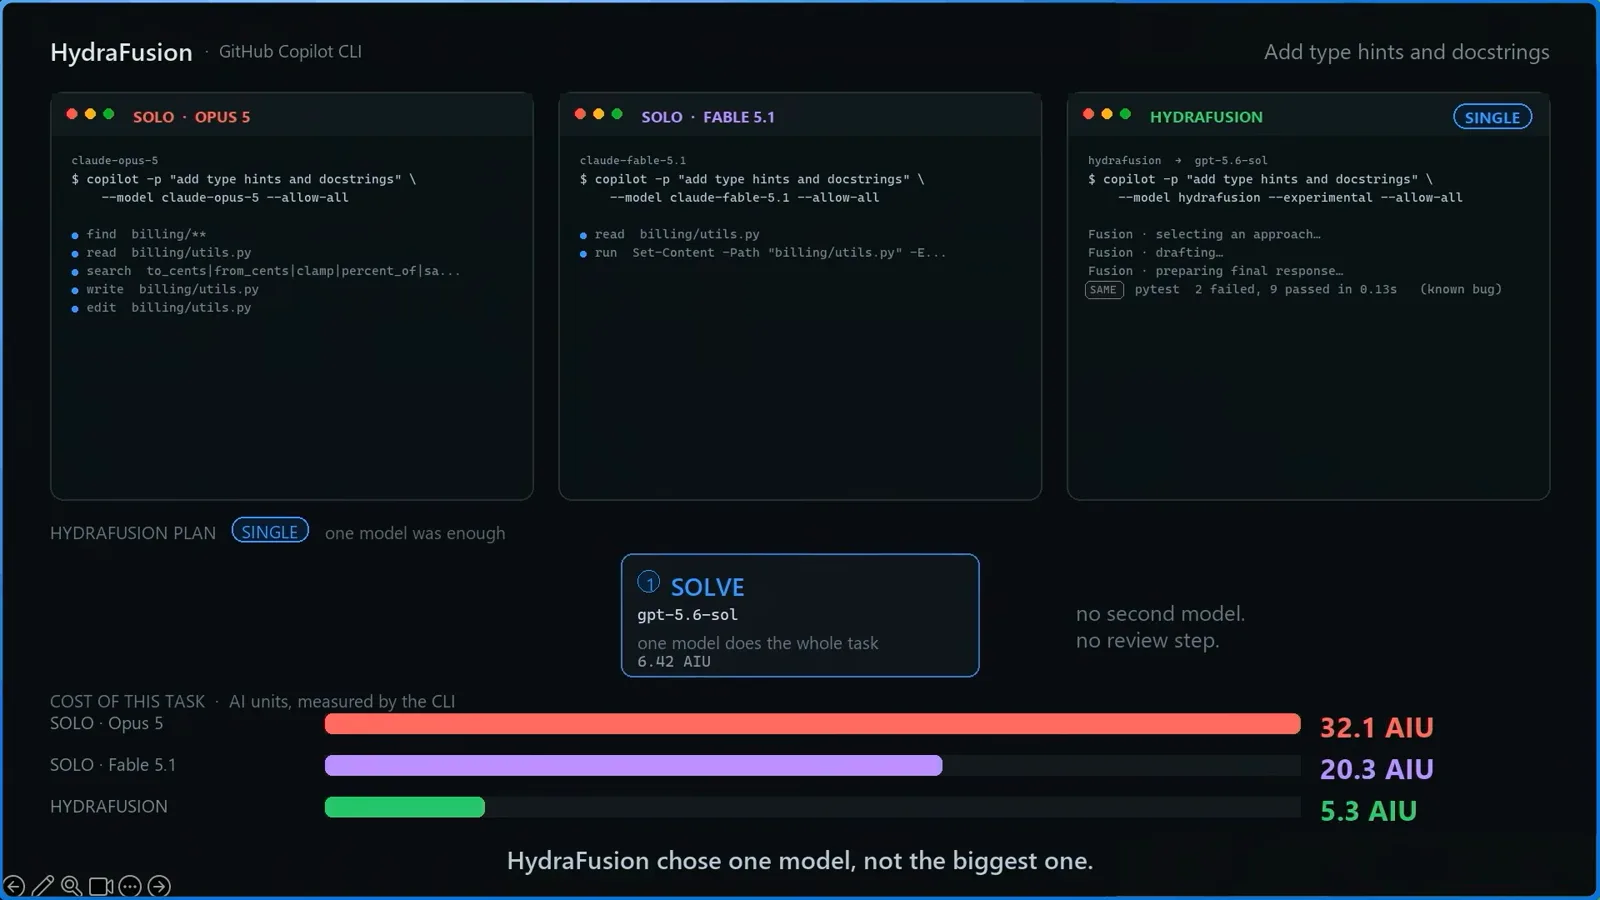
SINGLE 计划卡——SOLVE 用 gpt-5.6-sol,"one model does the whole task"——旁边是成本条:同一个类型注解任务上,HydraFusion 5.3 AIU,单干 Opus 5 为 32.1,单干 Fable 5.1 为 20.3。在 6:40 观看 - 8
读懂 CASCADE 计划:便宜起草,失败了才升级
在"修复失败的 retry 测试"上,路由器跑了 CASCADE:gpt-5.6-luna 起草花 0.86 AIU,gpt-5.6-sol 评审给这次尝试打分花 0.22,并打出 "verdict: reject",然后 gpt-5.6-sol 重做这份工作花 5.25——之后测试全绿(pytest 11 passed)。总计 5.5 AIU,单干 Opus 5 则要 27.2。只有当便宜草稿真的没过检查时,Cascade 才付升级的价钱。
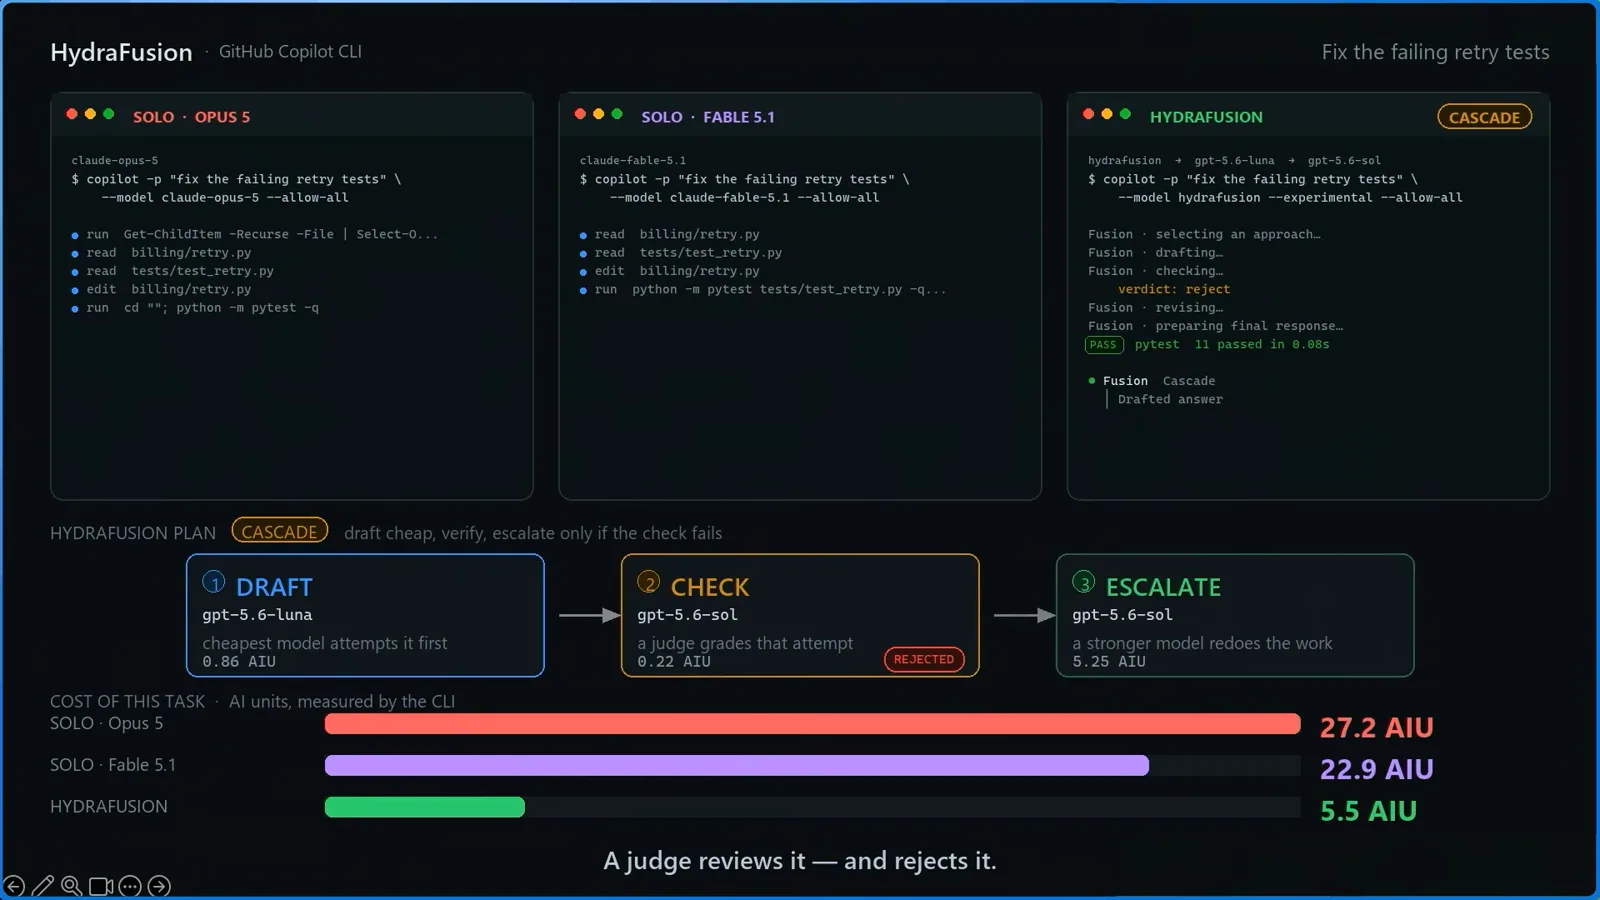
retry 测试任务上的 CASCADE 链:DRAFT gpt-5.6-luna(0.86 AIU)→ CHECK 评审(0.22 AIU)盖上 REJECTED → ESCALATE gpt-5.6-sol(5.25 AIU),任务条合计 5.5 AIU。在 7:40 观看 - 9
读懂 CRITIQUE 计划:花钱请第二个模型来审
在计费端点迁移上——波及面极大——路由器挑了 CRITIQUE:claude-opus-5 起草(47.16 AIU),gpt-5.6-sol 花费 0.60 审计草稿并盖上 SENT BACK,然后 claude-opus-5 花 15.86 修订一次,直到测试通过。Critique 是最贵的模式——这里 60.7 AIU,比单干 Opus 5 的 39.9 还高——路由器把它留给那种"合错东西比评审更贵"的工作。
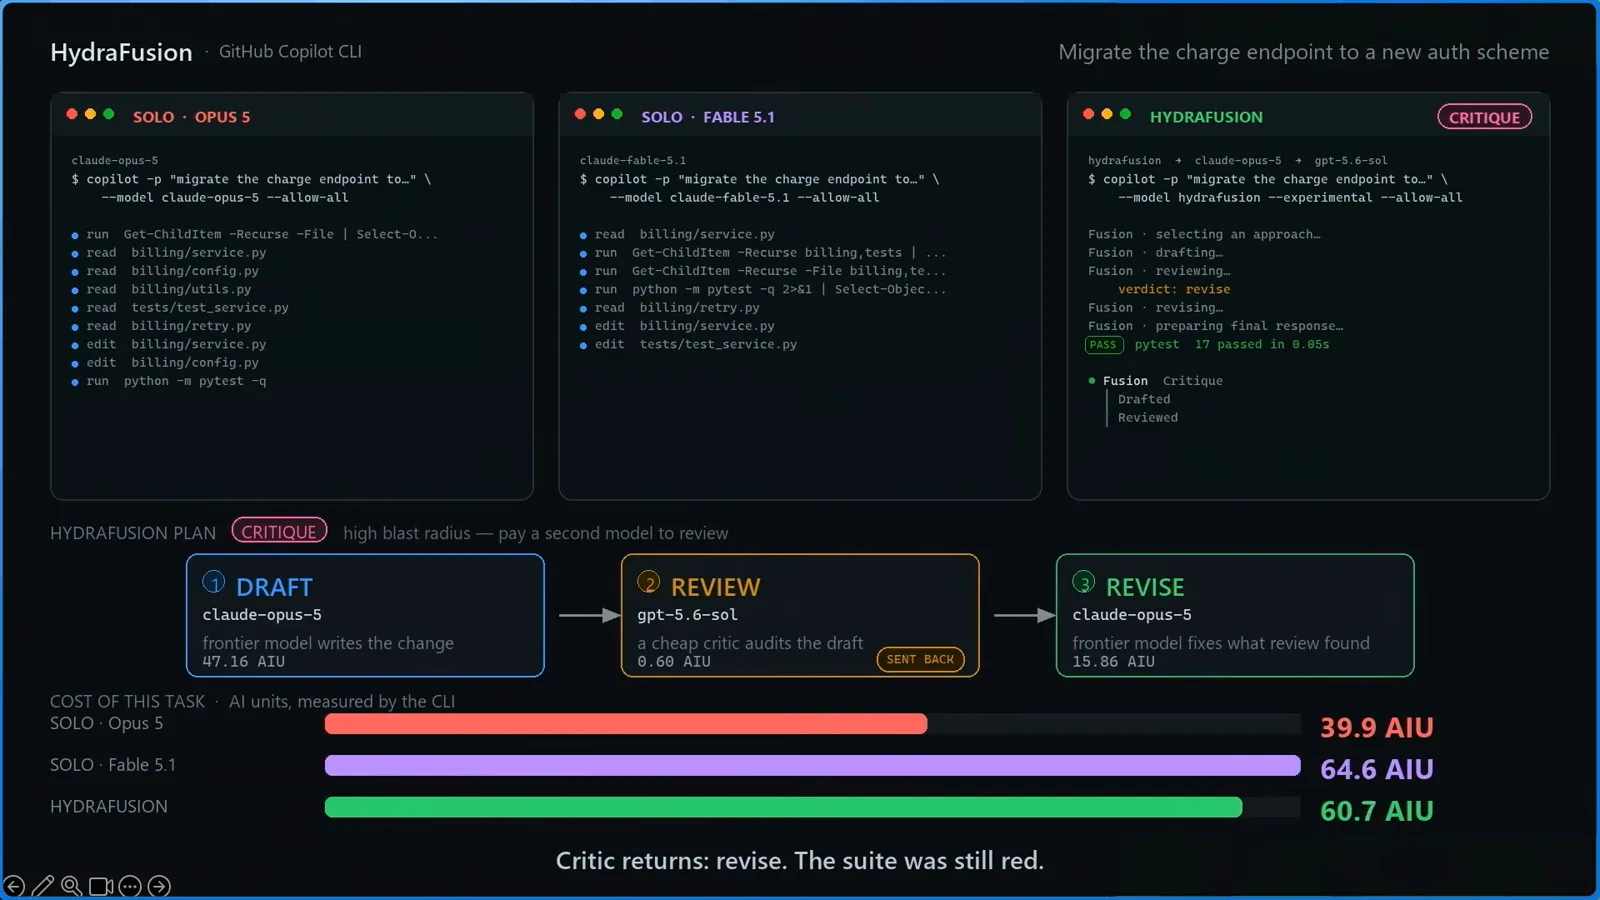
端点迁移任务上的 CRITIQUE 链:DRAFT claude-opus-5 → REVIEW gpt-5.6-sol(SENT BACK)→ REVISE claude-opus-5,合计 60.7 AIU,对比单干 Opus 5 的 39.9 和单干 Fable 5.1 的 64.6。在 8:20 观看
第 4 步 — Max、计费和干净的退场
- 10
吃重的任务换 HydraFusion Max
2026-10-14 的更新日志给选择器加了第二个条目:HydraFusion Max。标准版 HydraFusion 以 medium 推理力度起草、以 high 评审,定位是范围清晰的有分量任务——复杂 bug 修复、多文件改动。Max 增加 extra-high 推理力度,为最吃重任务上的前沿能力而调校。从同一个 /model 列表里选它;工作流的其他一切完全一样。
- 11
用 /usage 审一遍账单
HydraFusion 按模型计费,走该模型的标准费率——没有单独的 HydraFusion 费用,Auto 模型选择的折扣也不适用。在 CLI 里跑 /usage,按模型查看 AI 积分。录下来的四任务运行里,HydraFusion 总计 84.8 AIU,单干 Opus 5 为 146.5,单干 Fable 5.1 为 159.0——分别便宜 42% 和 47%——但光 critique 为主的那个任务就花了 63.6,所以账单由路径组合决定。
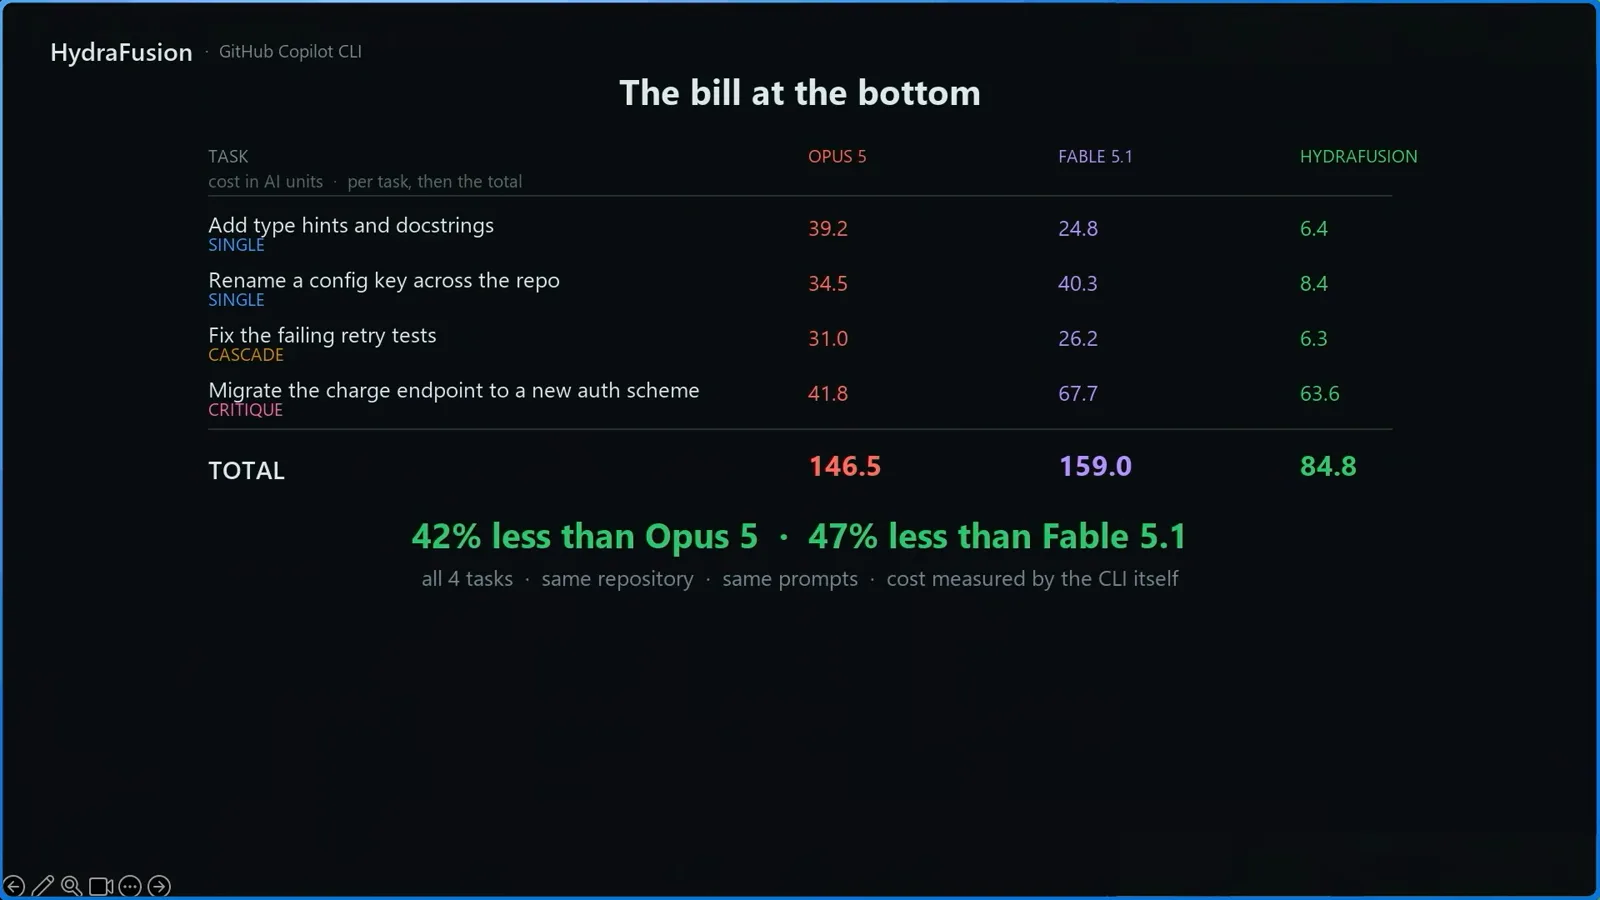
"The bill at the bottom" 幻灯片:四个演示任务各自的 AIU 和总计——HydraFusion 84.8,对比单干 Opus 5 的 146.5 和单干 Fable 5.1 的 159.0,便宜 42% 和 47%。在 9:00 观看 - 12
提交前审查被丢弃的草稿
有两个预览期限制,值得写进你的使用习惯。第一,如果某一轮被丢弃——被评审否决的 Cascade 草稿、被打回的 Critique 轮——它已经做出的工作区改动不会自动撤销,所以提交前先 diff、先审查。第二,HydraFusion 既不能配合 subagent 使用,也不会启动 subagent。例行 prompt 用纯 Auto 依然是便宜的默认选择;官方基准宣称对比 Opus 5:TerminalBench 2.1 成本低 67%、质量高 4.9 分,DeepSWE 低 36%(−1.5 分),CheckpointBench 低 65%(−0.1 分)。
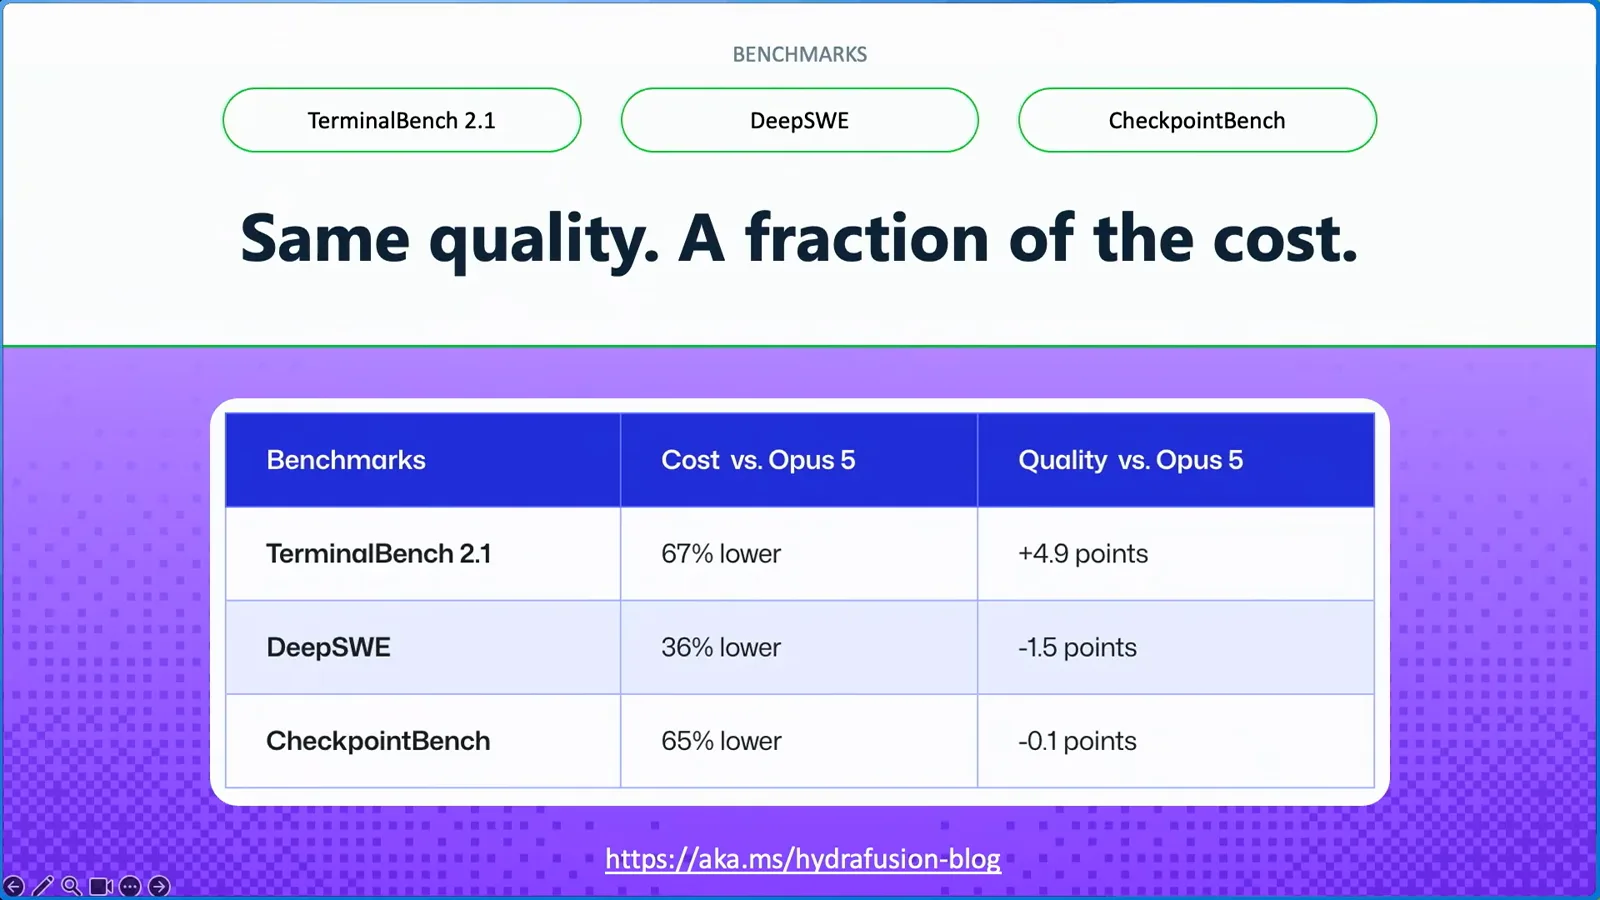
官方演练里的基准表:对比 Opus 5,TerminalBench 2.1 成本低 67%、质量 +4.9 分,DeepSWE 低 36%,CheckpointBench 低 65%。在 10:25 观看
HydraFusion 对 HydraFusion Max
两个条目住在同一个模型选择器里,跑的是同一个路由器——区别只在允许每一轮想多深。GitHub 在 2026-10-14 的 "HydraFusion updates and new Max option" 更新日志里交付了 Max 选项,同一批还带来更新的模型池(Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna)、逐轮推理力度和 Cascade 的评审环节。
- 1标准版 HydraFusion 是均衡模式:以 medium 推理力度起草、以 high 评审,定位是范围清晰的有分量任务——复杂 bug 修复、多文件改动。
- 2HydraFusion Max 增加 extra-high 推理力度——文档的描述是 "tuned for frontier capability on more demanding tasks"(为更吃重的任务调校的前沿能力),用于最深的推理和最透彻的分析。
- 3两者都从同一个选择器里选(HydraFusion 和 HydraFusion Max,都标着 Research Preview),可以用 /model 按会话切换。
- 4Max 会成倍放大 token 消耗:多轮执行加上每轮 extra-high 力度,烧 AI 积分的速度明显快于标准版——而且每一轮仍按其模型的标准费率计费。
- 5两个条目都没有 SLA,预览期内都可能变化,也都不能配合 subagent——Max 是能力旋钮,不是稳定性档位。
- 6实用分工:日常多文件工作交给标准版 HydraFusion,把 Max 留给那种你本来打算丢给最贵单模型的任务;例行 prompt 用纯 Auto——那种活连路由器的溢价都不值。
录下的深潜演示早于 Max,所以那些数字——四个任务共 84.8 AIU,比单干模型低 42–47%——只衡量标准版 HydraFusion。把它们当成 Single 路径的下限:Max 上 critique 为主的任务会落在更高的位置。