
太长不看
- 先跑 /context:系统提示词、工具、MCP server、消息各吃掉多少 token,一目了然,砍之前先看账单。
- 接着干用 /compact,开新活用 /clear;要长期记住的东西写进 CLAUDE.md,别留在对话里。
- 给启动加载瘦身:少挂几个 MCP server,CLAUDE.md 写短点——每个装了的 skill 和 agent 的描述都会进上下文。
- 只要答案的问题丢给 subagent,便宜活交给便宜模型:降 effort,或者让整个 CLI 按 DeepSeek 的价格计费。
Context Management in Claude Code
频道:Claude — official YouTube channel3:31
How to Optimize Token Usage in Claude Code
频道:Greg14:59
Managing context — official Claude Code docs
文档:code.claude.com/docs
7 Ways To Cut Your Claude Code Token Usage In Half
频道:Sean Kochel28:13
How to Reduce Token Usage in Claude Code (2026)
频道:The Code City5:09
画面帧来自官方 context management 演示视频和一份纯净的定价页幻灯片录像;步骤文字以这两支视频和官方「成本与上下文管理」文档为准。
社区事实来源(仅署名,未取帧):Sean Kochel 的《7 Ways To Cut Your Claude Code Token Usage In Half》与 The Code City 的《How to Reduce Token Usage in Claude Code (2026)》。截图版权归原作者所有,均带时间戳深链。
十二步 token 瘦身法
先看清 token 花在哪
- 1
先搞清一个 token 值多少钱
模型按百万 token 计价,输入输出都算钱。你发出的每一个浪费 token——臃肿的系统提示词、重复读取的文件、絮絮叨叨的回答——在 Opus 这个价位上都是真金白银。
Opus 4 输入价 15 美元/百万 token,一个会话浪费几千 token,积少成多。在 1:20 观看 - 2
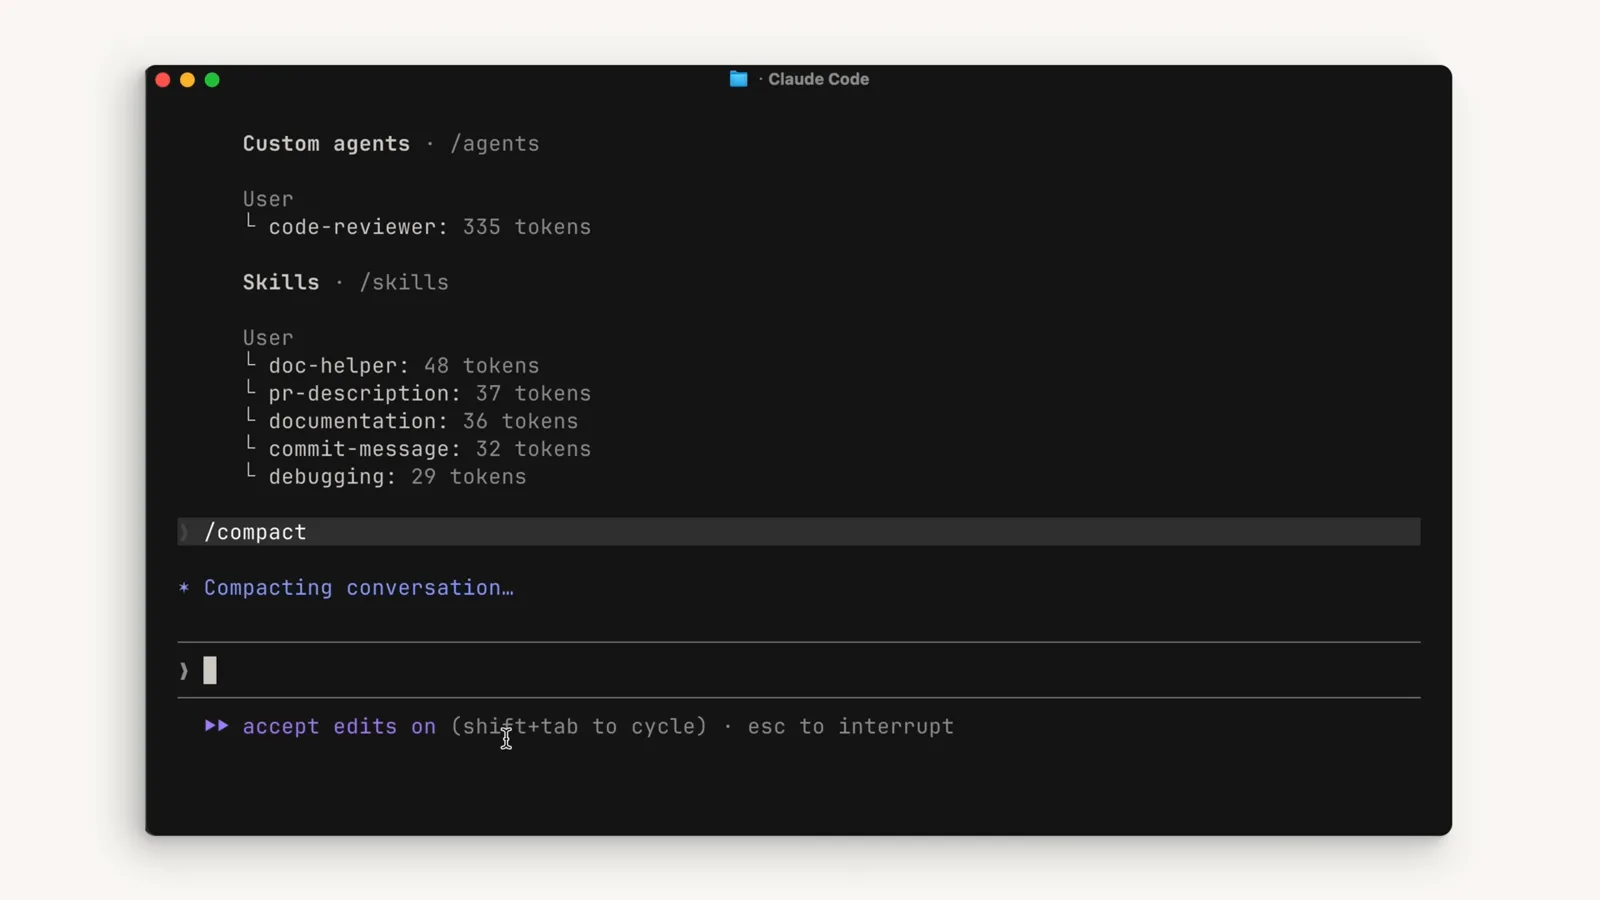
打字之前,先看加载了什么
会话启动时,Claude Code 会把每个已安装 custom agent 和 skill 的名字加描述载入上下文。光这个会话里,code-reviewer 就占 355 token,doc-helper 占 68——这还是你第一句话没说之前。
这份清单上的每个 agent 和 skill,从第一轮起就在收入场费。在 1:00 观看 - 3
打开 /context 仪表盘
输入 /context 看完整分解:系统提示词、系统工具、MCP server、消息各占多少,上下文窗口还剩多少,一眼见底。
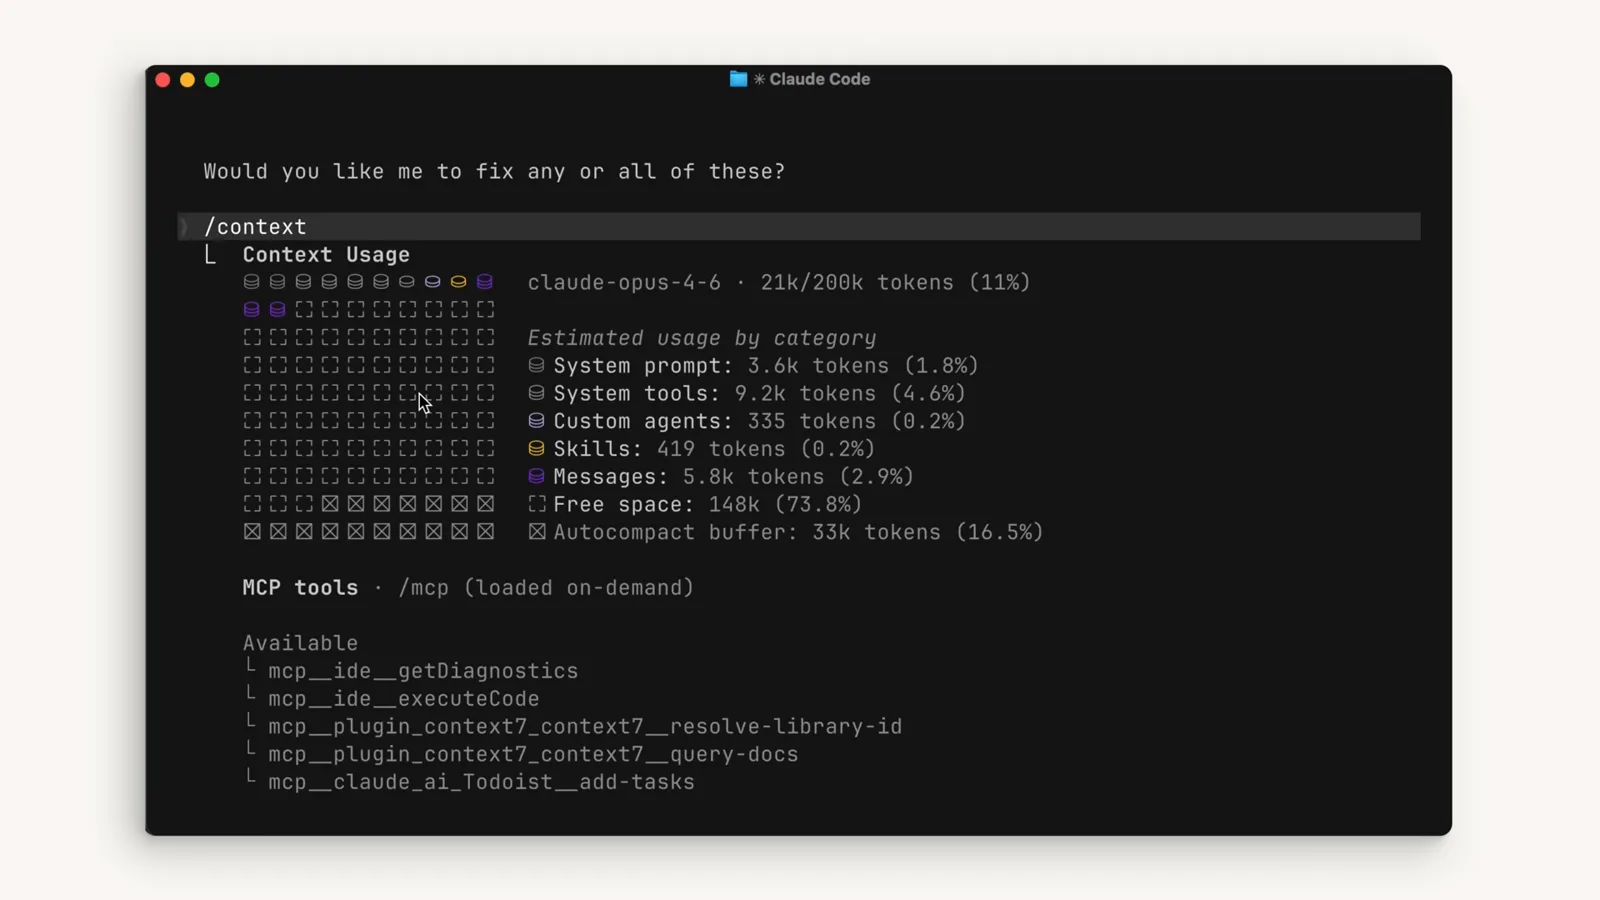
200k 窗口才用了 21k,占 11%——而会话几乎还没开始。在 1:30 观看
砍掉死重
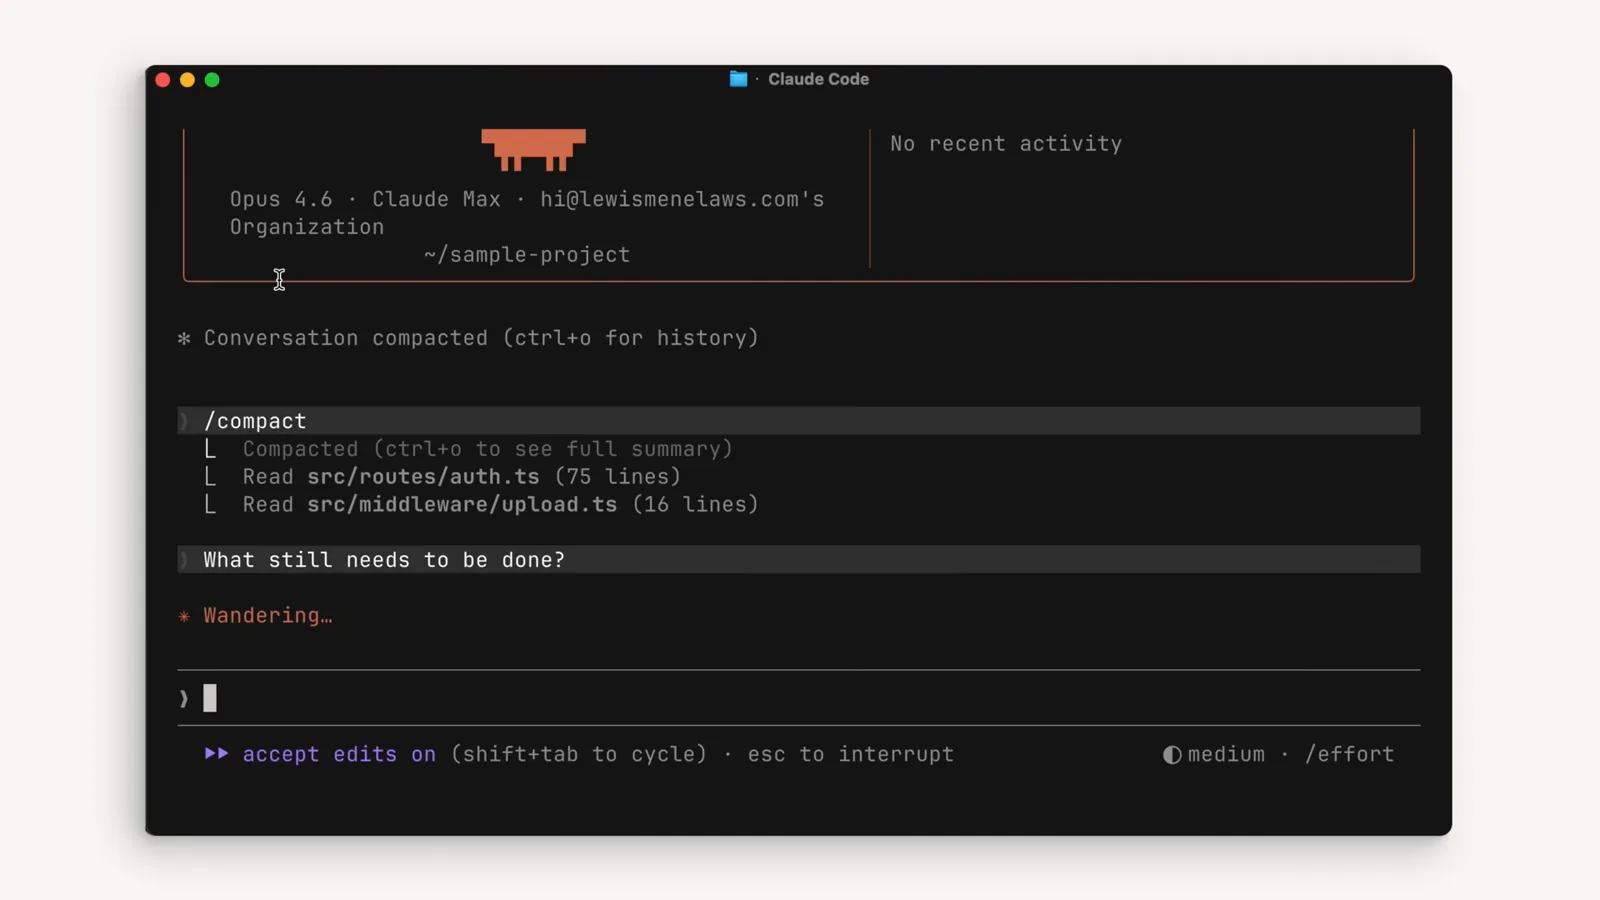
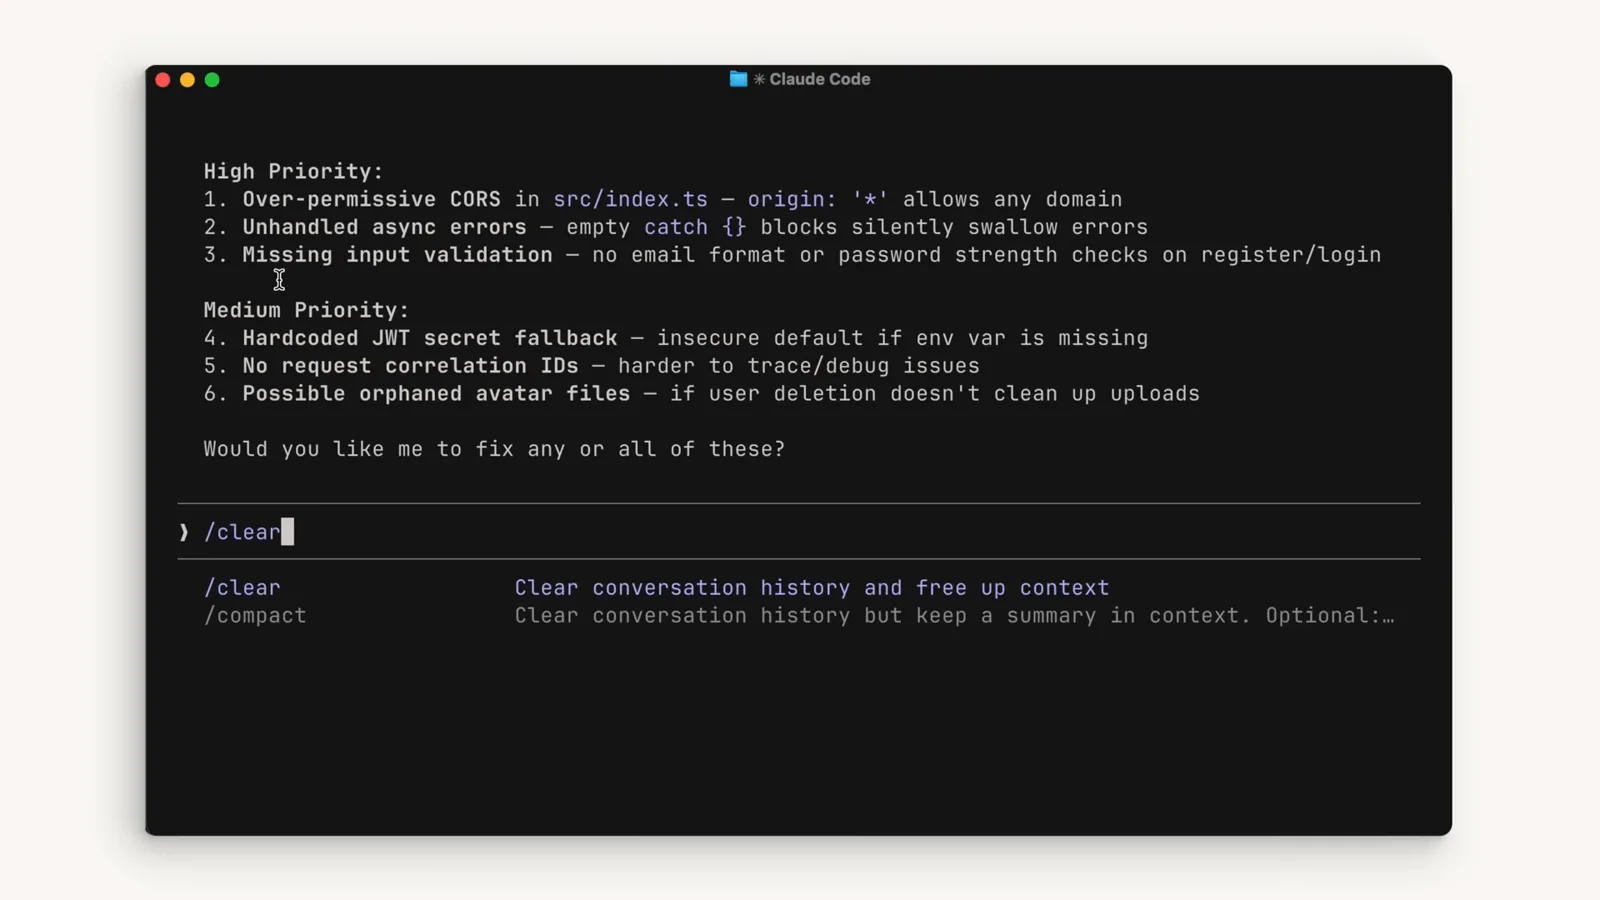
改掉提问习惯
- 7
调研活外包给 subagent
只需要一个答案的问题——比如“鉴权相关的端点在哪个文件”——交给 subagent 去翻,别在主线程里自己探索。
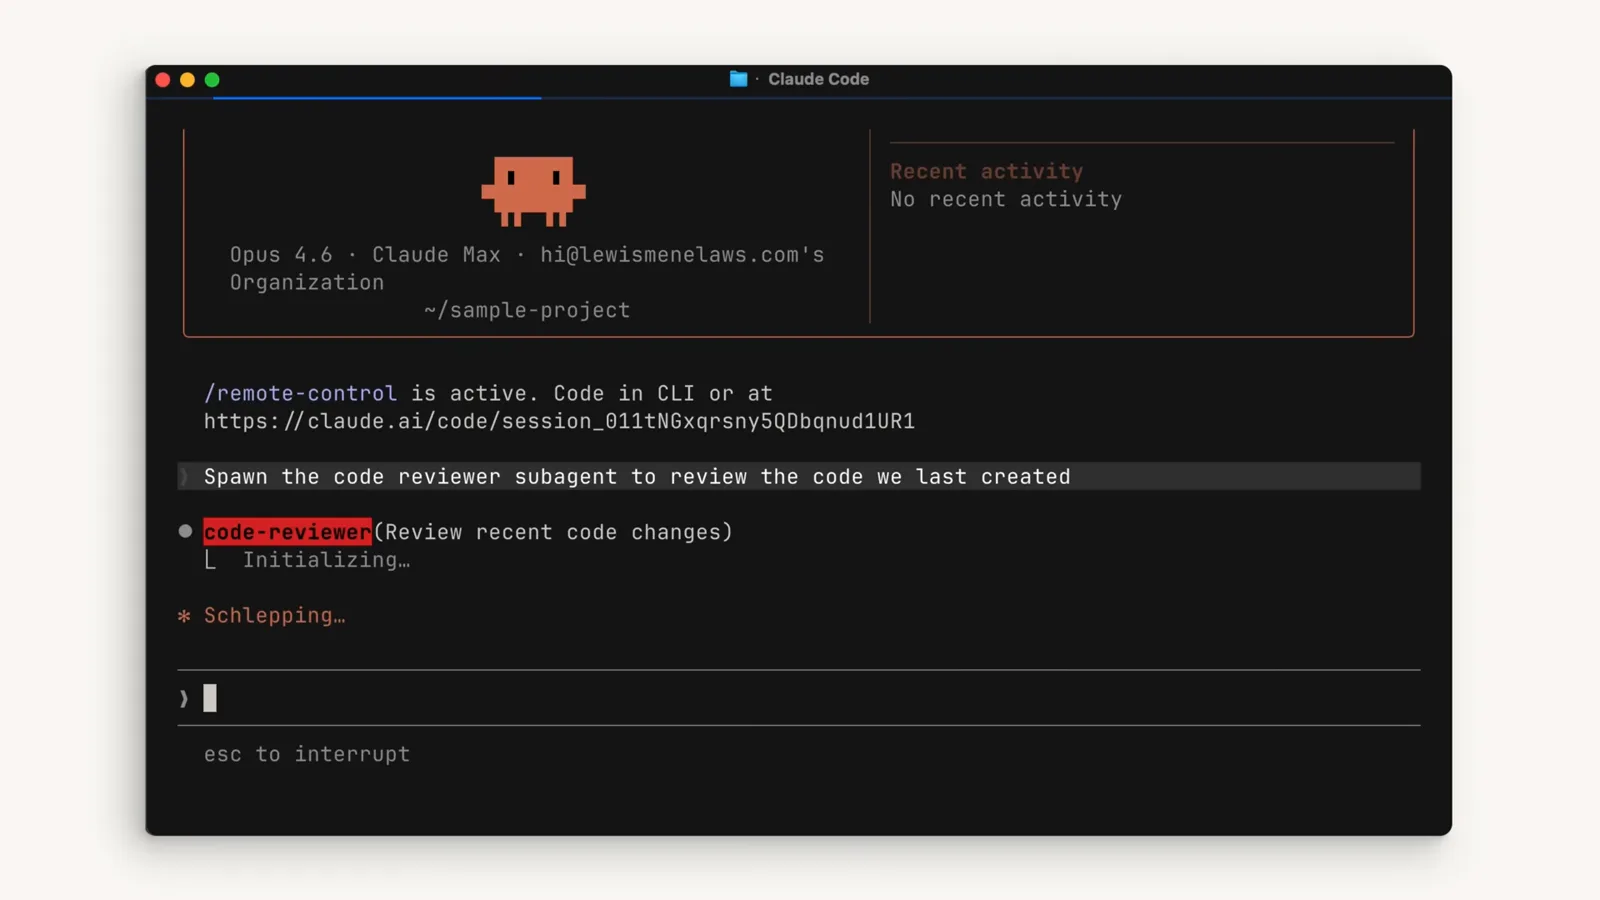
code-reviewer subagent 在后台审代码,git diff 同时在后台跑着。在 2:50 观看 - 8
为什么 subagent 能省 token
subagent 跑在独立隔离的上下文窗口里:它自己读文件、跑 grep、随便翻,只有最终结论会流回你的主线程。
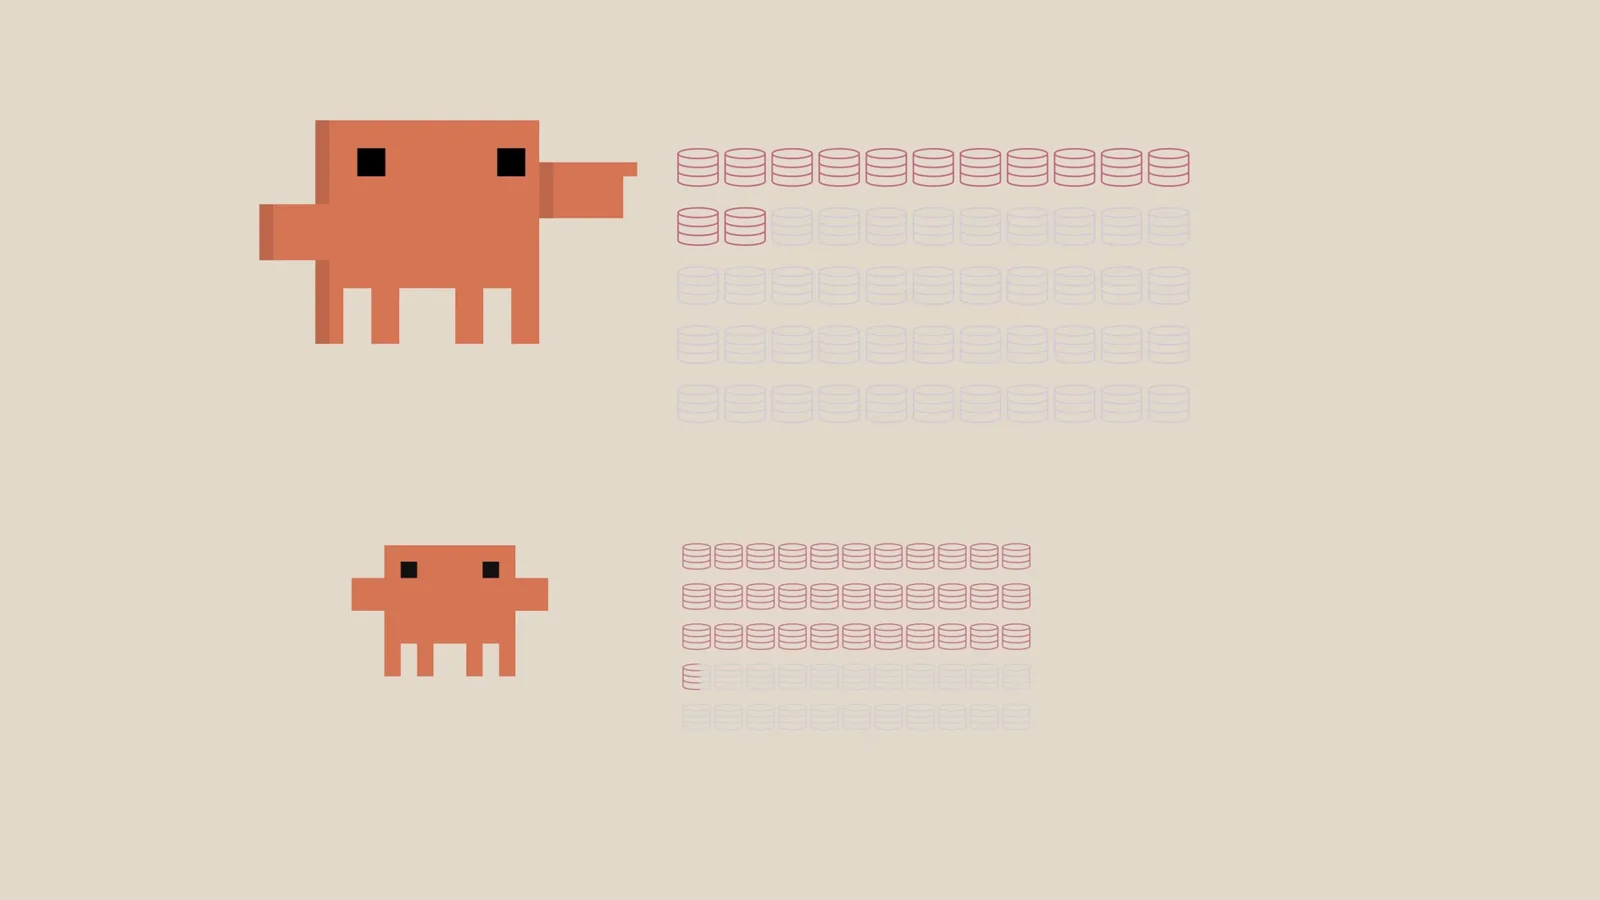
主 agent 和 subagent 各持一份上下文——只有答案会跨回来。在 2:55 观看 - 9
一次把话说清楚
第一条提示词就点名文件和改动范围。模糊的提示会逼着模型在整个代码库里翻箱倒柜,每多一轮探索就多烧一批 token。
管住加载项和回复
- 10
拔掉用不上的 MCP server
每个启用的 MCP server 都会把全部工具定义载入上下文,用不用都占地方。项目用不到的就关掉——轻量需求用 skill 替代,便宜得多。
- 11
给 CLAUDE.md 定瘦身纪律
精简的 CLAUDE.md 只放:项目一句话定位、非显而易见的工具约束、可验证的规则、反模式禁区、指向更深层文档的链接。臃肿的 CLAUDE.md 是每轮对话都在发生的慢性出血。
- 12
让便宜模型干便宜的活
简单任务把 effort 档位调低(见 effort 攻略),或者把整个 CLI 接到 DeepSeek 端点上,让每一条提示词都按 DeepSeek 的价格计费(见 DeepSeek 接入 Claude Code 攻略)。
社区工具与插件:专治 token 大户
内置命令之外,插件市场和几个社区 CLI 也直接瞄准 token 消耗。下面全部来自社区视频实测,不是官方文档——当参考线索看,不当背书。
- 1审计类插件(如 Token Optimizer)会跑一队审计 subagent,盘点你的 skill、MCP server 和 CLAUDE.md 每个会话各花多少——给整套配置拍一张一次性 X 光片。(来源:Sean Kochel 的实测视频。)
- 2输出压缩类 skill(如 Matt Pocock 的 Caveman)砍掉叙述、只留技术干货:README 自称省 75%,Sean Kochel 实测 30-40%——两个数字都值得知道。(来源:Sean Kochel 的实测视频。)
- 3交接类 skill(如 Handoff)把一轮调研的结论打包成交接文档,带进 /clear 之后的新会话,不用让整段探索过程一直占着上下文。(来源:Sean Kochel 的实测视频。)
- 4命令输出代理类 CLI(如 RTK)坐在工具和 Claude 中间,把 git status、git diff 这类啰嗦输出先过滤成关键行,再喂进去变成输入 token。(来源:Sean Kochel 的实测视频。)
- 5目录级嵌套说明工具(如 Intent Layers)自动生成目录级 CLAUDE.md/AGENTS.md,会话只加载当前工作目录那份说明——瞄准的是说明总量超过 2 万 token 的目录。(来源:Sean Kochel 的实测视频。)
提醒一句:这些工具自己也烧 token。审计要跑 subagent,代理层有自己的处理开销。一次性审计值回票价;常驻你的配置里就未必。先跑 /context 看清账,再决定谁留下。