GitHub Copilot HydraFusion : activer l'orchestrateur multi-modèles
Ce qu'est GitHub Copilot HydraFusion (un orchestrateur en aperçu de recherche, pas un modèle), comment l'activer dans Copilot CLI, VS Code et la Copilot app, comment fonctionnent les schémas d'exécution Single, Cascade et Critique, quand HydraFusion Max vaut le coup et ce qu'il facture — le tout sur de vraies captures d'écran.
HydraFusion en un coup d'œil
- HydraFusion est un orchestrateur, pas un modèle : il lit chaque prompt et choisit lui-même le schéma d'exécution, l'effort de raisonnement de chaque passe et les modèles — vous ne choisissez jamais un modèle à la main.
- Trois schémas d'exécution : Single (un modèle fait tout), Cascade (brouillon pas cher → juge → escalade seulement si le contrôle échoue) et Critique (brouillon de pointe → critique pas cher → une révision).
- On l'active en trois gestes : copilot update → copilot --experimental → /model → HydraFusion (Research Preview). VS Code 1.140+ passe par le réglage chat.copilot.hydraFusion.enabled ; la Copilot app a un interrupteur dans Settings → Experimental.
- Facturé par modèle, au tarif standard de ce modèle — aucun frais HydraFusion séparé et la remise de sélection automatique (Auto) ne s'applique pas. /usage affiche les crédits IA par modèle.
- HydraFusion Max (ajouté le 2026-10-14) ajoute un effort de raisonnement extra-haut pour les tâches exigeantes. Les brouillons écartés n'annulent pas automatiquement leurs modifications de fichiers — relisez avant de committer.
Project HydraFusion: Multi-model orchestration in GitHub Copilot
ChaîneGitHub14:27
Using HydraFusion — GitHub Copilot documentation
Docsdocs.github.com
Les images viennent du deep dive Copilot Day de GitHub lui-même et de la bande-annonce officielle Introducing Project HydraFusion — des captures de démo plein écran, sans facecam et sans sous-titres incrustés sur aucune image conservée. Les faits sont recoupés avec la documentation Using HydraFusion et le changelog du 2026-10-14. Les noms de modèles à l'écran montrent le pool du lancement (GPT-5.6 Sol, Claude Opus 5, Fable 5.1) ; le pool a depuis été mis à jour vers Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna.
Les images vidéo restent la propriété de leurs créateurs et sont intégrées ici comme documentation pas-à-pas, avec attribution et liens profonds.
Activez et utilisez HydraFusion étape par étape
Étape 1 — Sachez ce que vous activez
- 1
Comprenez ce qu'est HydraFusion
HydraFusion figure dans le sélecteur de modèles mais n'est pas un modèle — c'est un orchestrateur qui traite chaque prompt comme un problème d'optimisation. Pour chaque requête, il choisit le schéma d'exécution (Single, Cascade ou Critique), un effort de raisonnement pour chaque passe et quels modèles exécutent quelle passe, en s'appuyant sur des signaux de capacité pour le raisonnement, la génération de code, le débogage et l'usage d'outils. Le choix se fait prompt par prompt : deux prompts d'une même session peuvent donc suivre des plans totalement différents — et le routeur lui-même ne génère aucune partie de la réponse.
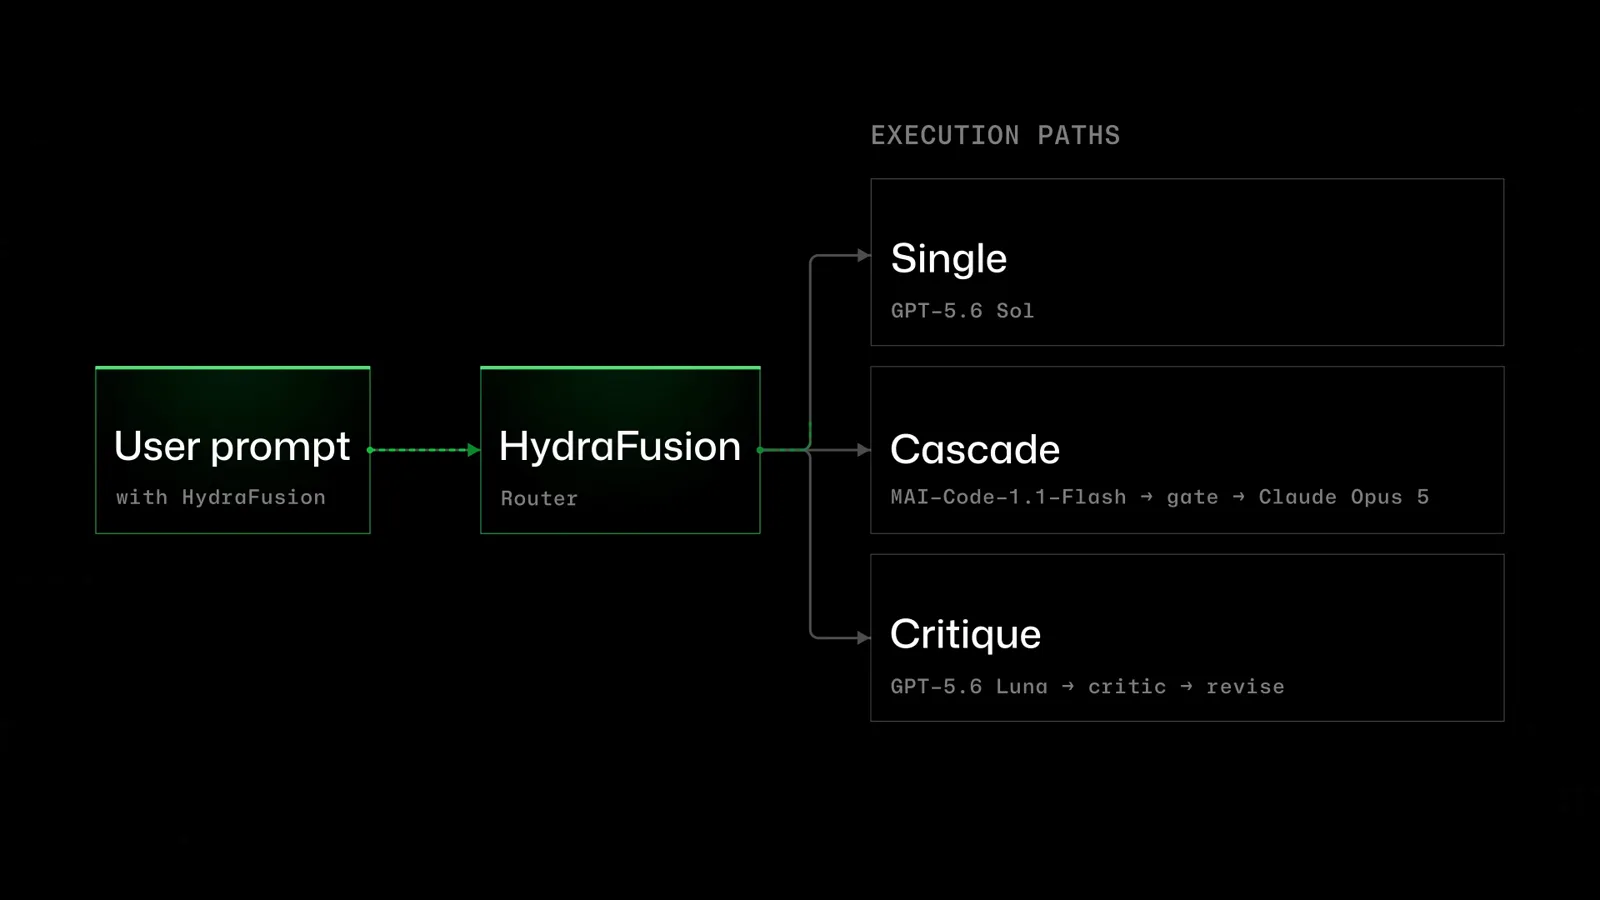
Le schéma des chemins d'exécution de l'animation d'intro de GitHub : un prompt utilisateur routé par le routeur HydraFusion vers Single, Cascade (brouillon → barrière → modèle plus fort) et Critique (brouillon → critique → révision).Voir à 0:42 - 2
Vérifiez que vous pouvez réellement l'obtenir
HydraFusion est un aperçu de recherche : pas de SLA, pas pour des charges de production, susceptible de changer. Il arrive sur trois surfaces — Copilot CLI, VS Code 1.140+ (ou Insiders) et la GitHub Copilot app. Un verrou piège beaucoup de monde : le sélecteur ne propose HydraFusion que si votre plan et les politiques de modèles de votre organisation autorisent au moins certains des modèles de son pool. Si aucun modèle autorisé ne remplit les conditions, l'entrée n'apparaît jamais, sans prévenir — et dans les environnements d'entreprise gérés, un admin doit d'abord activer les fonctionnalités d'aperçu.
- 3
Mettez d'abord Copilot CLI à jour
Lancez copilot update avant tout — l'entrée HydraFusion est un ajout récent et les builds plus anciens ne la listent pas. Si /model ne montre toujours rien après l'étape suivante, /update prerelease fait passer la CLI sur le canal prerelease, où l'aperçu arrive en premier. VS Code exige 1.140 ou plus (ou Insiders) ; la Copilot app a juste besoin de son build le plus récent.
Étape 2 — Activez-le et envoyez votre premier prompt
- 4
Activez les fonctionnalités expérimentales
HydraFusion se cache derrière le flag expérimental. Pour un lancement ponctuel, passez-le inline : copilot --experimental --model hydrafusion -p "YOUR-PROMPT". Pour l'avoir à chaque session, lancez /experimental on et redémarrez la CLI. Dans VS Code, activez le réglage chat.copilot.hydraFusion.enabled ; dans la Copilot app, basculez Settings → Experimental → HydraFusion.
- 5
Choisissez HydraFusion dans le sélecteur de modèles
Ouvrez /model et choisissez HydraFusion (Research Preview) — il se liste comme un modèle alors qu'il n'en est pas un. Lisez les deux lignes qu'affiche le sélecteur avant de continuer : « HydraFusion routes the first eligible turn and may use multiple models. Premium usage varies with the selected route. » Le changement ne vaut que pour la session en cours ; /config model le rend par défaut pour les sessions suivantes.
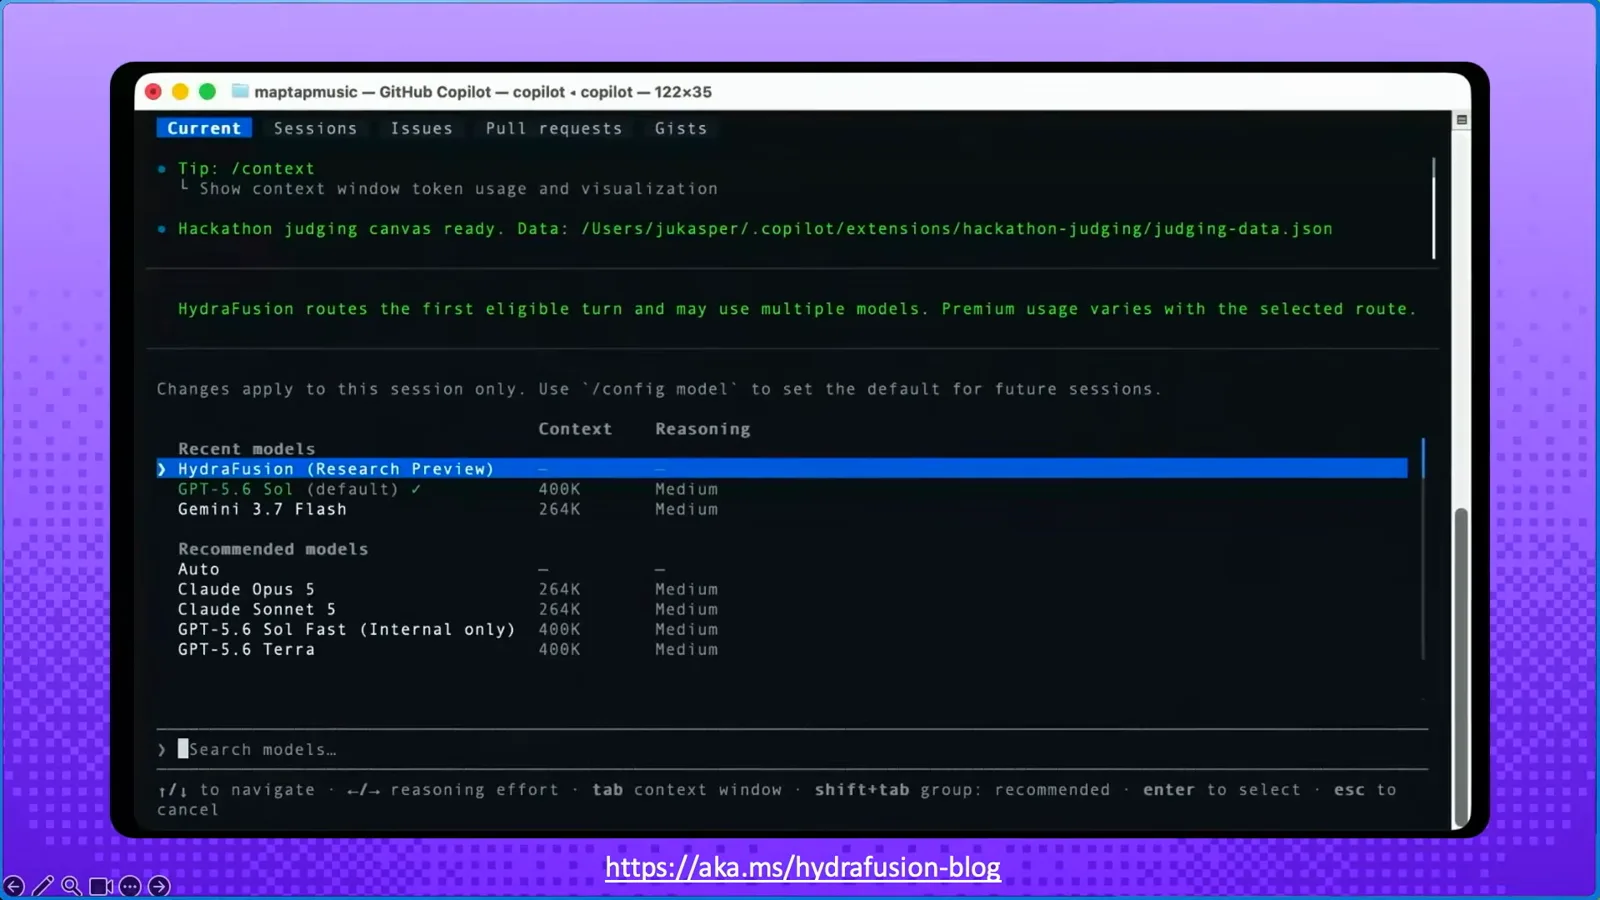
Le sélecteur de modèles de Copilot CLI avec HydraFusion (Research Preview) en surbrillance sous Recent models, au-dessus du pool du lancement : GPT-5.6 Sol (défaut), Gemini 3.7 Flash, Claude Opus 5, Claude Sonnet 5 et GPT-5.6 Terra.Voir à 1:00 - 6
Envoyez un prompt et regardez le plan se former
Envoyez une vraie tâche et la vue de progression montre ce que le routeur a décidé : le schéma choisi, le statut de chaque passe, l'activité en cours et le temps écoulé — « Fusion · selecting an approach… », « Fusion · drafting… », « Fusion · checking… », « Fusion · preparing final response… ». Appuyez sur Esc pour interrompre une exécution ; un résumé reste ensuite dans la conversation. Dans VS Code et l'app, survolez le pied de la réponse pour voir quels modèles ont été utilisés.
Étape 3 — Lisez les trois chemins d'exécution
- 7
Lisez un plan SINGLE : un modèle a suffi
Sur la tâche des type hints et docstrings, le routeur a choisi SINGLE : une passe SOLVE avec gpt-5.6-sol — pas de second modèle, pas d'étape de relecture. La CLI a mesuré toute la tâche à 5,3 AIU quand l'Opus 5 solo brûlait 32,1 et le Fable 5.1 solo 20,3 sur le même prompt. SINGLE, c'est ce que vous obtenez sur du travail bien cadré : le routeur ne paie pas une relecture dont il n'a pas besoin.
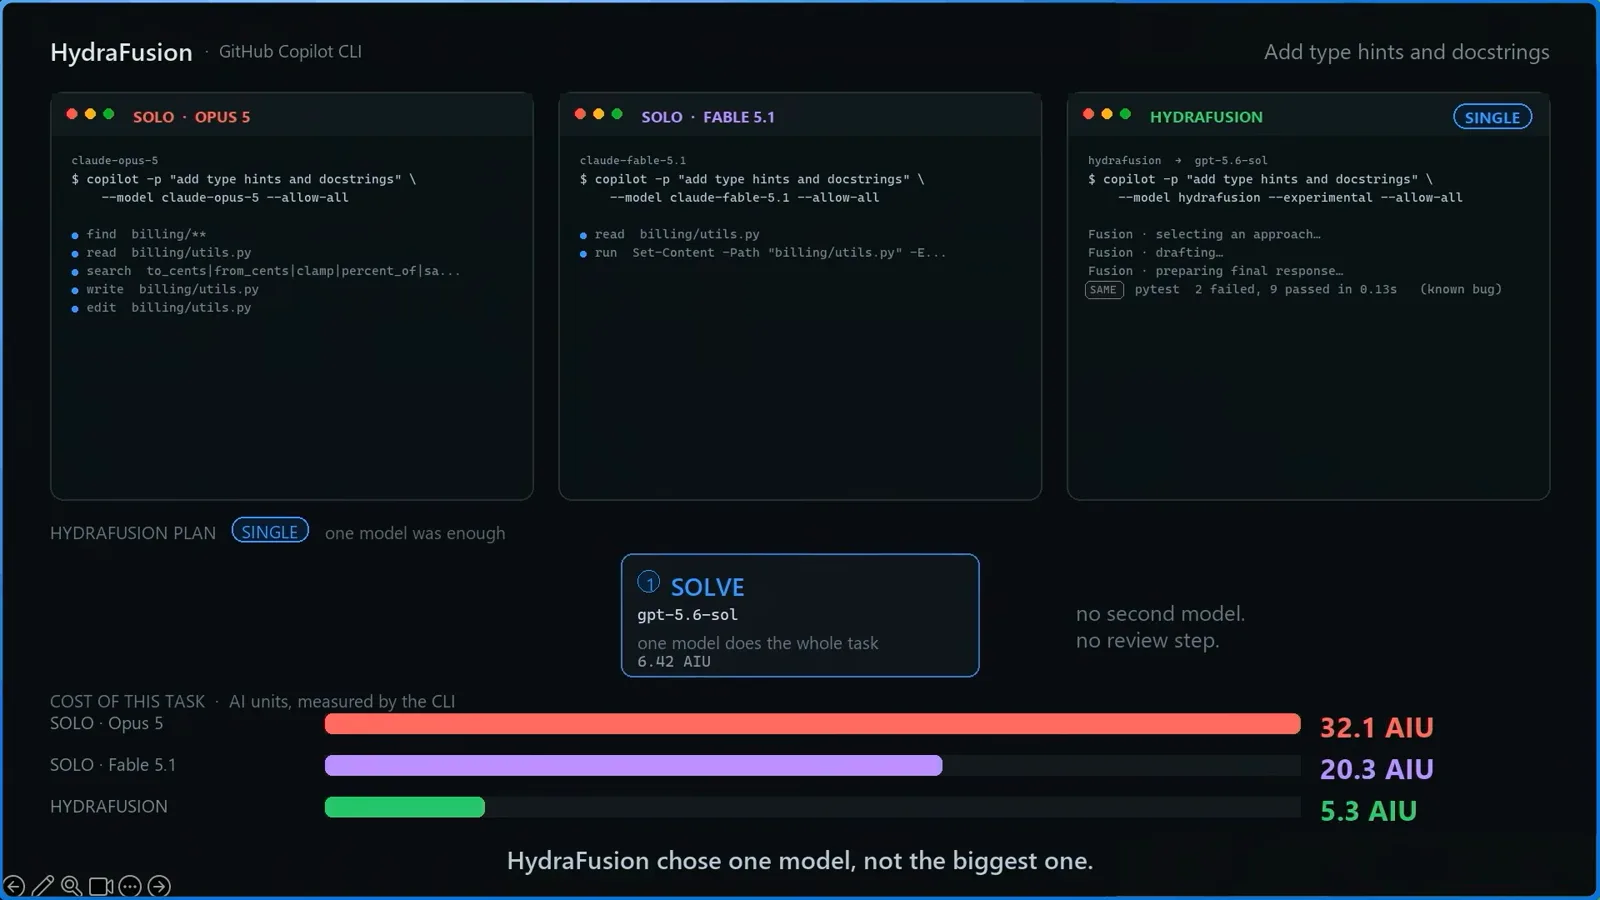
La carte du plan SINGLE — SOLVE avec gpt-5.6-sol, « one model does the whole task » — à côté des barres de coûts : HydraFusion 5,3 AIU contre l'Opus 5 solo à 32,1 et le Fable 5.1 solo à 20,3 sur la même tâche de type hints.Voir à 6:40 - 8
Lisez un plan CASCADE : brouillon pas cher, escalade seulement en cas d'échec
Sur « fix the failing retry tests », le routeur a lancé CASCADE : gpt-5.6-luna a rédigé pour 0,86 AIU, un juge gpt-5.6-sol a noté la tentative pour 0,22 et affiché « verdict: reject », puis gpt-5.6-sol a refait le travail pour 5,25 — après quoi la suite est passée au vert (pytest 11 passed). Total : 5,5 AIU contre 27,2 pour l'Opus 5 solo. Cascade ne paie le prix de l'escalade que quand le brouillon pas cher échoue réellement au contrôle.
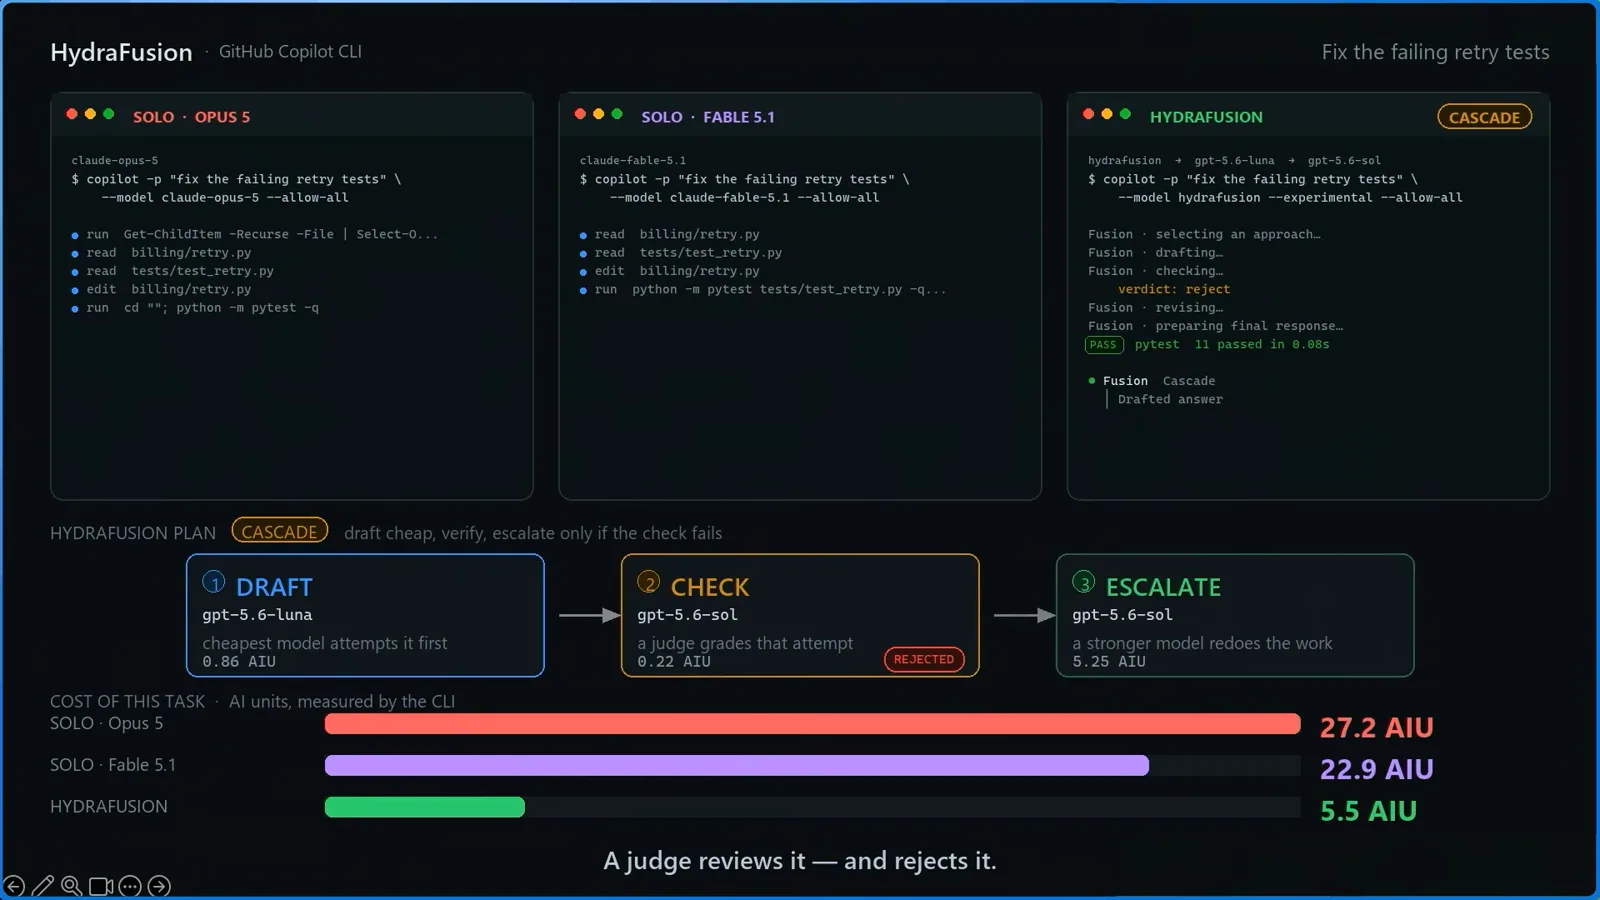
La chaîne CASCADE sur la tâche des tests de retry : DRAFT gpt-5.6-luna (0,86 AIU) → juge CHECK (0,22 AIU) marqué REJECTED → ESCALATE gpt-5.6-sol (5,25 AIU), les barres de la tâche totalisant 5,5 AIU.Voir à 7:40 - 9
Lisez un plan CRITIQUE : payez un second modèle pour relire
Sur la migration de l'endpoint de facturation — rayon d'impact élevé — le routeur a choisi CRITIQUE : claude-opus-5 a rédigé (47,16 AIU), gpt-5.6-sol a audité le brouillon pour 0,60 et l'a marqué SENT BACK, puis claude-opus-5 a retravaillé une fois pour 15,86 jusqu'à ce que la suite passe. Critique est le schéma coûteux — 60,7 AIU ici, plus que les 39,9 de l'Opus 5 solo — et c'est ce que le routeur réserve aux travaux où un merge erroné coûte plus cher que la relecture.
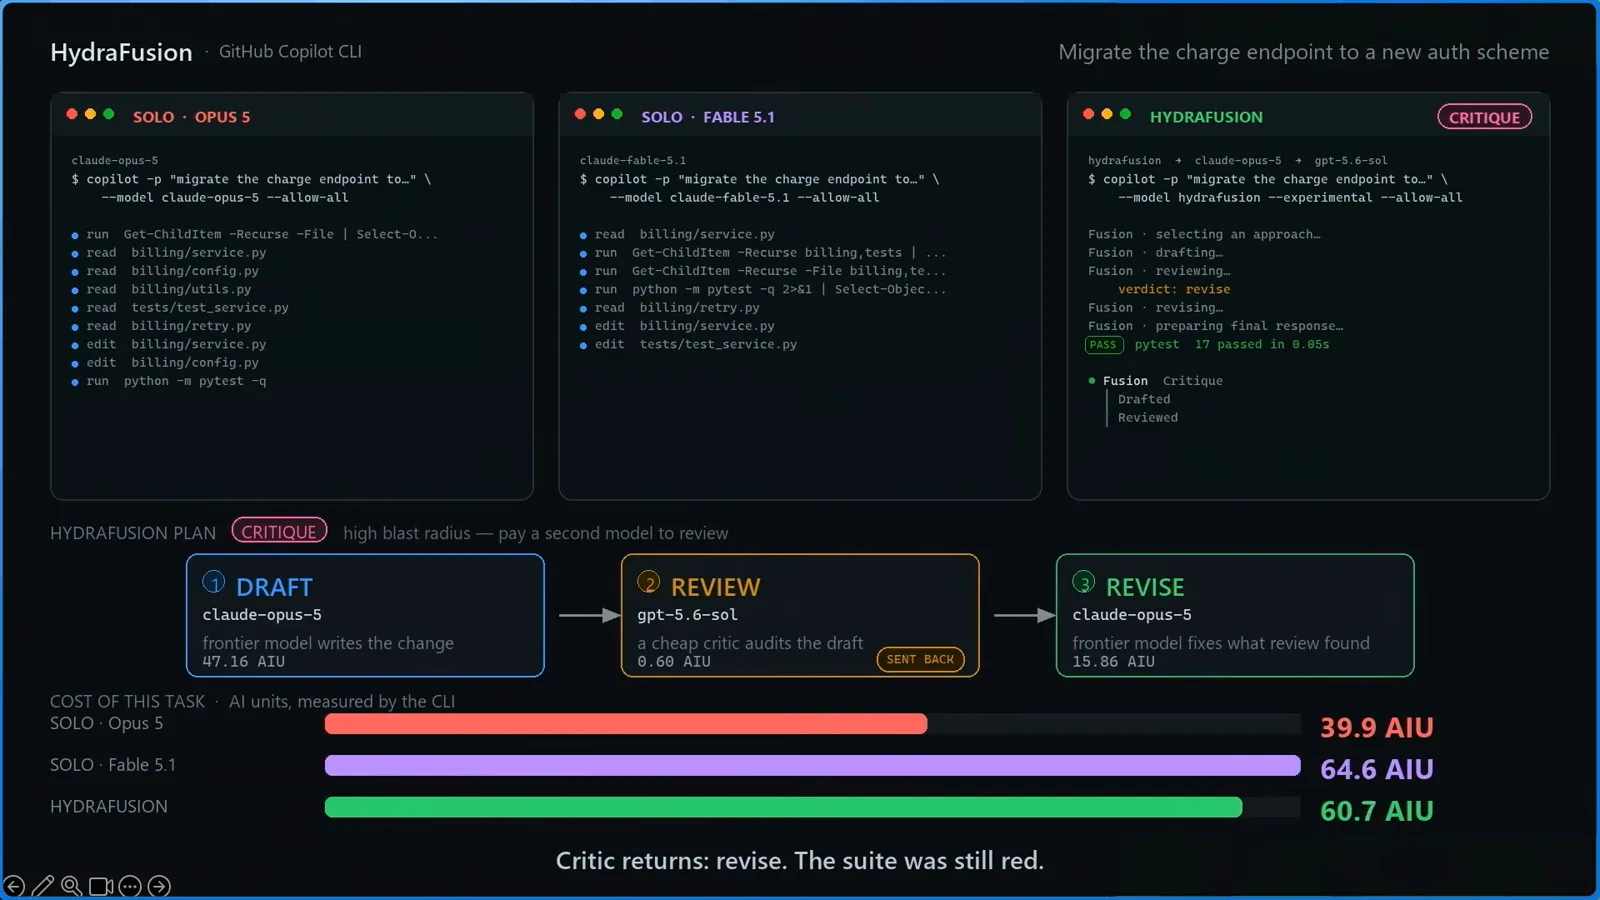
La chaîne CRITIQUE sur la tâche de migration d'endpoint : DRAFT claude-opus-5 → REVIEW gpt-5.6-sol (SENT BACK) → REVISE claude-opus-5, au total 60,7 AIU contre l'Opus 5 solo à 39,9 et le Fable 5.1 solo à 64,6.Voir à 8:20
Étape 4 — Max, facturation et sorties propres
- 10
Passez à HydraFusion Max pour les tâches exigeantes
Le changelog du 2026-10-14 a ajouté une seconde entrée au sélecteur : HydraFusion Max. Le HydraFusion standard rédige à effort de raisonnement moyen et relit à effort haut, positionné pour du travail substantiel bien cadré — corrections de bugs complexes, changements multi-fichiers. Max ajoute un effort de raisonnement extra-haut et est calibré pour la capacité de pointe sur les tâches les plus exigeantes. On le choisit dans la même liste /model ; tout le reste du flux est identique.
- 11
Auditez la facture avec /usage
HydraFusion facture par modèle, au tarif standard de ce modèle — aucun frais HydraFusion séparé, et la remise de sélection automatique (Auto) ne s'applique pas. Lancez /usage dans la CLI pour voir les crédits IA par modèle. Dans l'exécution enregistrée de quatre tâches, les totaux ont été de 84,8 AIU pour HydraFusion contre 146,5 pour l'Opus 5 solo et 159,0 pour le Fable 5.1 solo — 42 % et 47 % moins cher — mais la tâche riche en critique a coûté 63,6 à elle seule ; le mélange de routes pilote la facture.
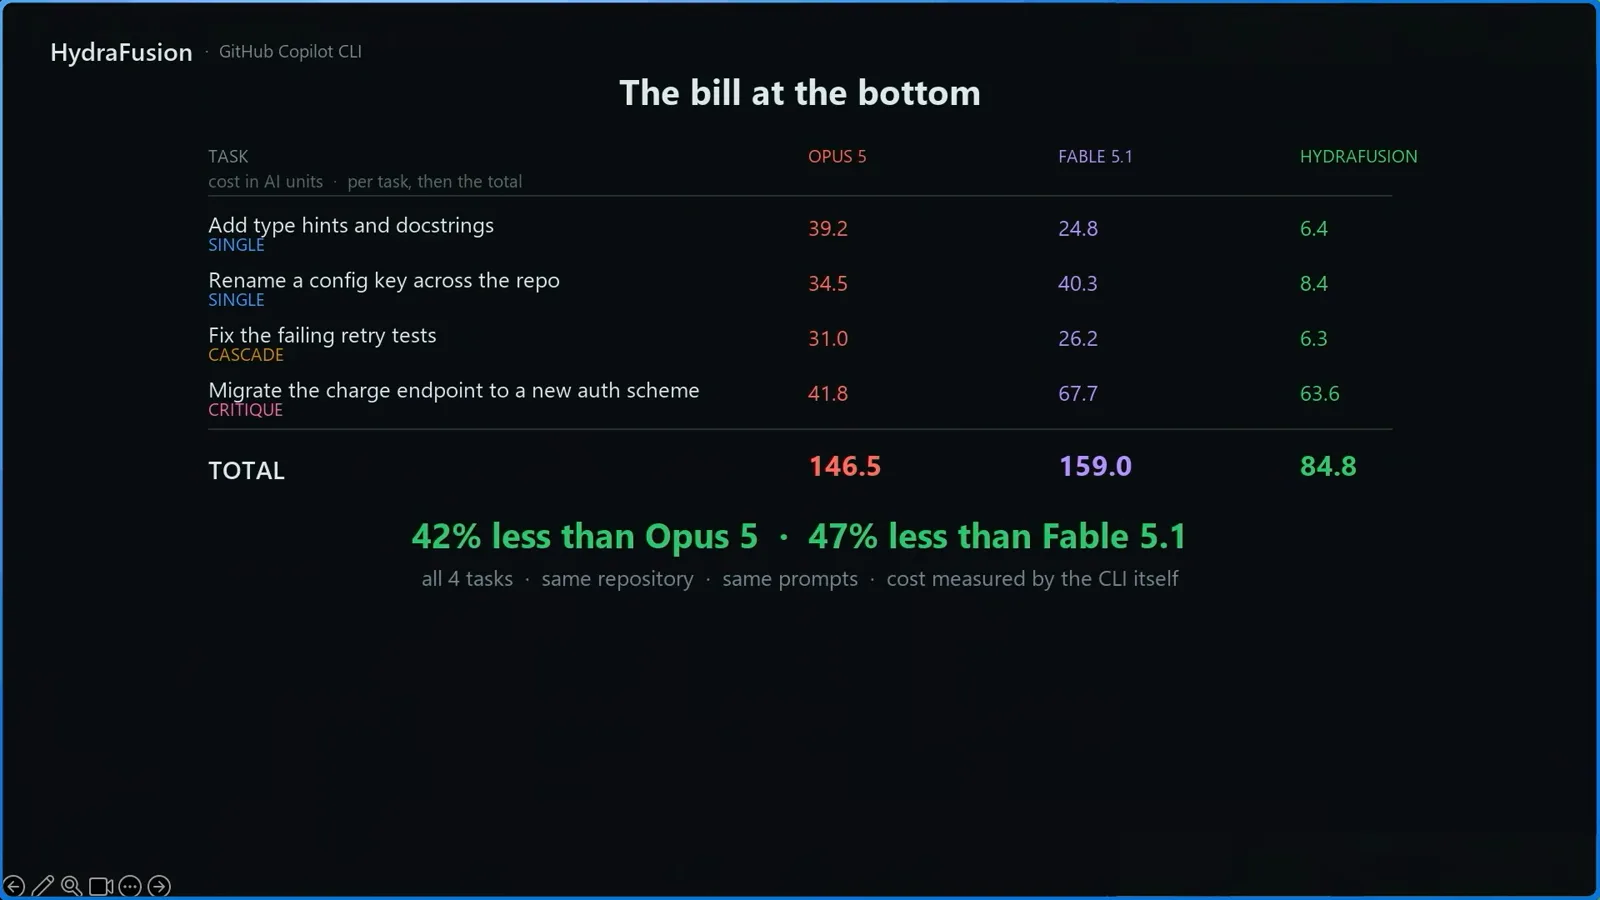
La diapositive « The bill at the bottom » : AIU par tâche pour les quatre tâches de la démo et les totaux — HydraFusion 84,8 contre l'Opus 5 solo à 146,5 et le Fable 5.1 solo à 159,0, 42 % et 47 % moins cher.Voir à 9:00 - 12
Relisez les brouillons écartés avant de committer
Deux limites de l'aperçu à intégrer à vos habitudes. D'abord, si une passe est écartée — un brouillon Cascade que le juge rejette, une passe Critique renvoyée —, les modifications déjà apportées au workspace ne sont pas annulées automatiquement : faites un diff et relisez avant de committer. Ensuite, HydraFusion ne fonctionne ni avec les sous-agents ni n'en lance. Pour les prompts de routine, le simple Auto reste le défaut pas cher ; les benchmarks officiels annoncent TerminalBench 2.1 à 67 % de coût en moins plus 4,9 points de qualité, DeepSWE 36 % de moins (−1,5 point) et CheckpointBench 65 % de moins (−0,1 point) face à Opus 5.
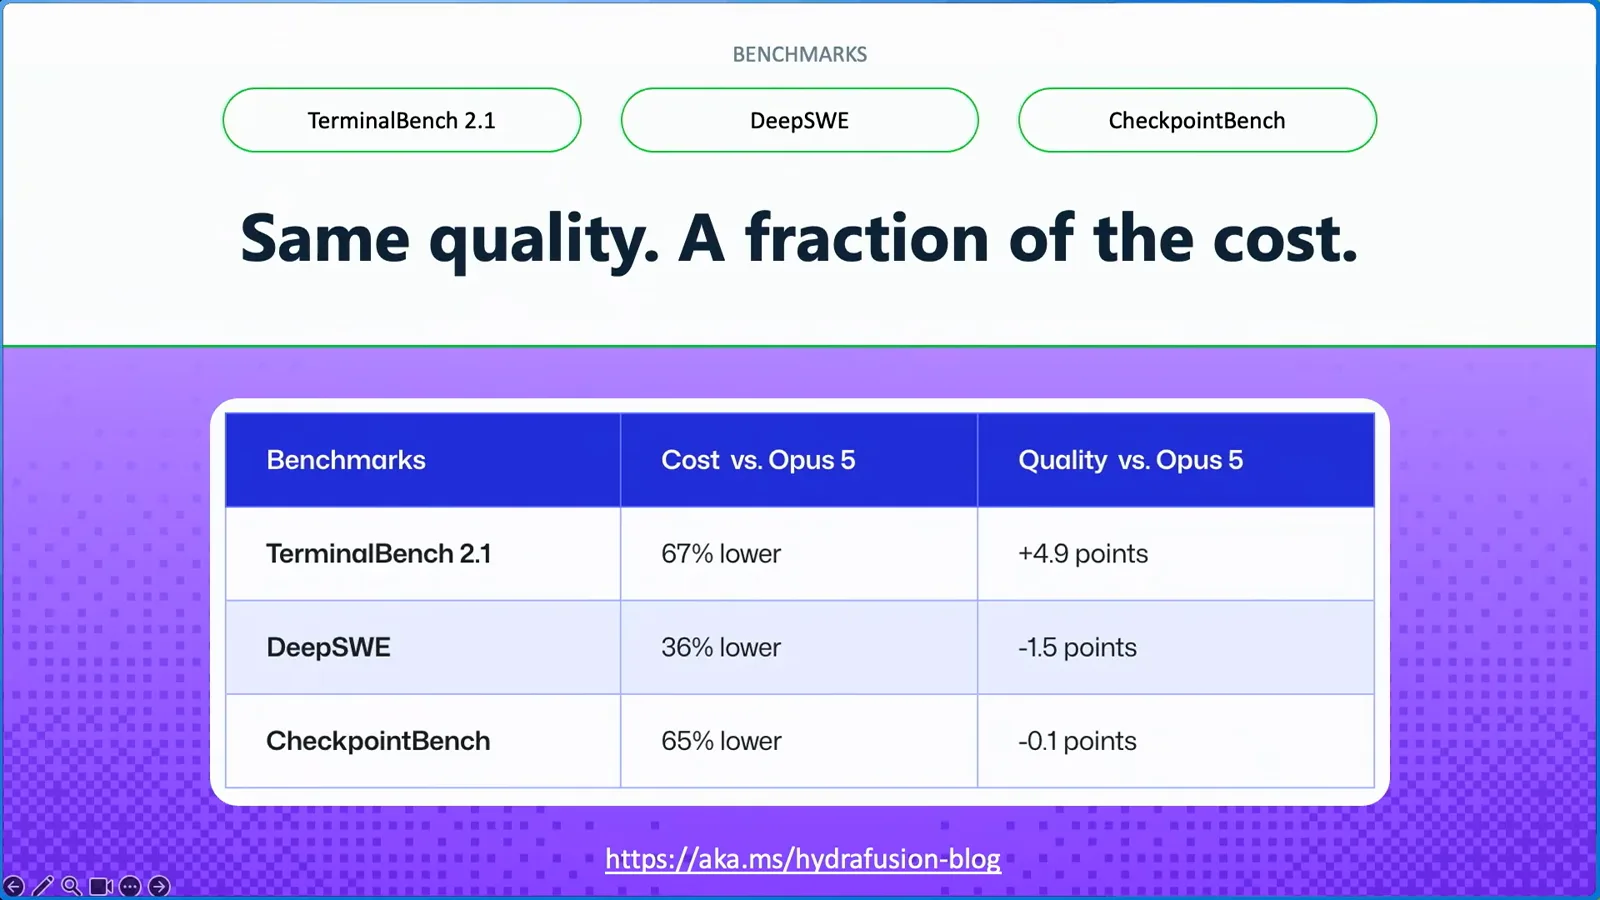
Le tableau de benchmarks du parcours officiel : TerminalBench 2.1 à 67 % de coût en moins avec +4,9 points de qualité face à Opus 5, DeepSWE 36 % de moins, CheckpointBench 65 % de moins.Voir à 10:25
HydraFusion vs HydraFusion Max
Les deux entrées vivent dans le même sélecteur de modèles et font tourner le même routeur — la différence est l'effort de réflexion autorisé à chaque passe. GitHub a livré l'option Max dans le changelog du 2026-10-14 (« HydraFusion updates and new Max option ») en même temps que le pool de modèles actualisé (Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna), l'effort de raisonnement par étape et l'étape de jugement de Cascade.
- 1Le HydraFusion standard est le mode équilibré : les brouillons tournent à effort de raisonnement moyen et les relectures à effort haut, positionné pour des tâches substantielles bien cadrées comme les corrections de bugs complexes et les changements multi-fichiers.
- 2HydraFusion Max ajoute un effort de raisonnement extra-haut — la documentation le décrit comme « tuned for frontier capability on more demanding tasks », pour le raisonnement le plus profond et l'analyse la plus poussée.
- 3Les deux se choisissent dans le même sélecteur (HydraFusion et HydraFusion Max, tous deux étiquetés Research Preview), et vous pouvez passer de l'un à l'autre par session avec /model.
- 4Max multiplie la combustion de tokens : l'exécution multi-passes plus l'effort extra-haut par passe consomme les crédits IA sensiblement plus vite que le standard — et chaque passe continue d'être facturée au tarif standard de son modèle.
- 5Aucune des deux entrées n'a de SLA, les deux peuvent changer pendant l'aperçu, et aucune ne fonctionne avec les sous-agents — Max est un bouton de capacité, pas un palier de stabilité.
- 6Répartition pratique : gardez le HydraFusion standard pour le travail multi-fichiers quotidien, réservez Max à la tâche que vous auriez sinon confiée au modèle solo le plus cher, et utilisez le simple Auto pour les prompts de routine où même le routeur ne vaut pas la prime.
Le deep dive enregistré est antérieur à Max, donc ses chiffres — 84,8 AIU sur quatre tâches, 42–47 % sous les modèles solo — ne mesurent que le HydraFusion standard. Prenez-les comme le plancher de la route Single : les tâches riches en critique sous Max atterriront plus haut.