GitHub Copilot HydraFusion: activa el orquestador multi-modelo
Qué es GitHub Copilot HydraFusion (un orquestador en vista previa de investigación, no un modelo), cómo activarlo en Copilot CLI, VS Code y la Copilot app, cómo funcionan los patrones de ejecución Single, Cascade y Critique, cuándo compensa HydraFusion Max y qué factura — todo en grabaciones de pantalla reales.
HydraFusion de un vistazo
- HydraFusion es un orquestador, no un modelo: lee cada prompt y elige por sí solo el patrón de ejecución, el esfuerzo de razonamiento de cada pasada y los modelos — tú nunca eliges un modelo a mano.
- Tres patrones de ejecución: Single (un modelo hace todo), Cascade (borrador barato → juez → escalar solo si falla la comprobación) y Critique (borrador frontera → crítico barato → una revisión).
- Se activa en tres movimientos: copilot update → copilot --experimental → /model → HydraFusion (Research Preview). VS Code 1.140+ usa el ajuste chat.copilot.hydraFusion.enabled; la Copilot app tiene un interruptor en Settings → Experimental.
- Se factura por modelo, a la tarifa estándar de ese modelo — no hay cargo separado de HydraFusion y el descuento de selección automática (Auto) no aplica. /usage muestra los créditos de IA por modelo.
- HydraFusion Max (añadido el 2026-10-14) añade un esfuerzo de razonamiento extra alto para tareas exigentes. Los borradores descartados no deshacen solos sus ediciones de archivos — revisa antes de hacer commit.
Project HydraFusion: Multi-model orchestration in GitHub Copilot
CanalGitHub14:27
Using HydraFusion — GitHub Copilot documentation
Docsdocs.github.com
Los fotogramas vienen del deep dive de Copilot Day del propio GitHub y del tráiler oficial Introducing Project HydraFusion — capturas de demo a pantalla completa, sin cámara y sin subtítulos incrustados en ningún fotograma conservado. Los datos se contrastan con la documentación de Using HydraFusion y el changelog del 2026-10-14. Los nombres de modelo en pantalla muestran el pool del lanzamiento (GPT-5.6 Sol, Claude Opus 5, Fable 5.1); el pool se ha actualizado desde entonces a Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna.
Los fotogramas del vídeo siguen siendo propiedad de sus creadores y se incrustan aquí como documentación paso a paso, con atribución y enlaces profundos.
Activa y usa HydraFusion paso a paso
Paso 1 — Sabe qué estás activando
- 1
Entiende qué es HydraFusion
HydraFusion aparece en el selector de modelos pero no es un modelo — es un orquestador que trata cada prompt como un problema de optimización. Para cada petición elige el patrón de ejecución (Single, Cascade o Critique), un esfuerzo de razonamiento para cada pasada y qué modelos ejecutan cada pasada, usando señales de capacidad para razonamiento, generación de código, depuración y uso de herramientas. La elección es por prompt, así que dos prompts de una sesión pueden correr planes totalmente distintos — y el router no genera ninguna parte de la respuesta.
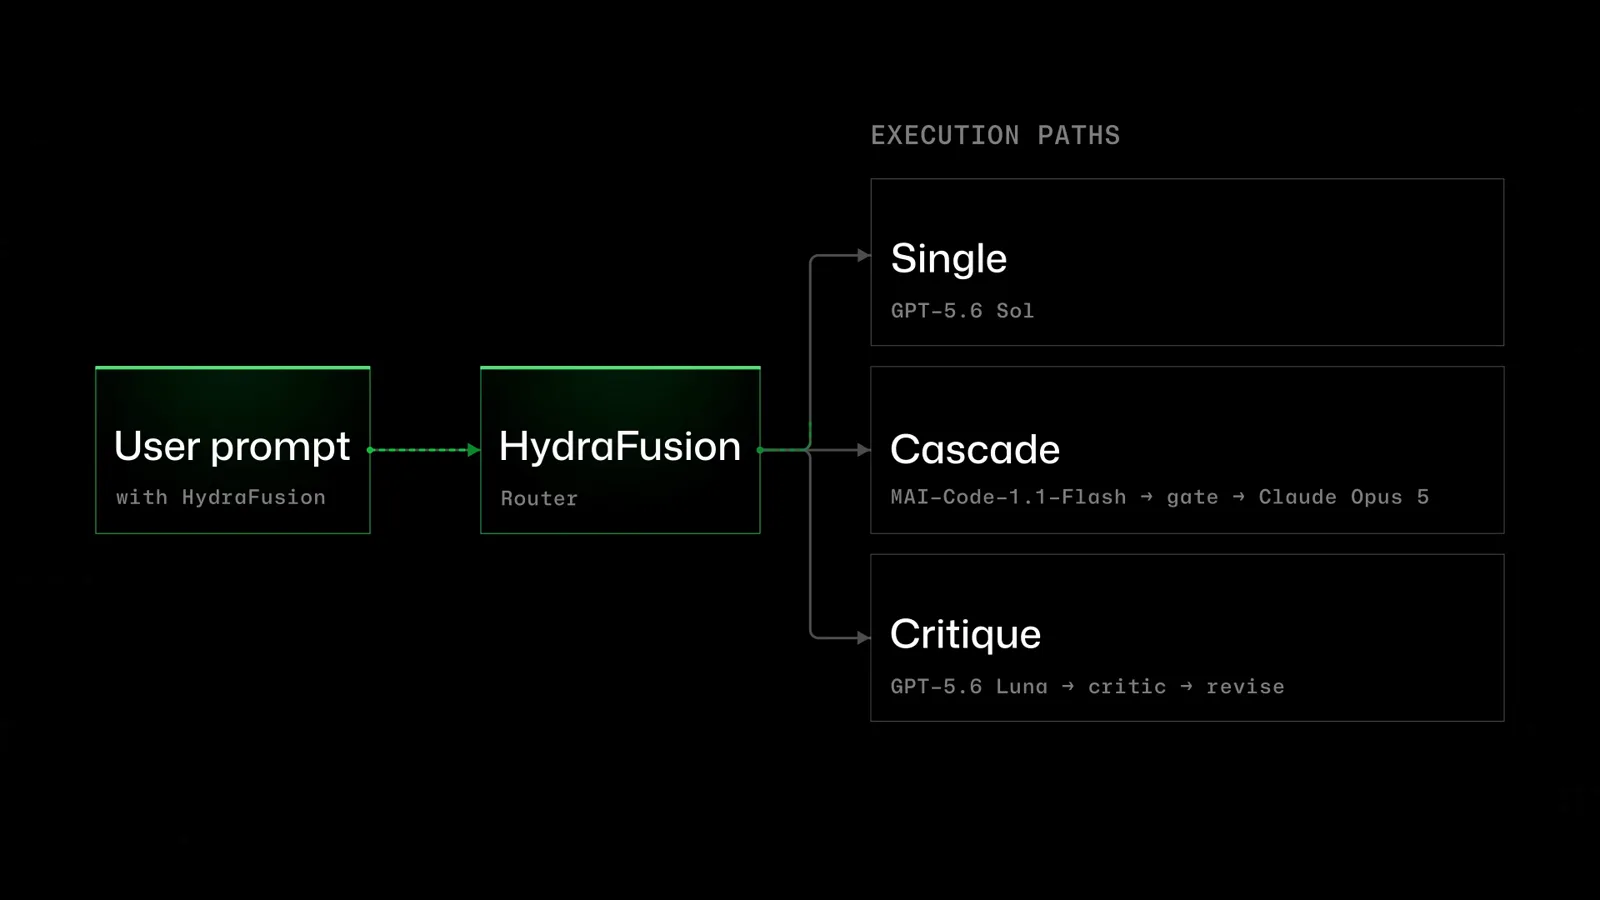
El diagrama de rutas de ejecución de la animación de intro de GitHub: un prompt del usuario enrutado por el router de HydraFusion hacia Single, Cascade (borrador → puerta → modelo más fuerte) y Critique (borrador → crítico → revisión).Ver en 0:42 - 2
Comprueba que de verdad puedes tenerlo
HydraFusion es una vista previa de investigación: sin SLA, no para cargas de producción, sujeto a cambios. Llega en tres superficies — Copilot CLI, VS Code 1.140+ (o Insiders) y la GitHub Copilot app. Una trampa despista a mucha gente: el selector solo ofrece HydraFusion cuando tu plan y las políticas de modelos de tu organización permiten al menos algunos de los modelos de su pool. Si ningún modelo permitido cualifica, la entrada nunca aparece, sin previo aviso — y en entornos empresariales gestionados un admin debe activar antes las funciones de vista previa.
- 3
Actualiza primero Copilot CLI
Ejecuta copilot update antes que nada — la entrada de HydraFusion es una incorporación reciente y los builds antiguos no la listan. Si tras el siguiente paso /model sigue sin mostrar nada, /update prerelease pasa la CLI al canal prerelease, donde la vista previa llega antes. VS Code necesita 1.140 o superior (o Insiders); la Copilot app solo necesita su build más reciente.
Paso 2 — Actívalo y manda tu primer prompt
- 4
Enciende las funciones experimentales
HydraFusion se esconde tras el flag experimental. Para una ejecución puntual, pásalo inline: copilot --experimental --model hydrafusion -p "YOUR-PROMPT". Para tenerlo en cada sesión, lanza /experimental on y reinicia la CLI. En VS Code, activa el ajuste chat.copilot.hydraFusion.enabled; en la Copilot app, activa Settings → Experimental → HydraFusion.
- 5
Elige HydraFusion en el selector de modelos
Abre /model y elige HydraFusion (Research Preview) — aparece en la lista como un modelo aunque no lo sea. Lee las dos líneas que imprime el selector antes de seguir: "HydraFusion routes the first eligible turn and may use multiple models. Premium usage varies with the selected route." El cambio solo vale para la sesión actual; con /config model lo dejas como predeterminado para futuras sesiones.
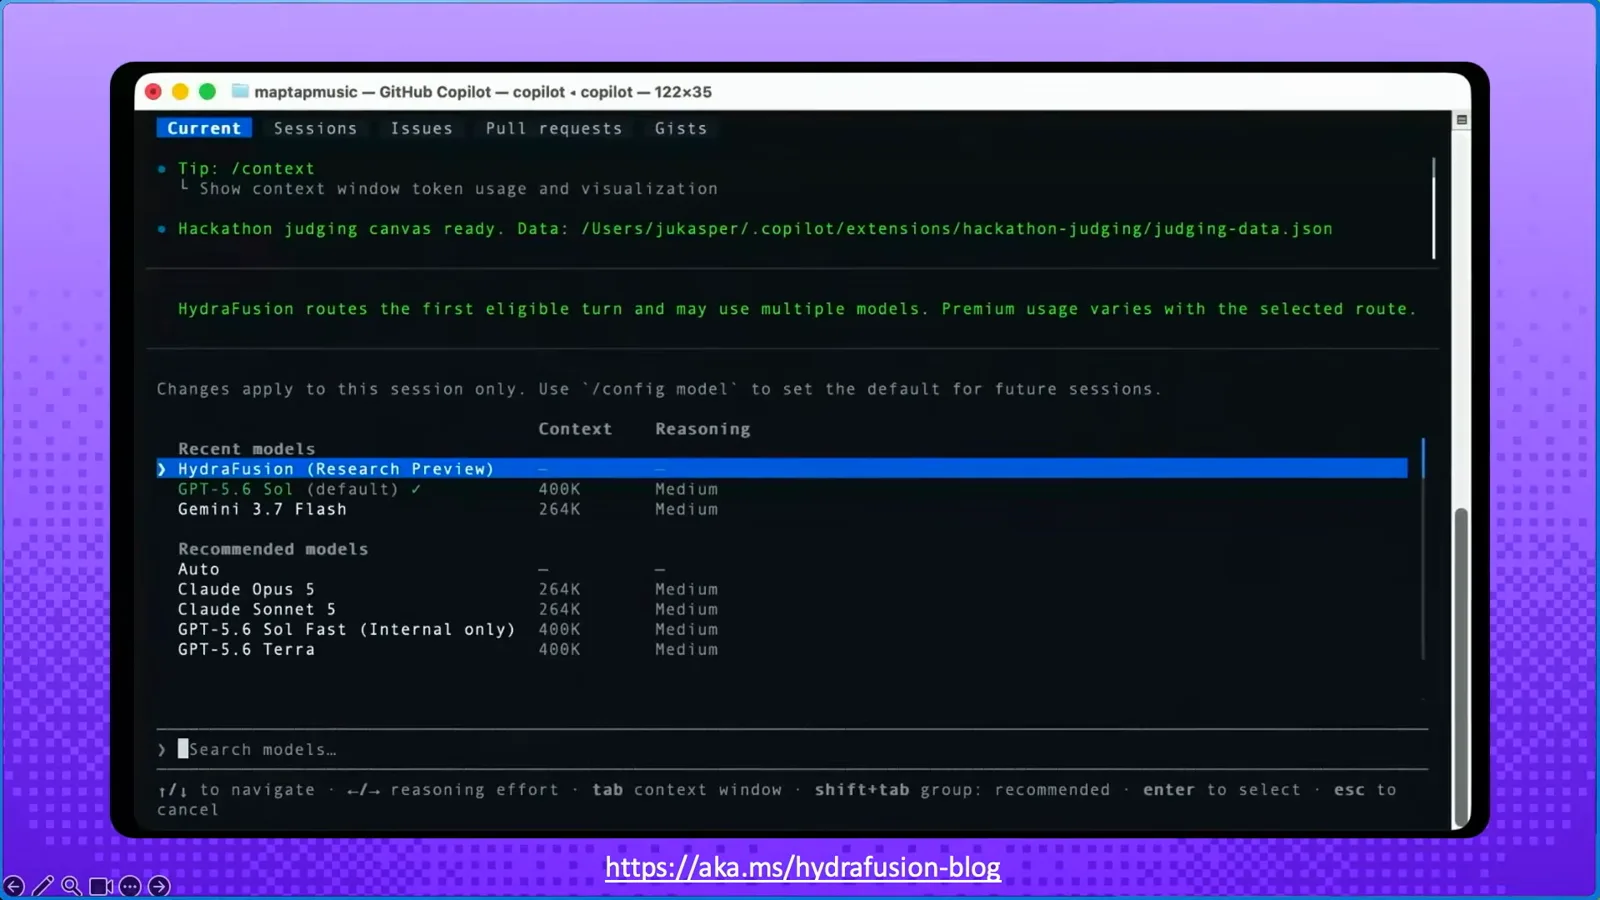
El selector de modelos de Copilot CLI con HydraFusion (Research Preview) resaltado bajo Recent models, por encima del pool del lanzamiento: GPT-5.6 Sol (predeterminado), Gemini 3.7 Flash, Claude Opus 5, Claude Sonnet 5 y GPT-5.6 Terra.Ver en 1:00 - 6
Manda un prompt y mira cómo se forma el plan
Manda una tarea real y la vista de progreso muestra lo que decidió el router: el patrón elegido, el estado de cada pasada, la actividad actual y el tiempo transcurrido — "Fusion · selecting an approach…", "Fusion · drafting…", "Fusion · checking…", "Fusion · preparing final response…". Pulsa Esc para interrumpir una ejecución; después queda un resumen en la conversación. En VS Code y en la app, pasa el cursor por el pie de la respuesta para ver qué modelos se usaron.
Paso 3 — Lee las tres rutas de ejecución
- 7
Lee un plan SINGLE: bastó un modelo
En la tarea de type hints y docstrings el router eligió SINGLE: una pasada SOLVE con gpt-5.6-sol — sin segundo modelo, sin paso de revisión. La CLI midió toda la tarea en 5,3 AIU mientras el Opus 5 en solitario quemaba 32,1 y el Fable 5.1 en solitario 20,3 con el mismo prompt. SINGLE es lo que te llevas en trabajo bien acotado: el router no paga una revisión que no necesita.
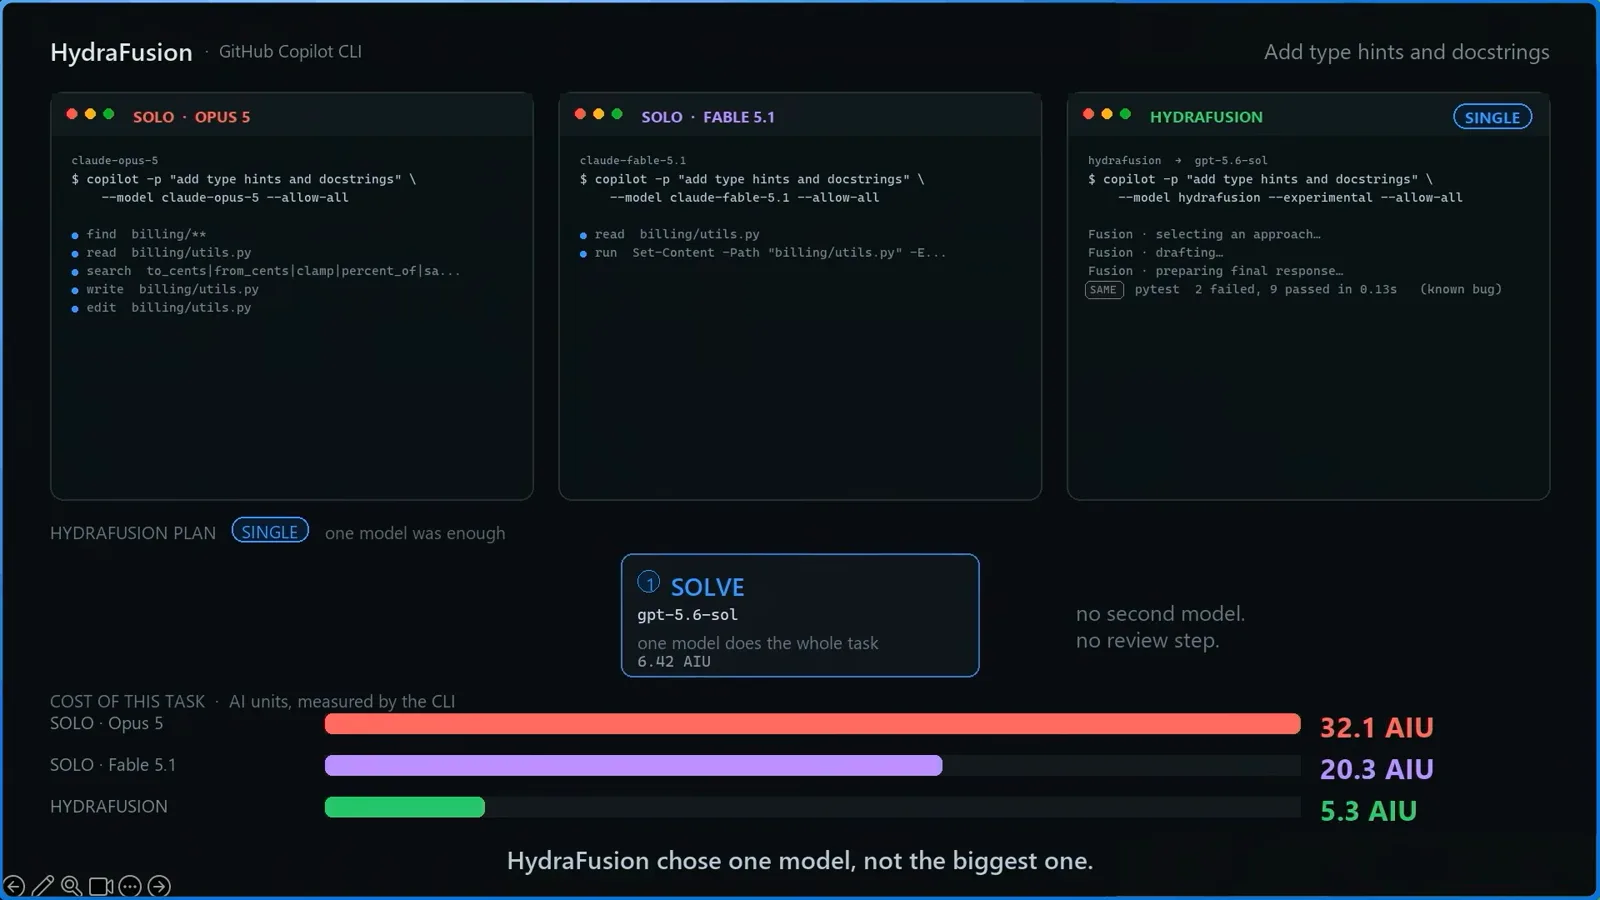
La tarjeta del plan SINGLE — SOLVE con gpt-5.6-sol, "one model does the whole task" — junto a las barras de coste: HydraFusion 5,3 AIU frente al Opus 5 en solitario con 32,1 y el Fable 5.1 en solitario con 20,3 en la misma tarea de type hints.Ver en 6:40 - 8
Lee un plan CASCADE: borrador barato, escala solo si falla
En "fix the failing retry tests" el router corrió CASCADE: gpt-5.6-luna redactó por 0,86 AIU, un juez gpt-5.6-sol calificó el intento por 0,22 e imprimió "verdict: reject", y luego gpt-5.6-sol rehízo el trabajo por 5,25 — tras lo cual la suite se puso en verde (pytest 11 passed). Total: 5,5 AIU frente a 27,2 del Opus 5 en solitario. Cascade solo paga el precio de la escalada cuando el borrador barato de verdad suspende la comprobación.
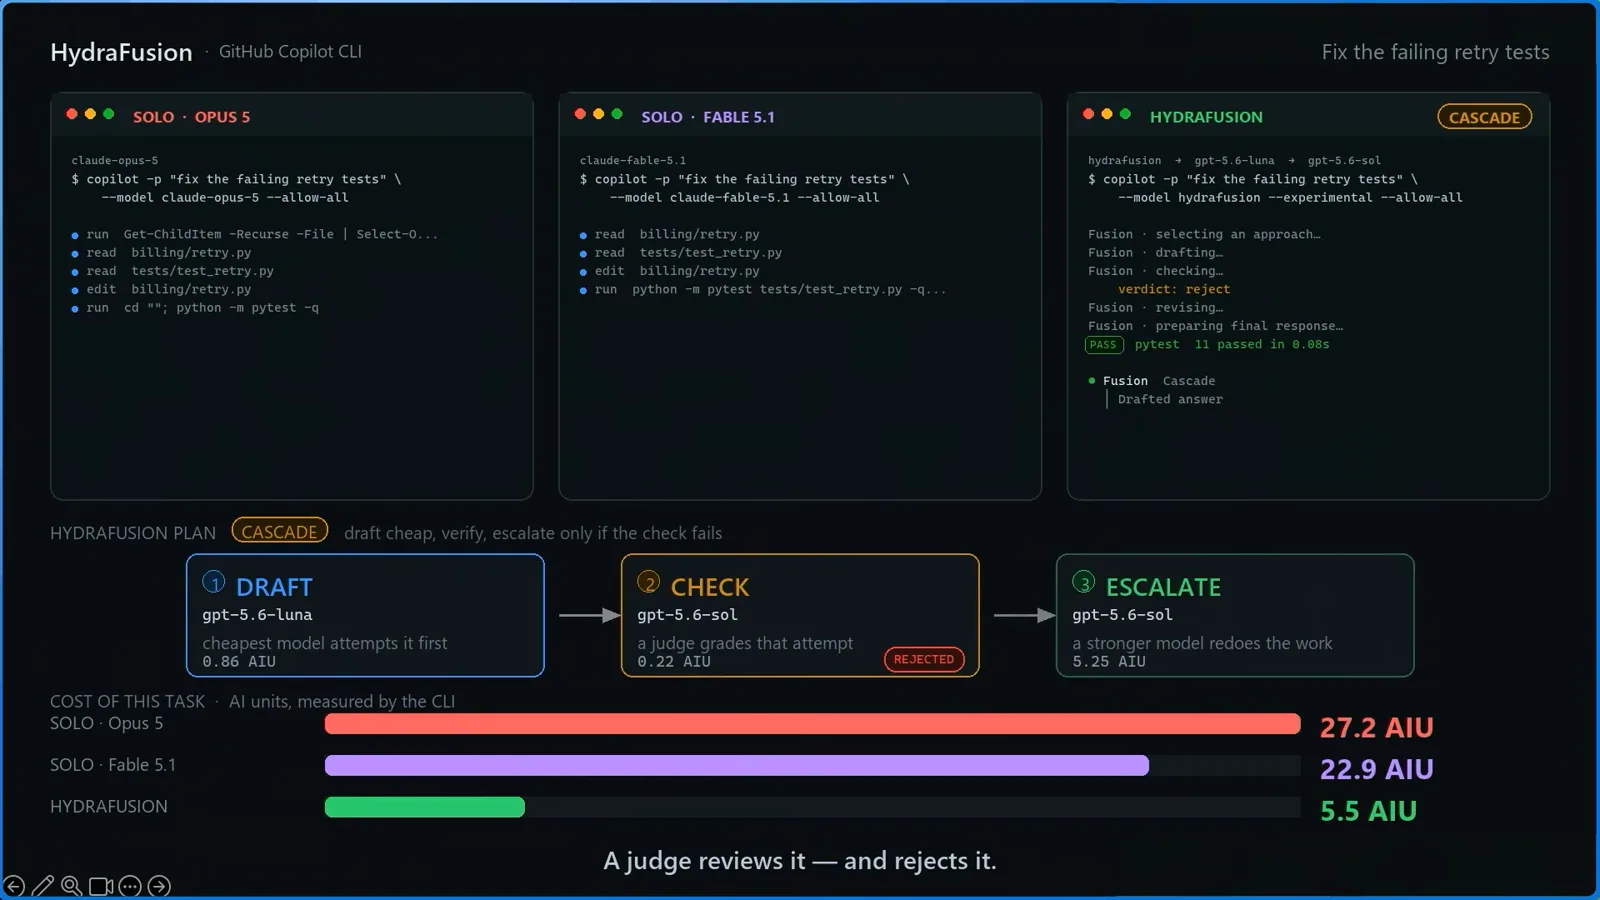
La cadena CASCADE en la tarea de los tests de reintentos: DRAFT gpt-5.6-luna (0,86 AIU) → juez CHECK (0,22 AIU) estampado REJECTED → ESCALATE gpt-5.6-sol (5,25 AIU), con las barras de la tarea sumando 5,5 AIU.Ver en 7:40 - 9
Lee un plan CRITIQUE: paga a un segundo modelo por revisar
En la migración del endpoint de cobros — radio de impacto alto — el router eligió CRITIQUE: claude-opus-5 redactó (47,16 AIU), gpt-5.6-sol auditó el borrador por 0,60 y lo estampó SENT BACK, y luego claude-opus-5 reescribió una vez por 15,86 hasta que la suite pasó. Critique es el patrón caro — aquí 60,7 AIU, más que los 39,9 del Opus 5 en solitario — y es lo que el router reserva para trabajo donde un merge erróneo cuesta más que la revisión.
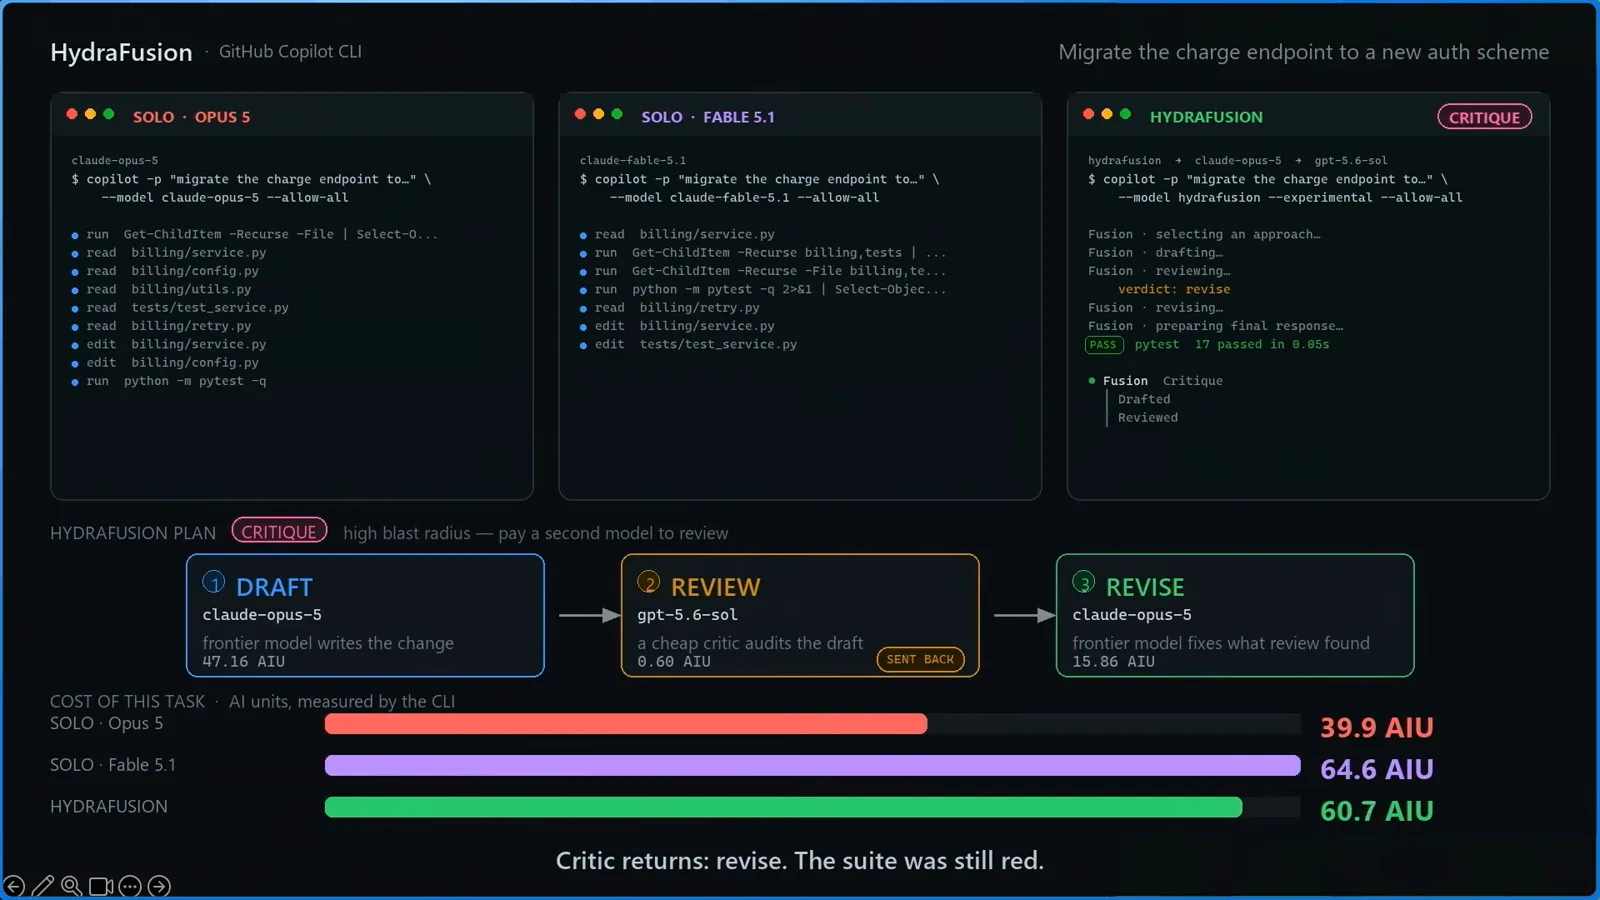
La cadena CRITIQUE en la tarea de migración del endpoint: DRAFT claude-opus-5 → REVIEW gpt-5.6-sol (SENT BACK) → REVISE claude-opus-5, en total 60,7 AIU frente al Opus 5 en solitario con 39,9 y el Fable 5.1 en solitario con 64,6.Ver en 8:20
Paso 4 — Max, facturación y salidas limpias
- 10
Cambia a HydraFusion Max para tareas exigentes
El changelog del 2026-10-14 añadió una segunda entrada al selector: HydraFusion Max. El HydraFusion estándar redacta con esfuerzo de razonamiento medio y revisa con alto, posicionado para trabajo sustancial bien acotado — bug fixes complejos, cambios multi-archivo. Max añade esfuerzo de razonamiento extra alto y está afinado para capacidad frontera en las tareas más exigentes. Se elige de la misma lista de /model; todo lo demás del flujo es idéntico.
- 11
Audita la factura con /usage
HydraFusion factura por modelo, a la tarifa estándar de ese modelo — sin cargo separado de HydraFusion, y el descuento de selección automática (Auto) no aplica. Lanza /usage en la CLI para ver los créditos de IA por modelo. En la ejecución grabada de cuatro tareas los totales fueron 84,8 AIU de HydraFusion frente a 146,5 del Opus 5 en solitario y 159,0 del Fable 5.1 en solitario — 42 % y 47 % más barato —, pero solo la tarea cargada de critique costó 63,6, así que la mezcla de rutas manda en la factura.
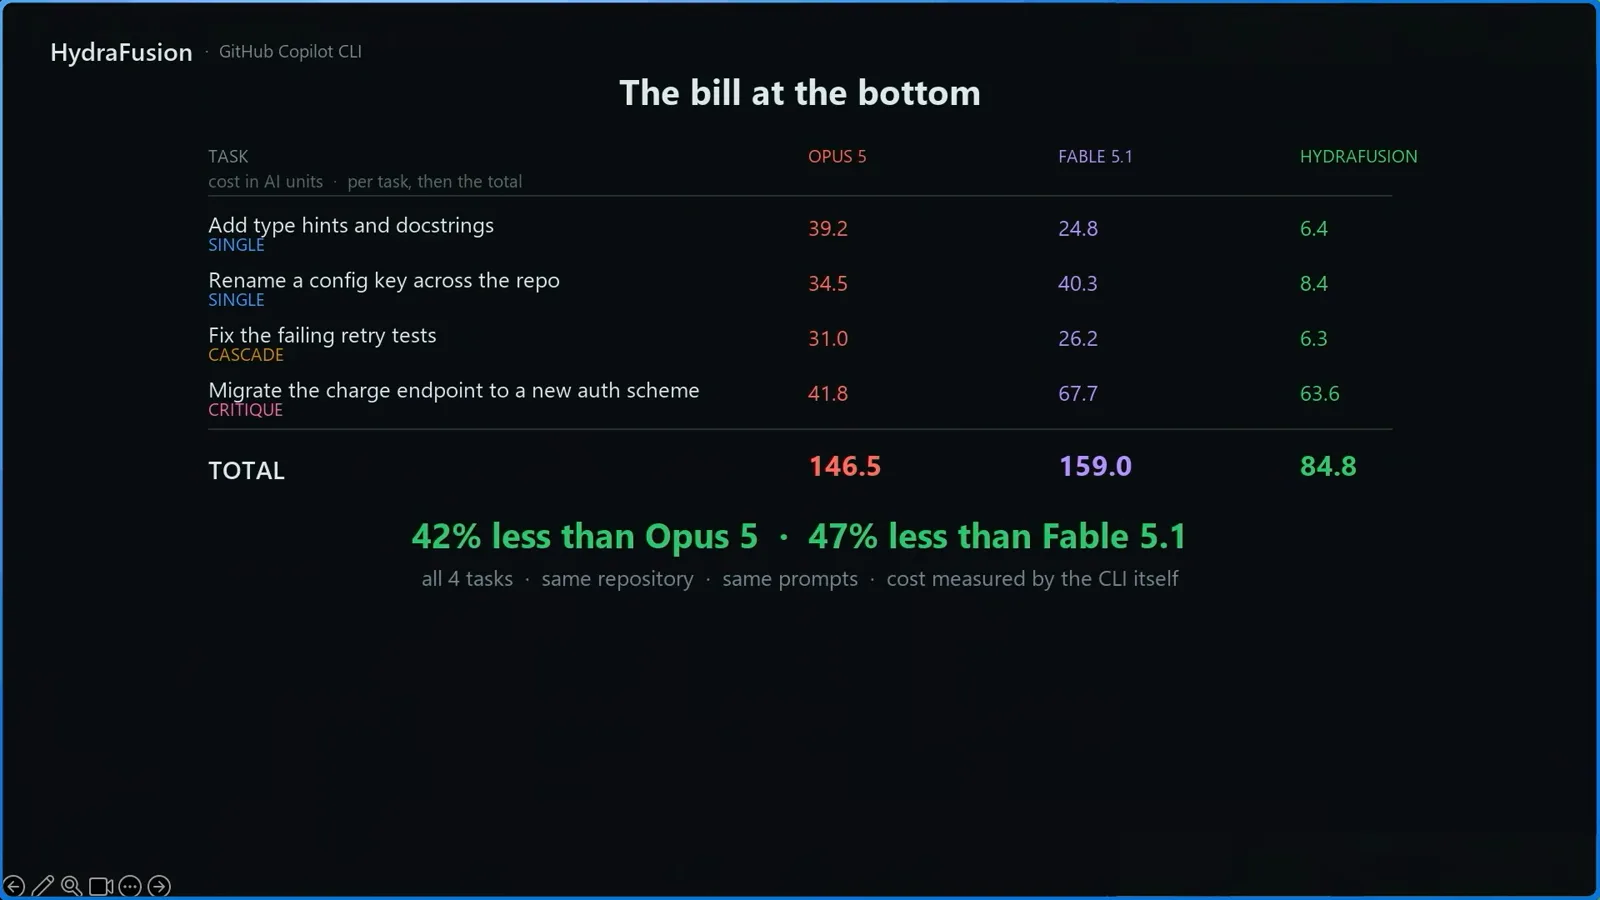
La diapositiva "The bill at the bottom": AIU por tarea para las cuatro tareas de la demo y los totales — HydraFusion 84,8 frente al Opus 5 en solitario con 146,5 y el Fable 5.1 en solitario con 159,0, 42 % y 47 % más barato.Ver en 9:00 - 12
Revisa los borradores descartados antes de hacer commit
Dos limitaciones de la vista previa para integrar en tus hábitos. Primera: si una pasada se descarta — un borrador Cascade que el juez rechaza, una pasada Critique devuelta —, los cambios en el workspace que ya hizo no se deshacen automáticamente, así que haz un diff y revísalo antes de hacer commit. Segunda: HydraFusion no funciona con subagentes ni los lanza. Para prompts de rutina, el Auto a secas sigue siendo el predeterminado barato; los benchmarks oficiales reclaman TerminalBench 2.1 con un 67 % menos de coste más 4,9 puntos de calidad, DeepSWE un 36 % menos (−1,5 puntos) y CheckpointBench un 65 % menos (−0,1 puntos) frente a Opus 5.
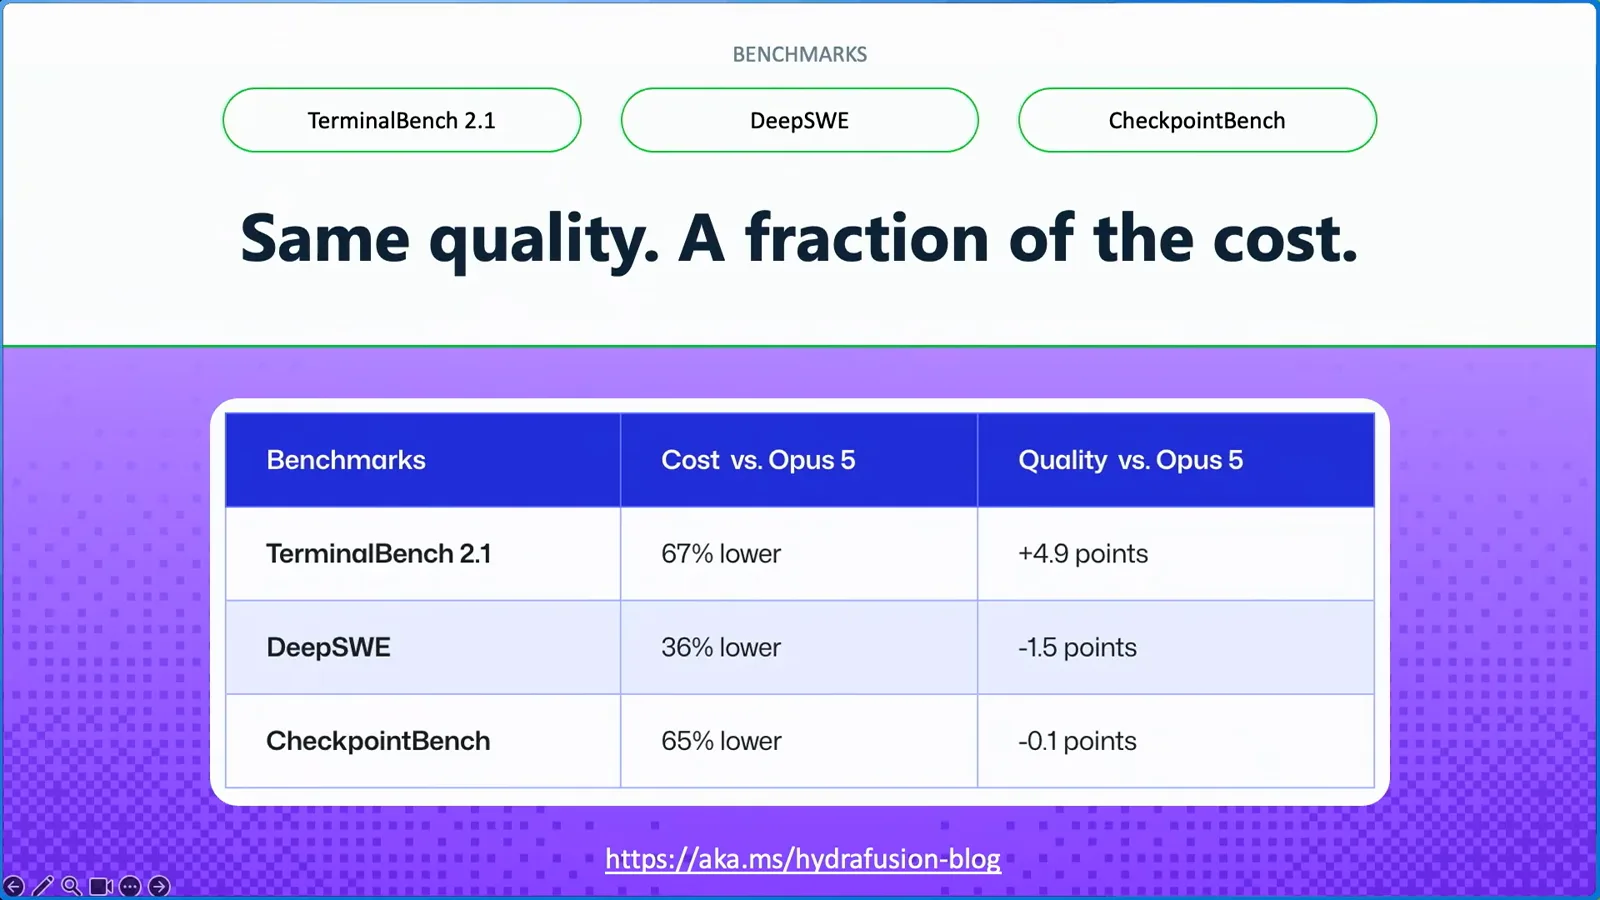
La tabla de benchmarks del recorrido oficial: TerminalBench 2.1 con un 67 % menos de coste y +4,9 puntos de calidad frente a Opus 5, DeepSWE un 36 % menos, CheckpointBench un 65 % menos.Ver en 10:25
HydraFusion vs HydraFusion Max
Ambas entradas viven en el mismo selector de modelos y corren el mismo router — la diferencia es cuánto se deja pensar a cada pasada. GitHub lanzó la opción Max en el changelog del 2026-10-14 ("HydraFusion updates and new Max option") junto con el pool de modelos actualizado (Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna), el esfuerzo de razonamiento por paso y el paso de juicio de Cascade.
- 1El HydraFusion estándar es el modo equilibrado: los borradores corren con esfuerzo de razonamiento medio y las revisiones con alto, posicionado para tareas sustanciales bien acotadas como bug fixes complejos y cambios multi-archivo.
- 2HydraFusion Max añade esfuerzo de razonamiento extra alto — la documentación lo describe como "tuned for frontier capability on more demanding tasks", para el razonamiento más profundo y el análisis más minucioso.
- 3Ambos se eligen del mismo selector (HydraFusion y HydraFusion Max, ambos etiquetados Research Preview), y puedes cambiar entre ellos por sesión con /model.
- 4Max multiplica el quemado de tokens: la ejecución multi-pasada más el esfuerzo extra alto por pasada consume créditos de IA bastante más rápido que el estándar — y cada pasada sigue facturándose a la tarifa estándar de su modelo.
- 5Ninguna de las dos entradas tiene SLA, ambas pueden cambiar durante la vista previa y ninguna funciona con subagentes — Max es un mando de capacidad, no un nivel de estabilidad.
- 6Reparto práctico: deja el HydraFusion estándar para el trabajo multi-archivo de cada día, reserva Max para la tarea que le habrías dado al modelo en solitario más caro, y usa el Auto a secas para prompts de rutina donde ni siquiera compensa pagar el router.
El deep dive grabado es anterior a Max, así que sus números — 84,8 AIU en cuatro tareas, 42–47 % por debajo de los modelos en solitario — miden solo el HydraFusion estándar. Tómalos como el suelo de la ruta Single: las tareas cargadas de critique con Max quedarán por encima.