Claude Code lento? 12 correções para respostas ágeis (2026)
Por que o Claude Code está tão lento? Leia a linha de status, enxugue o contexto com uma CLAUDE.md enxuta e /clear, troque de modelo com /model e acompanhe o limite de 5 horas.
TL;DR
- A maioria dos «Claude Code está lento» é inchaço de contexto. A linha de status mostra o preço de cada turno em segundos e tokens — leia-a antes de sair procurando outra ferramenta.
- Carregue menos: crie uma CLAUDE.md com /init e mantenha abaixo de 200 linhas, use /clear entre tarefas e um /compact com foco quando a sessão tiver que sobreviver.
- Mande o trabalho para o motor certo: /model para um modelo mais rápido nas edições de rotina, /context para ver quem está comendo a janela e menos servidores MCP por projeto.
- Parte da lentidão não é sua: confira status.claude.com e fique de olho no limite rolante de 5 horas — um monitor no terminal mostra o contador de reset e o burn rate ao vivo.
Wait.. Claude Code is MADE Slow on Purpose? Heres How to Fix It
Canal: AI LABS10:35
Why Claude Code Gets Slow and Forgetful and 4 Habits That Fix It
Canal: Prompt to Prod11:00
Manage costs & usage limits — official documentation
Docs oficiais: code.claude.com/docs
Cada comando, limite e padrão desta página foi verificado contra code.claude.com/docs e o changelog do anthropics/claude-code; os vídeos acima são as fontes visuais e de fatos, incluindo as leituras da linha de status e o monitor da janela de cinco horas. Quando o vídeo e a documentação divergem, o guia segue a documentação.
As capturas de tela são atribuídas aos seus criadores com deep links para o timestamp exato. Nenhum quadro com rosto é usado.
Devoler a velocidade ao Claude Code, passo a passo
Parte 1 — Ver para onde vai o tempo
- 1
Enviar um prompt de verdade a uma sessão recém-aberta
Rode claude no seu projeto e digite um pedido real. Uma sessão novinha começa sem nada além da caixa de boas-vindas, então o Claude precisa ler seus arquivos antes de responder — essa passada de descoberta é onde nascem a maioria dos «Claude Code está lento». Observe os verbos do spinner mudando na área de entrada.
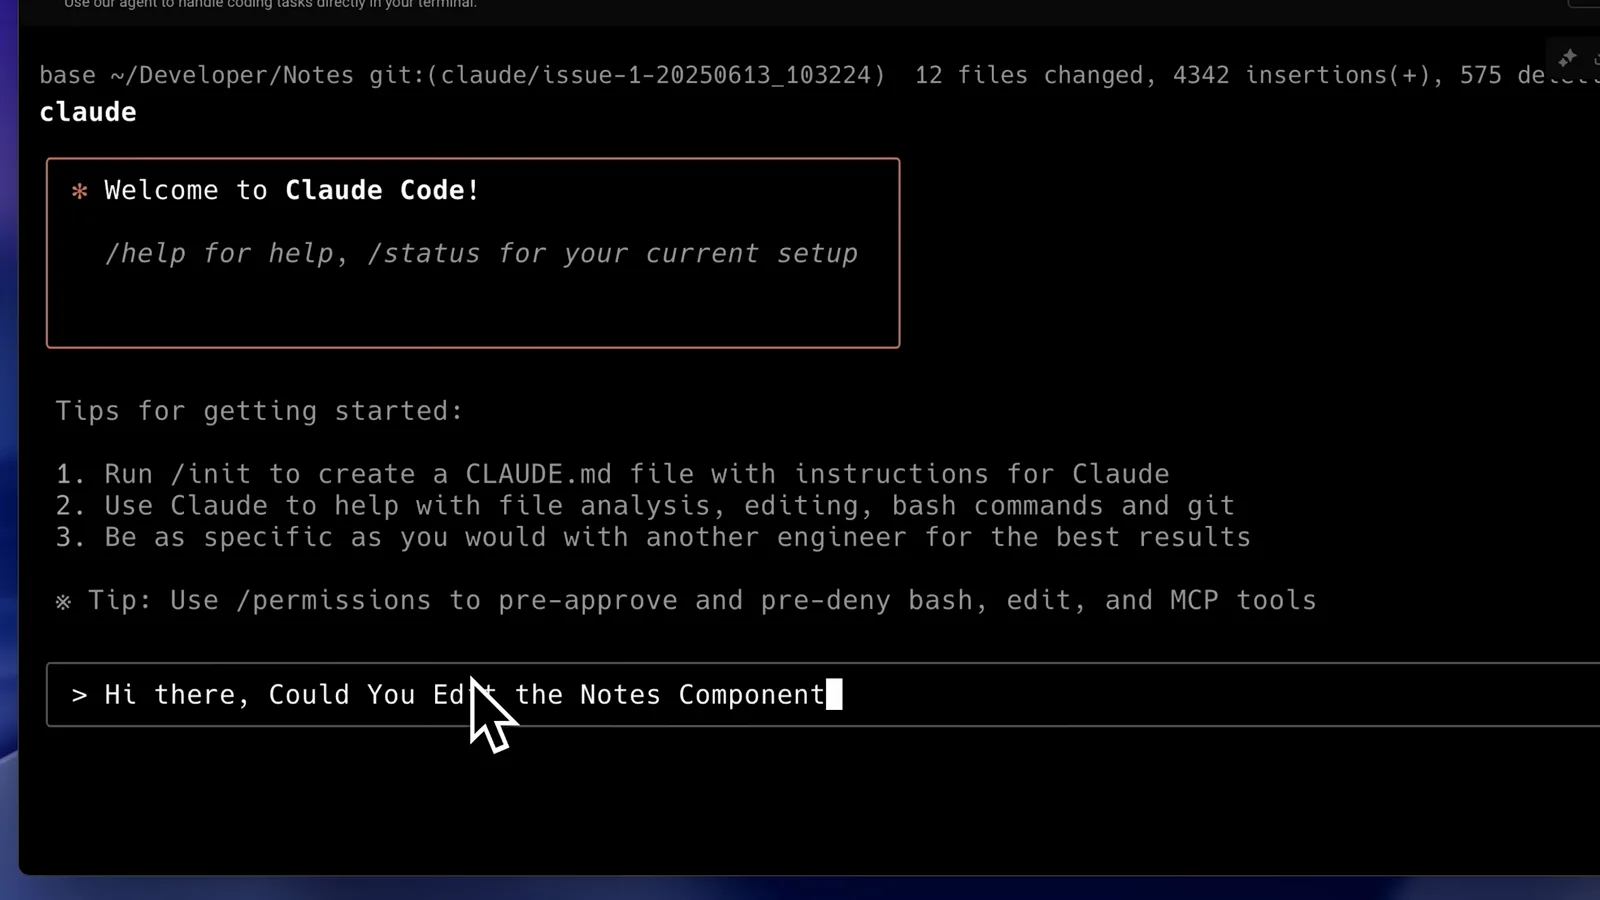
Uma sessão nova: as dicas da caixa de boas-vindas são todo o contexto com que o Claude Code parte.Assistir em 0:08 - 2
Ler a linha de status enquanto ele trabalha
Abaixo do diff aparece uma linha como «Unravelling… (16s · 351 tokens · esc to interrupt)». O verbo é decoração; os segundos e a contagem de tokens são seu velocímetro. Eles dizem se o Claude está pensando, esperando ou garimpando arquivos. Se todo turno queima centenas de tokens antes da primeira edição, o contexto é quem está freando.
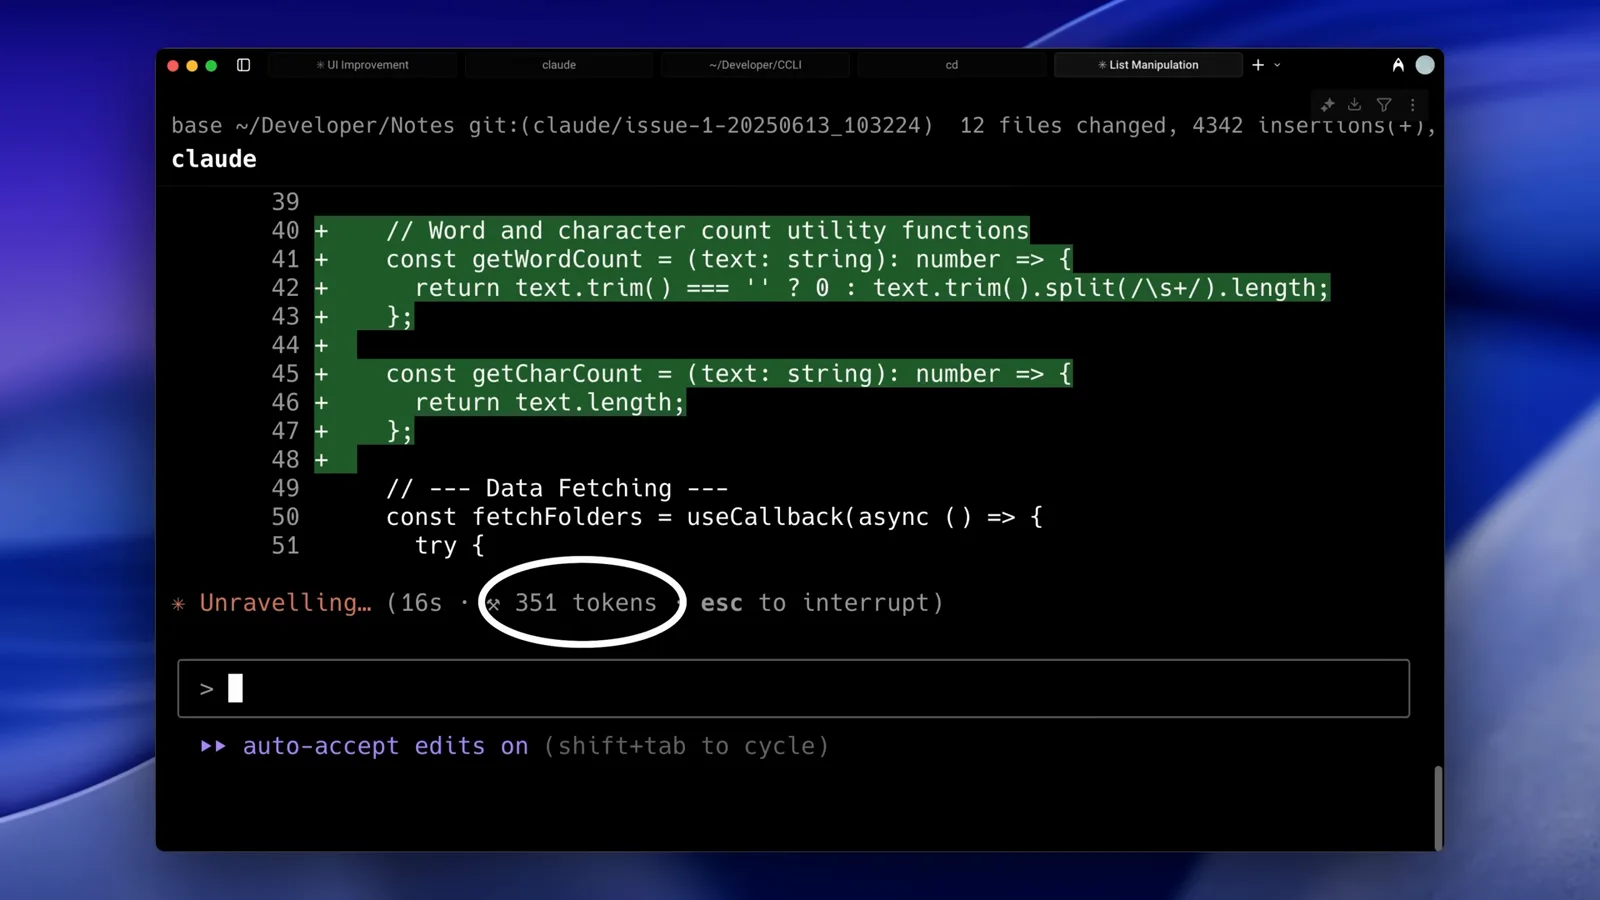
A linha de status é seu velocímetro: verbo, segundos, tokens, esc to interrupt.Assistir em 1:08 - 3
Abrir o diff e ver o que uma edição pequena arrastou
Até uma função mínima precisa ser encontrada primeiro. A edição do contador de palavras do vídeo mexe em um arquivo com nove adições — e o turno gasta 352 tokens antes do spinner assentar. Num repo maior, a descoberta significa listar diretórios e ler arquivos que não têm nada a ver com o pedido — o vídeo chama isso de «se afogar em informação desnecessária».
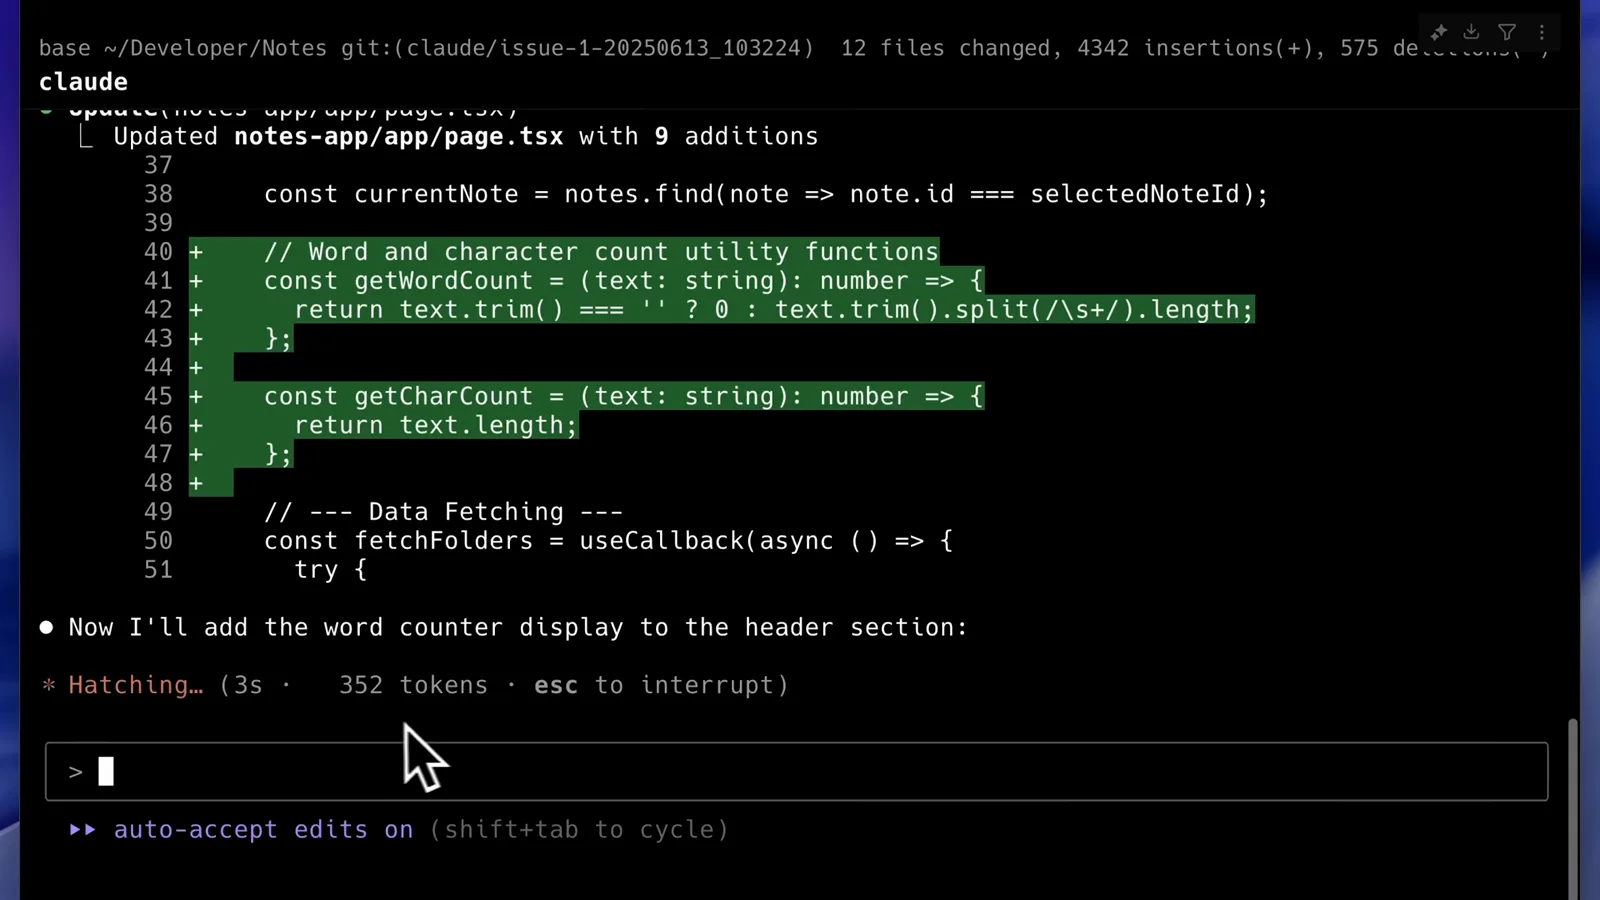
Nove adições em um único arquivo — e o spinner continua contando tokens.Assistir em 0:22
Parte 2 — Alimentar com menos contexto
- 4
Rodar /init para gerar a CLAUDE.md
Digite /init e escolha «Initialize a new CLAUDE.md file with codebase documentation». É o comando documentado que dá ao Claude um briefing permanente sobre seu repo, para a sessão nova parar de redescobrir o projeto antes de cada edição. O maior antídoto para a reclamação de «ele lê tudo primeiro».
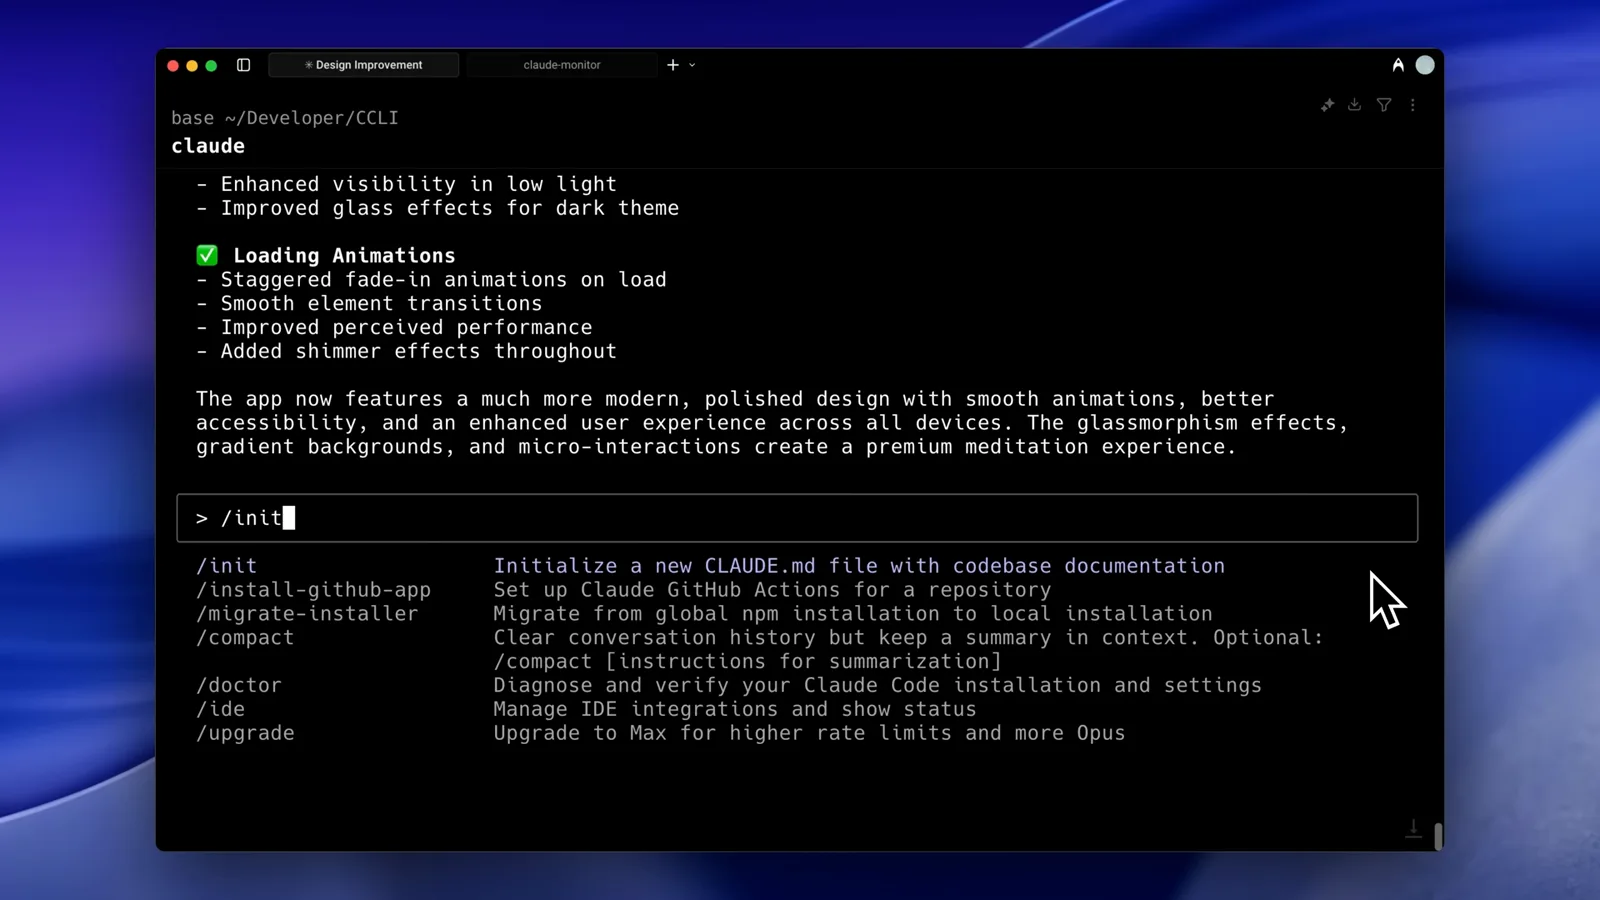
/init é a forma documentada de gerar a CLAUDE.md.Assistir em 3:38 - 5
Deixar o scan único acontecer
O Claude lê package.json, o README, o router e mais, e então escreve o arquivo — a execução do vídeo mostra um spinner Deciphering… depois de uns 90 tokens em chamadas de ferramentas. Esse custo se paga uma vez. Da próxima sessão em diante, o contexto de que o Claude precisa já está na CLAUDE.md em vez de ser relido do disco.
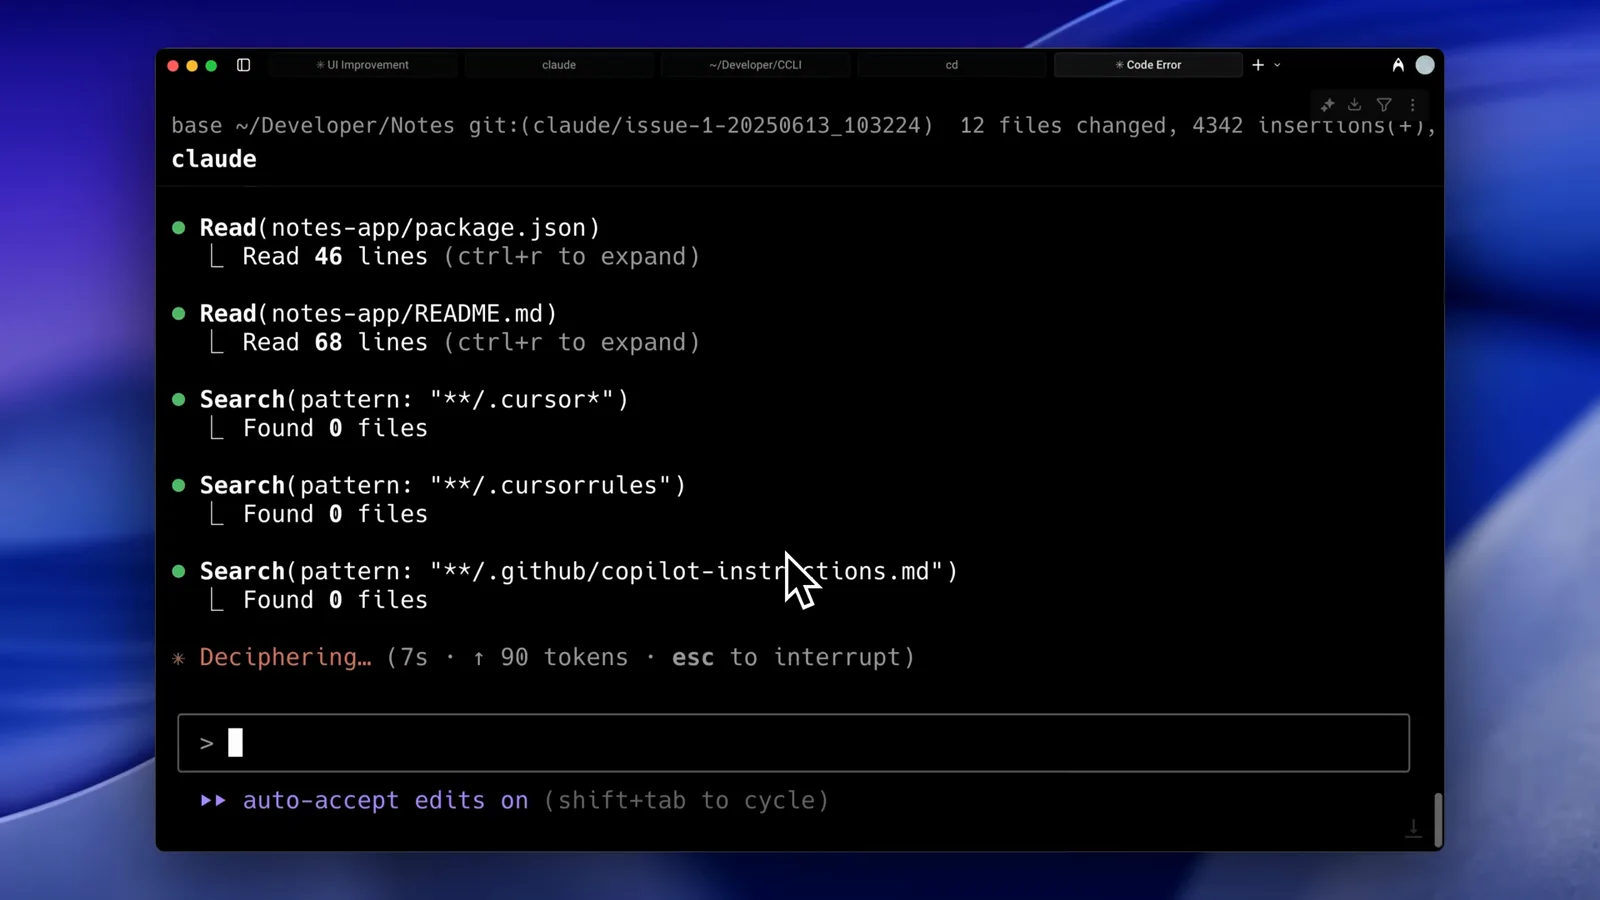
O scan único: leituras, buscas e depois a escrita.Assistir em 2:22 - 6
Manter a CLAUDE.md enxuta — comandos e arquitetura
O arquivo pronto guarda comandos de dev, a camada de banco de dados e um resumo curto de arquitetura. Fique aí: a documentação oficial diz que a CLAUDE.md é carregada no contexto a cada início de sessão e recomenda menos de 200 linhas. Uma CLAUDE.md obesa recria o problema que veio resolver — mova fluxos especializados para skills, que carregam sob demanda.
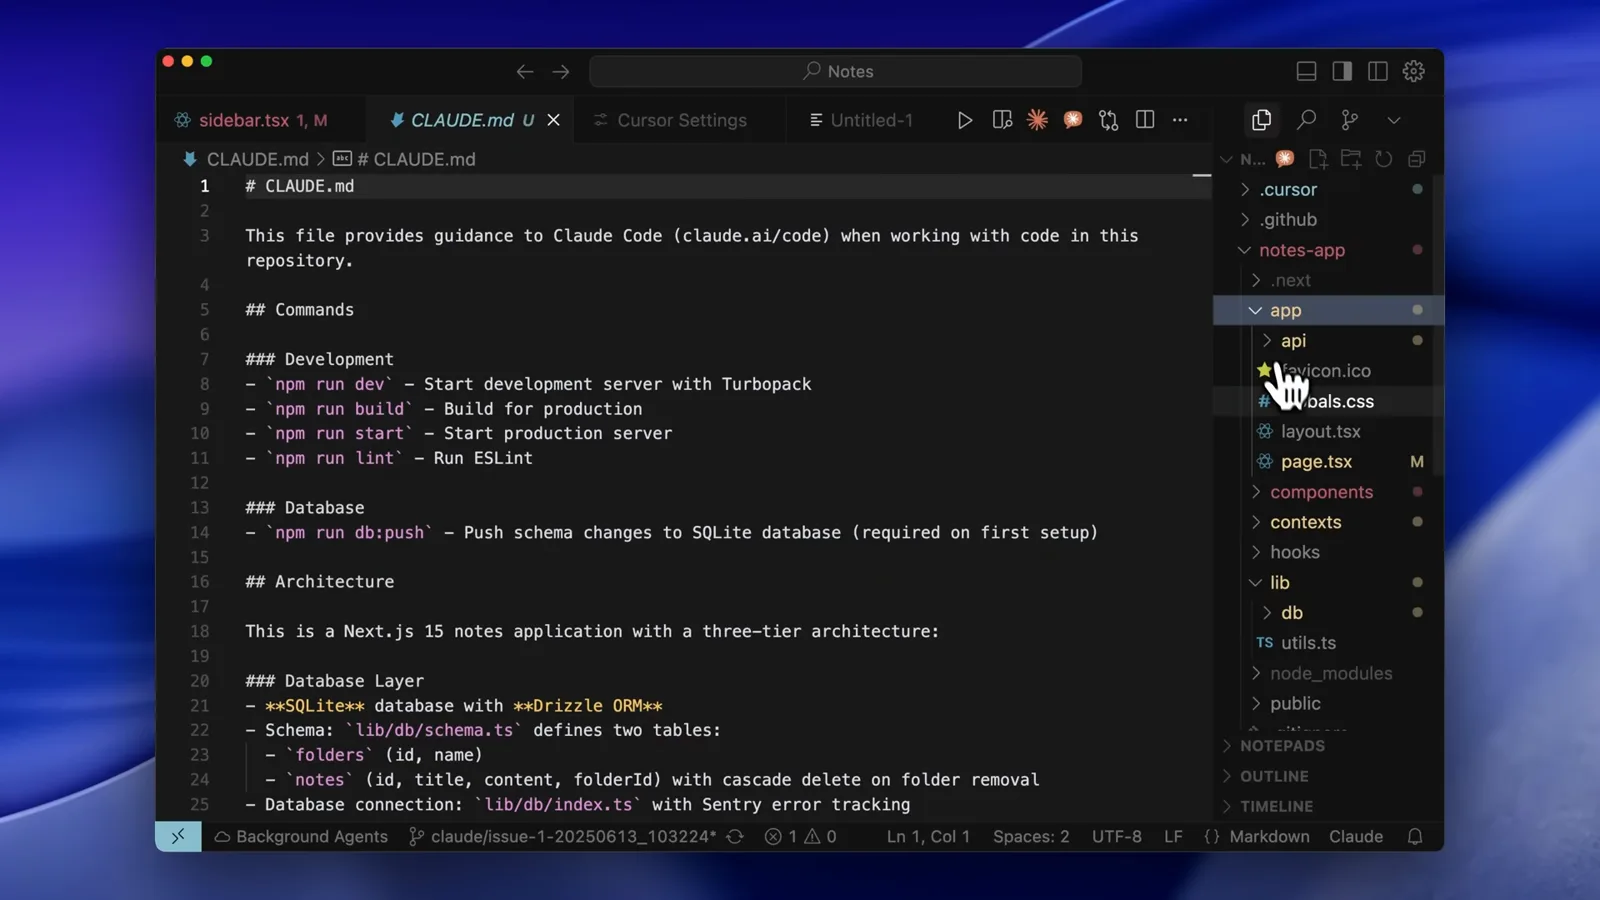
Comandos e arquitetura — o arquivo que carrega a cada sessão. Mantenha curto.Assistir em 3:50 - 7
Trazer a documentação por busca semântica, em vez de entupir o contexto
Para perguntas de biblioteca, o vídeo mostra o MCP Context7 chamando get-library-docs com o tópico «best practices» e recebendo só a seção relevante do repositório de TypeScript da Microsoft. Busca semântica devolve apenas os pedaços que importam, em vez de puxar páginas inteiras de documentação para a janela.
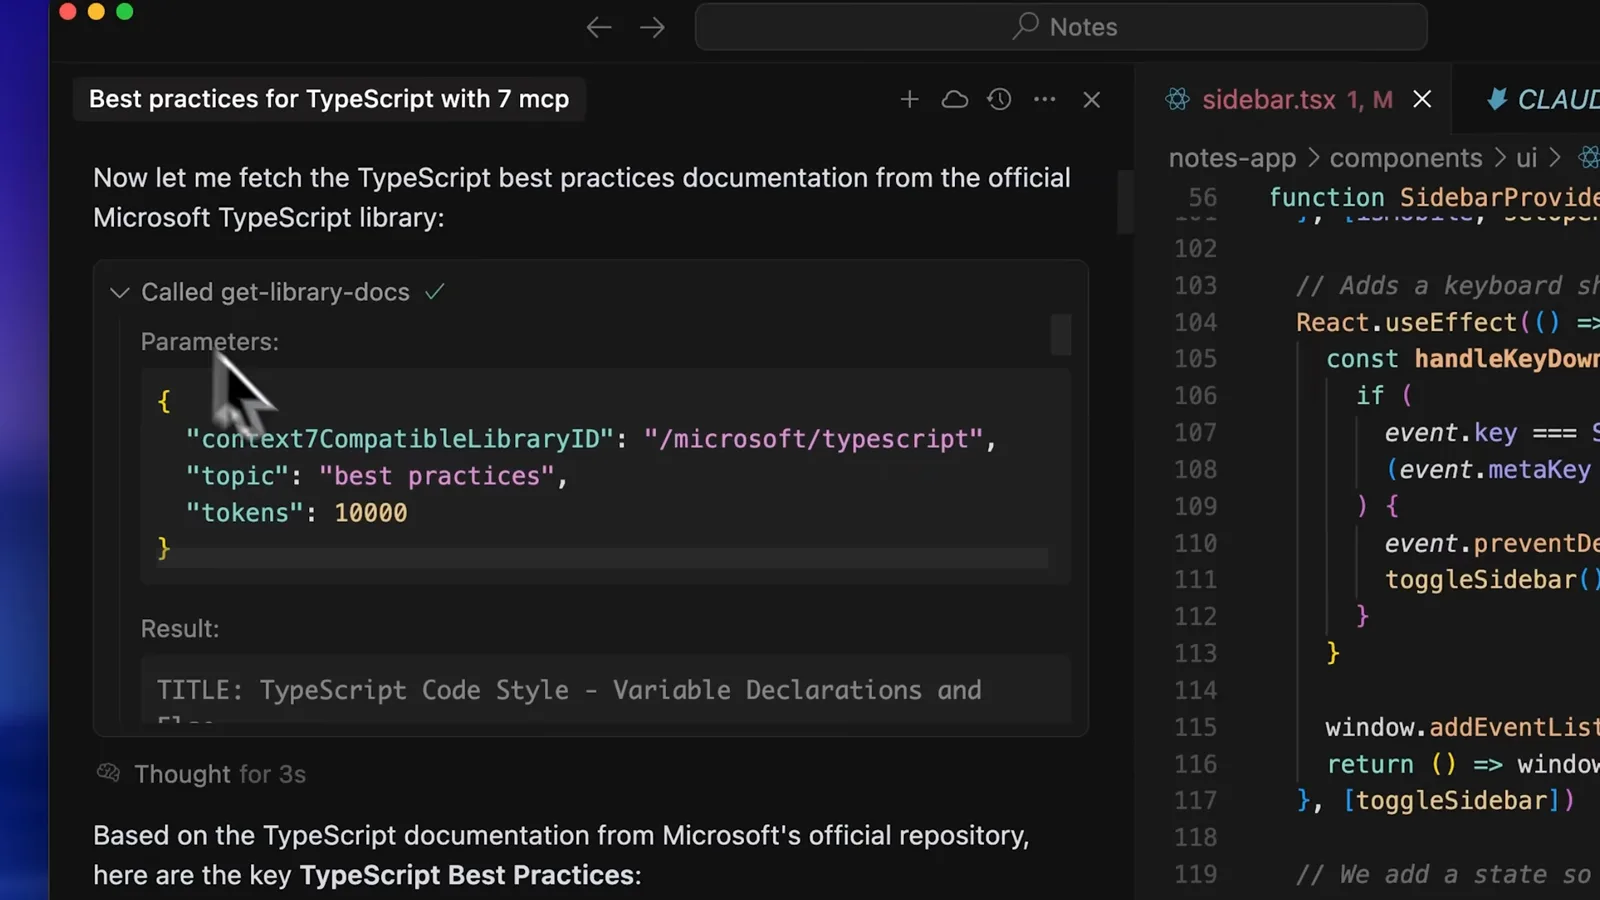
get-library-docs devolve a seção correspondente, não o manual inteiro.Assistir em 2:48 - 8
Verificar o servidor MCP com /mcp
Rode /mcp e confirme que o servidor aparece «connected» — o vídeo adiciona o servidor de código semântico Serena com claude mcp add e confere aqui. Duas ressalvas do vídeo e da documentação: um servidor MCP vale por projeto, então adicione em cada repo onde quiser usá-lo; e um servidor que trava na inicialização atrasa cada sessão daquele projeto.
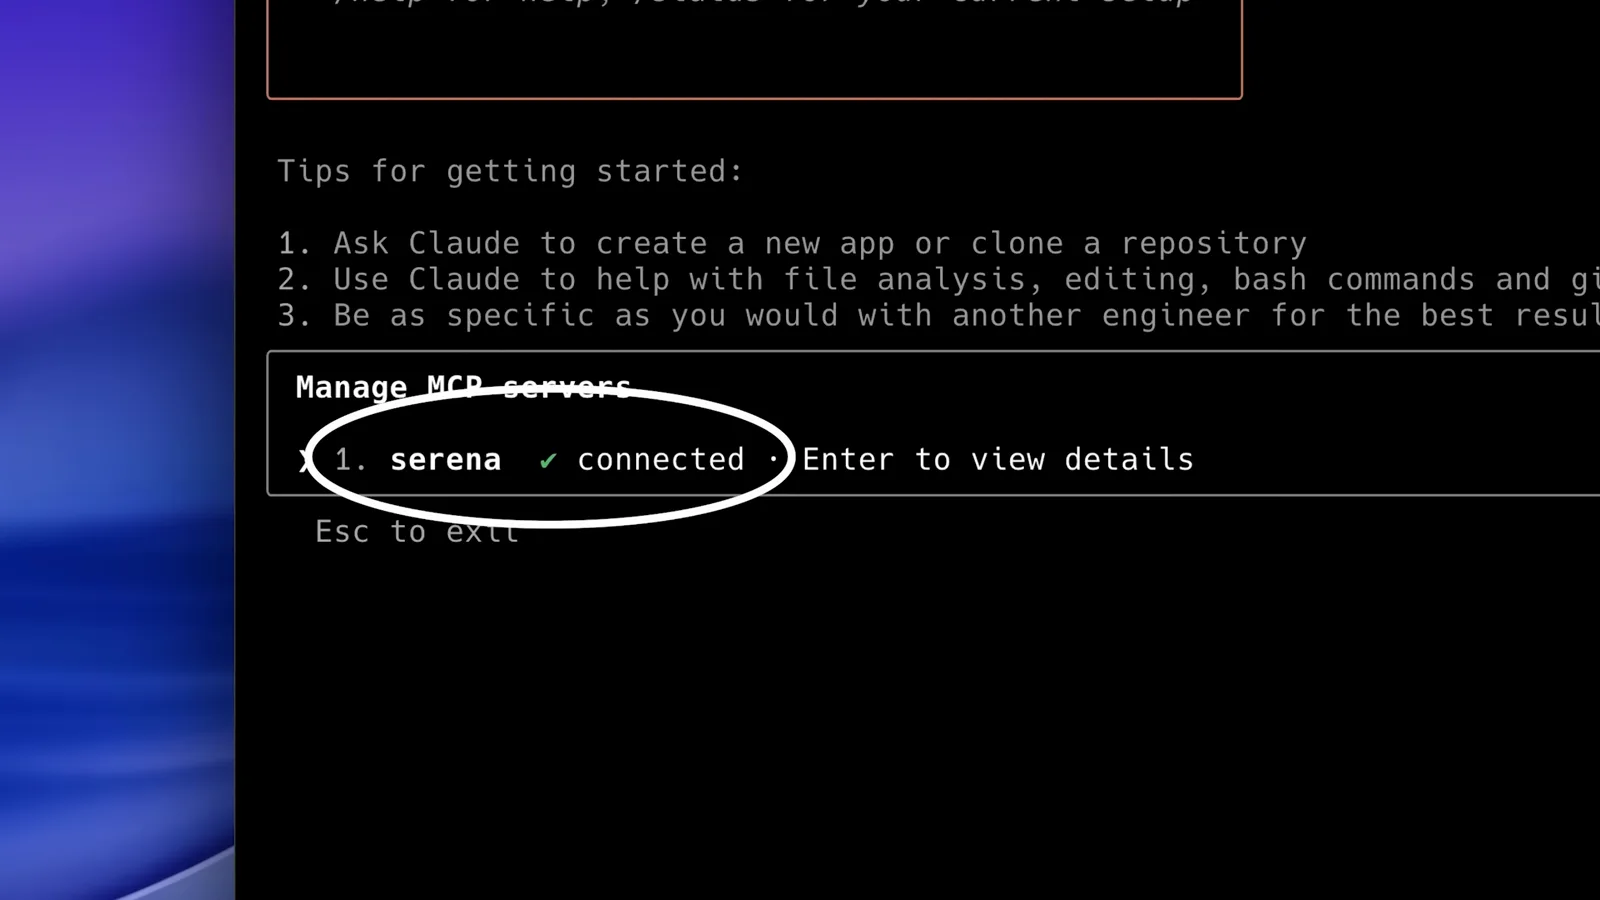
/mcp é onde um servidor lento se esconde: serena mostra um connected verde.Assistir em 5:31
Parte 3 — Modelos, limites e monitoramento
- 9
Passar a rotina para um modelo mais rápido
Abra /model — ou o seletor do seu IDE — e combine o motor com a tarefa. A documentação oficial recomenda Sonnet como padrão do dia a dia mais barato e Opus para raciocínio complexo; tarefas simples de subagentes podem rodar no Haiku. Um modelo mais rápido não conserta contexto entupido, mas em edições pequenas corta junto tempo de resposta e custo por token.
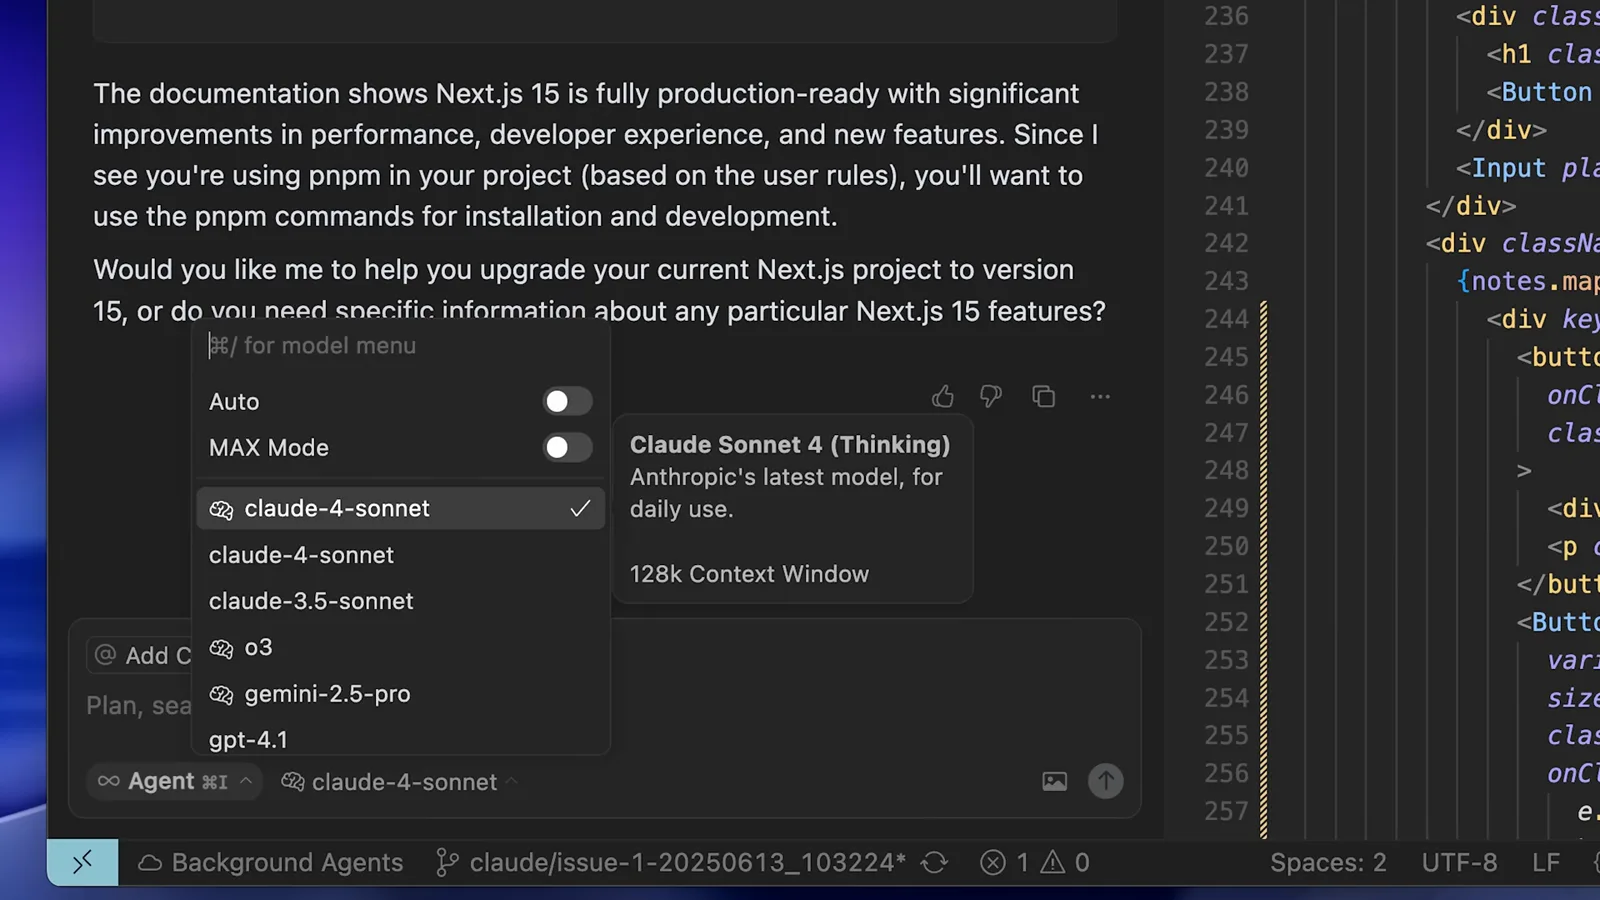
Mesmo prompt, outro motor: o seletor mora no /model e na barra do IDE.Assistir em 4:32 - 10
Saber o que acontece ao bater no limite
A docs da Anthropic traça a linha: «You've hit your session limit» e os avisos de limite semanal são por assento — trocar de modelo não ajuda, e a mensagem mostra o horário do reset. Limites específicos de modelo se contornam com /model, e desde a v2.1.234 o menu /rate-limit-options pode retomar uma tarefa após o reset.
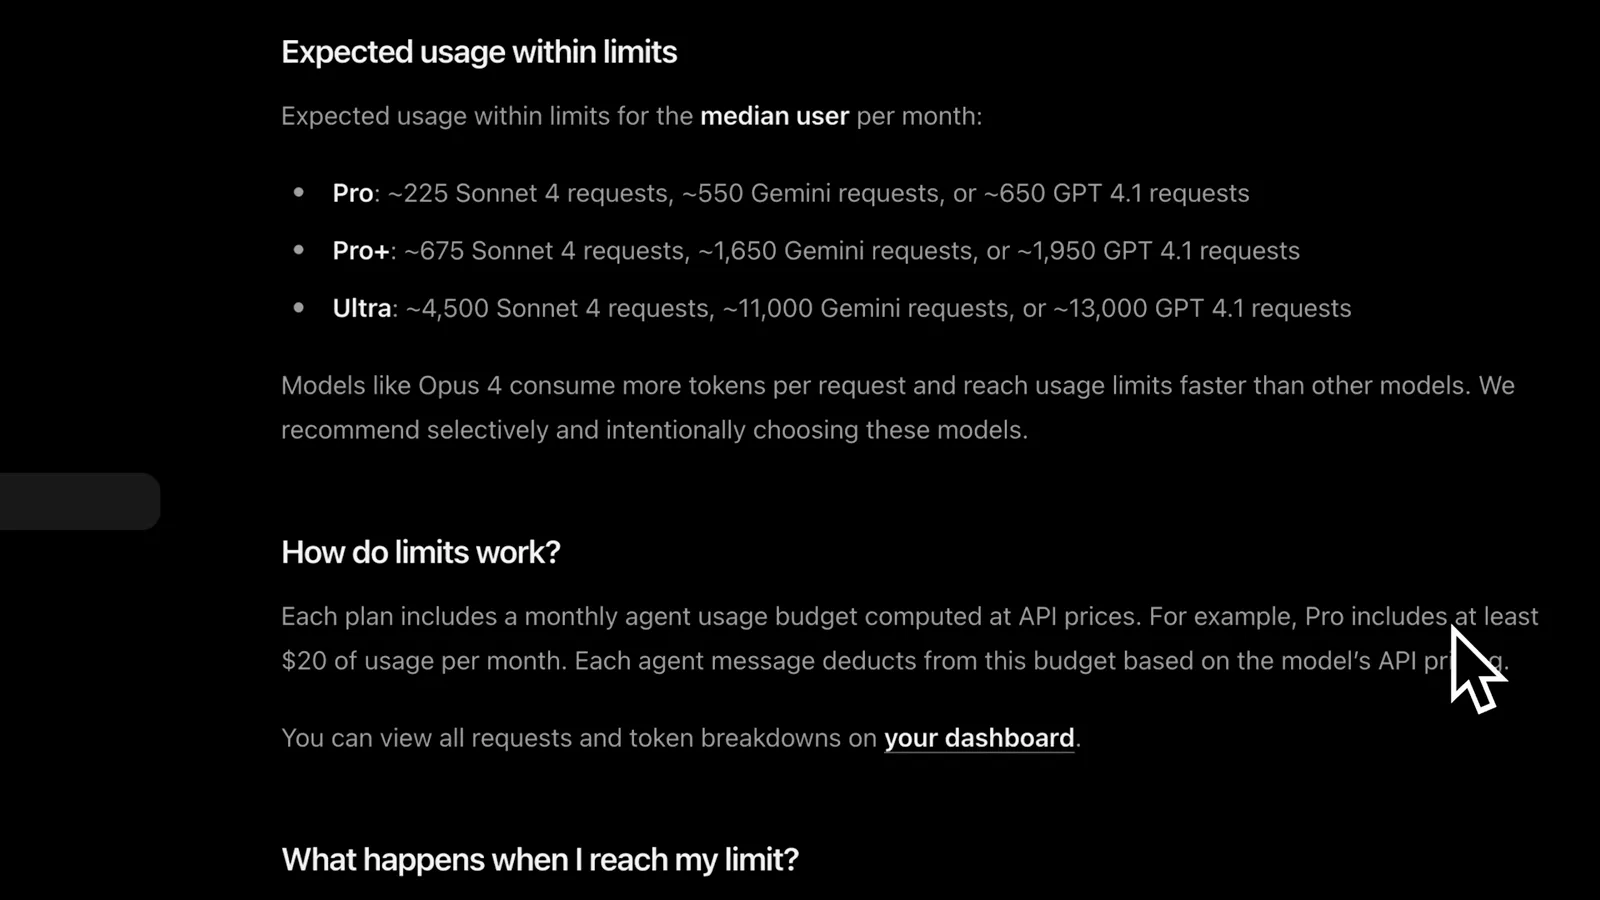
A resposta oficial para «O que acontece quando atinjo meu limite?»Assistir em 4:44 - 11
Acompanhar o consumo com um monitor no terminal
O vídeo recomenda o Claude Code Usage Monitor open source (Maciek-roboblog no GitHub, licença MIT, instala com uv ou pip) e o mantém numa segunda aba de terminal. Ele lê os próprios logs de sessão do Claude Code, então o uso aparece ao lado do seu trabalho — sem interface web separada para manter aberta.
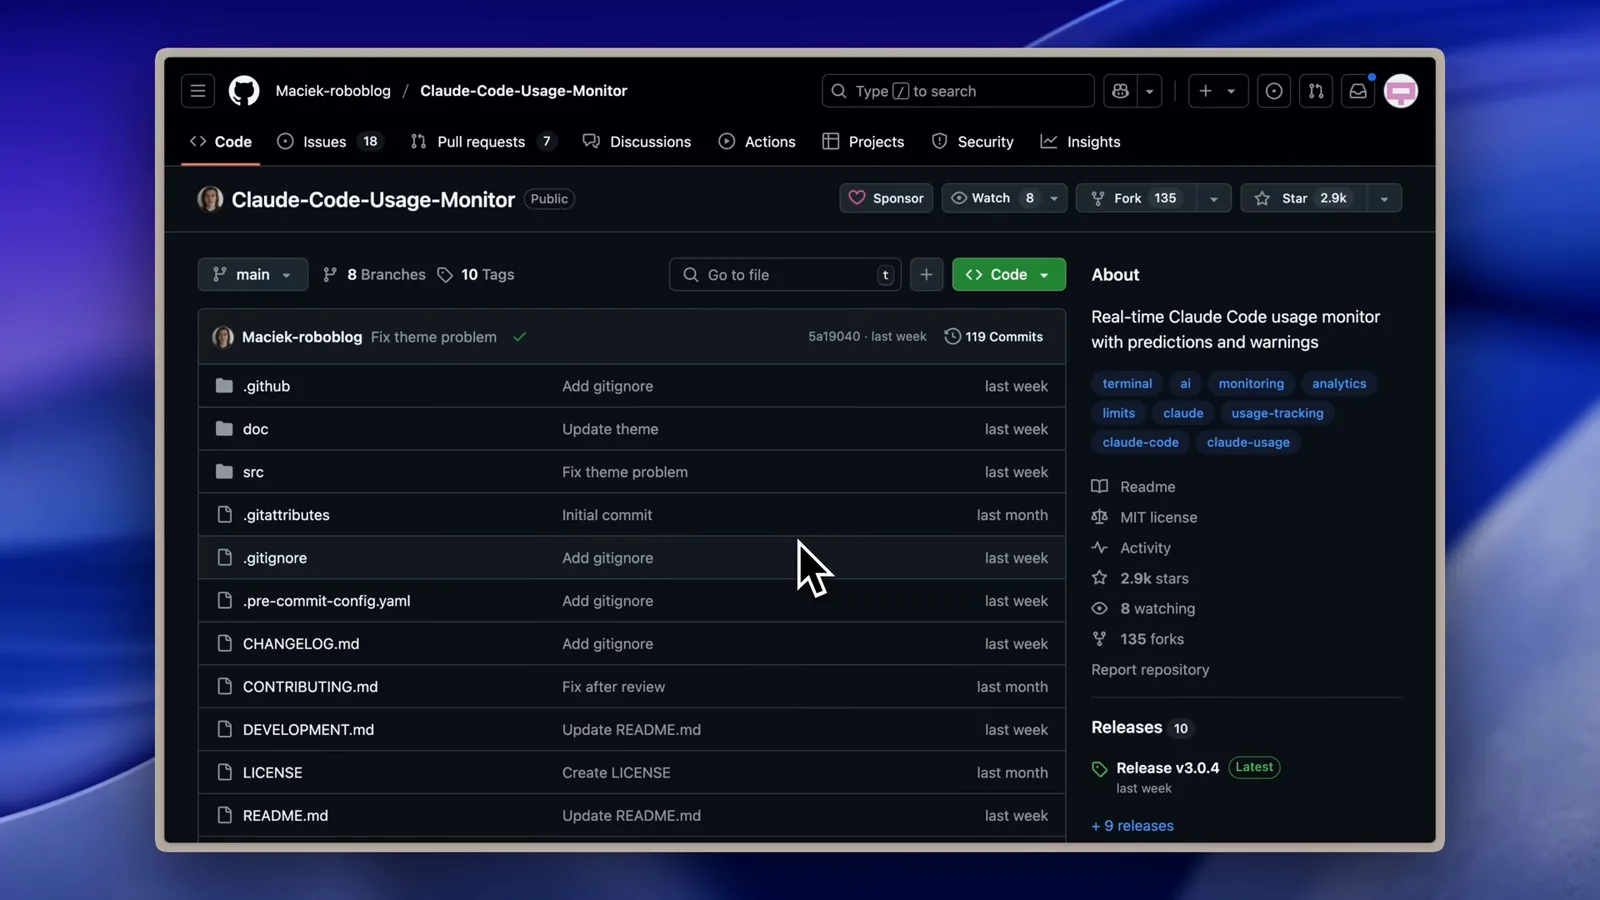
O monitor que o vídeo recomenda: Maciek-roboblog/Claude-Code-Usage-Monitor.Assistir em 6:22 - 12
Vigiar o contador de reset e o burn rate
O TUI mostra barras de custo, tokens e mensagens, a contagem Time to Reset (2 h 52 min no vídeo), distribuição de modelos e um burn rate ao vivo com previsões como «Tokens will run out: 3:00 PM». Com a janela de 5 horas na tela, uma desaceleração súbita deixa de ser mistério — você vê o teto se aproximando.
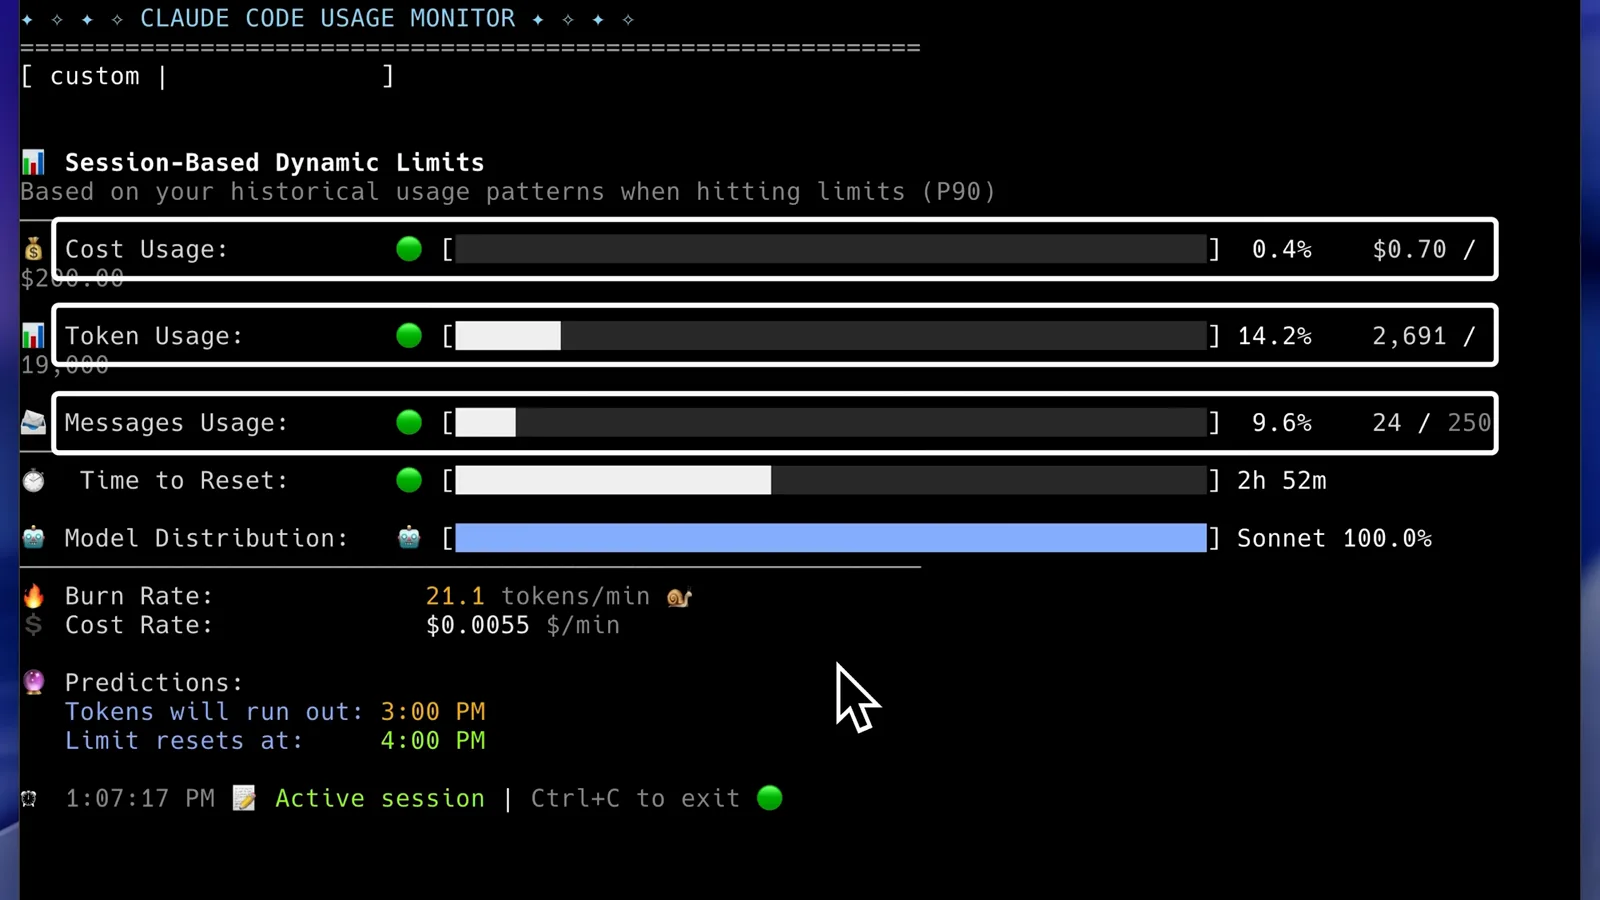
Burn rate e contador de reset, ao vivo numa aba do terminal.Assistir em 6:50
Claude Code contra Cursor, Codex e o mês passado
Quem busca «claude code slower than cursor» e «than codex» geralmente compara configurações diferentes, não motores diferentes. O que realmente difere:
- 1Contra o Cursor — o Cursor traz seu próprio pipeline de contexto e, na época do vídeo, cortava a janela do modelo para uns 120k tokens, enquanto o Claude Code dá ao Claude os 200k completos mas carrega mais do seu repo dentro. Nenhum é «mais rápido» em absoluto: sente-se mais rápida a ferramenta que mantém a janela mais leve.
- 2Contra o Codex CLI — a mesma física. Qualquer agente de código freia quando o prompt arrasta um repo inteiro; /clear, um arquivo de contexto enxuto e compacts com foco transferem um a um para o Codex. Filas de modelo e rate limits dependem do plano, não do terminal.
- 3Contra o Claude Code do mês passado («mais lento que antes») — desconfie primeiro do tamanho da sua sessão, não do release. Sessões longas cruzam o limiar do auto-compact e cada compactação é em si uma requisição grande; /clear e um briefing de duas linhas geralmente devolvem a agilidade de antes. Depois confira o changelog e rode claude --safe-mode para descartar uma personalização.
- 4Contra o chat do claude.ai — o chat parece instantâneo porque não lê seu repo. O Claude Code troca esse peso de partida pela capacidade de agir: janela de contexto completa, ferramentas locais, edições no disco. Julgue pelo tempo da tarefa, não pelo primeiro token.
- 5O veredito honesto — a latência bruta dos modelos é parecida nos agentes de ponta. As diferenças que você sente são tamanho de contexto, inicialização de MCP e filas de rate limit — as três se medem e as três se consertam nesta página.
Se você trocou de ferramenta por causa da velocidade, rode a mesma tarefa duas vezes — lendo o /context antes de cada turno — e compare as contagens de tokens. A maioria das histórias de «essa ferramenta é mais rápida» é, na verdade, «essa sessão era menor».
Ainda lento? Percorra a lista
Lentidão tem algumas causas bem distintas, cada uma com seu sinal. Quando os passos acima não explicam seu atraso, desça esta lista:
- 1Hoje gira tudo, em todo repo → confira status.claude.com primeiro. Incidente do provedor aparece como esperas longas e retries em todos os lugares ao mesmo tempo; nada local resolve, e a contagem de tokens da linha de status fica suspeitamente baixa enquanto os segundos sobem.
- 2Um erro como «Invalid API key · Please run /login» → isso é autenticação, não velocidade, mas trava a sessão do mesmo jeito. Rode /login para se reautenticar; em casos teimosos a documentação recomenda /logout, fechar o Claude Code e recomeçar. Remova também um ANTHROPIC_API_KEY solto — ele se sobrepõe ao login da sua assinatura.
- 3Lento só depois de uma hora de trabalho → a janela de contexto encheu. O auto-compact resume o histórico antigo perto do limiar e cada compactação é em si uma requisição grande. Um /compact com foco (por exemplo: manter só o plano e o diff) ou /clear e um briefing de duas linhas.
- 4Preso em connecting ou na inicialização de MCP → rode /mcp, localize o servidor pendurado e remova-o daquele projeto. A inicialização ganhou consertos de verdade há pouco — a v2.1.292 lembra por 7 dias dos servidores stdio lentos e não faz mais o primeiro turno headless esperar servidores HTTP.
- 5Pausas de minutos que retomam sozinhas → você está esbarrando no limite de uso. Mensagens de limite de sessão mostram o horário do reset; trocar de modelo não adianta contra um limite por assento, mas /rate-limit-options (v2.1.234+) retoma a tarefa após o reset, e /model só vale para limites específicos de modelo.
- 6O terminal em si engasga — scroll lento, texto fantasma, digitação atrasada → isso é renderização, não inferência. Rode claude --safe-mode para desativar hooks e scripts de statusline por uma sessão; se o engasgo sumir, enxugue seu script de statusline ou seus hooks. Testar a mesma sessão no painel do VS Code e no terminal afina ainda mais.
Mais uma da documentação: se a memória de uma sessão passar de 2,5 GB, reinicie — o claude --continue retoma a conversa num processo novo, geralmente mais rápido que aquele que você deixou.