
أفضل نموذج محلي لـ Cline: إعداد Ollama وLM Studio
أي النماذج المحلية تصلح فعلًا للبرمجة الوكيلية داخل Cline، وكيف توجّه Cline إلى Ollama أو LM Studio، وحلول طول السياق ورفض الاتصال وغياب قائمة النماذج — 13 خطوة موثّقة مقابل التسجيلات والوثائق الرسمية.
الخلاصة السريعة
- القائمة المختصرة للنماذج المحلية مع Cline هي qwen3-coder:30b (19 جيجابايت، سياق 256K، واستدعاء الأدوات) وdevstral:24b وgpt-oss:20b. والثلاثة كلها تحمل شارة tools في صفحة النموذج داخل بيئة التشغيل؛ والنموذج البرمجي الذي يفتقر إلى قالب استدعاء أدوات سيتحدّث عن كودك بدل أن يعدّله.
- بيئتا تشغيل تغطيان كل شيء: Ollama على http://localhost:11434 وLM Studio على http://127.0.0.1:1234. في Cline افتح Settings → API Configuration واضبط API Provider المطابق، واترك Use custom base URL معطّلًا ما لم تكن قد غيّرت المنفذ.
- كل تقرير يقول «النموذج المحلي لا يعمل في Cline» يعود تقريبًا إلى أحد ثلاثة أسباب: الخادم لا يعمل (رفض الاتصال)، أو النموذج غير محمّل (قائمة منسدلة فارغة)، أو نافذة السياق صغيرة جدًا (فينسى الوكيل المهمة ويعيد التفكير من أوله).
- تضع صفحة تكامل Ollama مع Cline الحد الأدنى عند 32K توكن من السياق للبرمجة، وتنتهي البداية السريعة الخاصة بـ Cline بتفعيل Use Compact Prompt. وقد أضاف Cline v4.1.21 محاولة ضغط واحدة إضافية للنماذج المحلية التي ينفد مكانها، لأن llama.cpp وOllama وLM Studio تحصر التوليد عند ما تبقّى من السياق.
أي النماذج المحلية تصلح فعلًا للبرمجة الوكيلية داخل Cline؟
Cline ليس صندوق دردشة. إنه يرسل موجّهًا نظاميًا كبيرًا لاستدعاء الأدوات، ثم يدور في حلقة من استدعاءات الأدوات وفروقات الملفات ومخرجات الطرفية والأسئلة التالية. والنموذج لا ينجح هنا إلا إذا كان قالب محادثته يعرض استدعاء الأدوات عبر واجهة بيئة التشغيل، ويستطيع حمل سلسلة تفكير طويلة بما يكفي. وهذا يقلّص المجال سريعًا: افحص شارة tools في صفحة النموذج قبل أن تنزّل 19 جيجابايت.
- 1مصمّمة للوكلاء — qwen3-coder:30b بإجمالي 30B و3.3B معاملات نشطة لكل توكن، و19 جيجابايت، ونافذة سياق 256K، ودعم للأدوات؛ وهو أقوى مبرمج وكيلي يمكن تشغيله على جهاز بذاكرة 24–32 جيجابايت. وdevstral:24b هو نموذج Mistral لوكلاء البرمجة. أما gpt-oss:20b فهو نموذج OpenAI المفتوح الأوزان مع استدعاء الأدوات والاستدلال، ويستقر عند 16 جيجابايت.
- 2صالح للاستخدام مع تفعيل compact prompt — qwen3 بوسومه من 4B إلى 14B وgemma3:12b يدعمان استدعاء الأدوات ويستطيعان إنجاز مهام صغيرة مثل السكربت وإعادة التسمية واللعبة في هذا الدليل. لكنهما يستهلكان النافذة بسرعة، فارفع طول السياق وابقِ Use compact prompt مفعّلًا.
- 3تجاوزها في العمل الوكيلي — deepseek-coder-v2 نموذج برمجي قوي فعلًا لكنه بلا شارة tools في Ollama، لذا لا تصل إليه استدعاءات أدوات Cline؛ والأمر نفسه ينطبق على النماذج الصغيرة غير الداعمة للأدوات وعلى أي وسم «coder» لا تُظهر صفحته دعمًا للأدوات. فمعايير القياس لا تتنبأ بما إذا كانت حلقة الأدوات ستُغلق.
- 4إن كنت تريد جودة وكيلية لا خصوصية دون اتصال، ففكّر مرتين قبل دفع «ضريبة العتاد» المحلية: فئة النماذج المجانية في Cline تضم أصلًا DeepSeek — فـ DeepSeek V4 Flash مدرج هناك بنافذة سياق تبلغ 1M توكن — أي أن حلقة الوكيل نفسها تعمل دون تنزيل 19 جيجابايت أو ترقية إلى 32 جيجابايت من الذاكرة. أبقِ الاستدلال المحلي للخصوصية والعمل المعزول والتعلّم، وأما مسار الاستضافة فراجع دليل DeepSeek + Cline المرتبط أدناه.
- 5قاعدة عملية للعتاد من صفحة Cline عن النماذج المحلية: 16–32 جيجابايت تشغّل نماذج صغيرة أو مكمّمة، و32–64 جيجابايت تشغّل نماذج برمجية متوسطة الحجم، و64 جيجابايت فأكثر تشتري نماذج أكبر ونوافذ سياق أوسع. وعمليًا، طول السياق لا عدد المعاملات هو ما يكسر حلقة الوكيل المحلي أولًا.
How to Use Cline with LM Studio for 100% Local AI Vibe Coding
القناة:Bootable USBs7:04
Install Qwen 3 Locally in Minutes with Ollama
القناة:Bonverium Studio4:04
Local models — Cline documentation
الوثائق:docs.cline.bot
Cline with Ollama — Ollama integration guide
الوثائق:docs.ollama.com
Cline v4.1.21 release notes (local model compaction)
الوثائق:github.com/cline/cline
اللقطات مأخوذة من تسجيلي شاشة: شرح LM Studio + Cline يوفّر كل لقطات VS Code وCline Settings وLM Studio، وتسجيل منفصل عن Ollama يوفّر لقطات المثبّت ومنتقي النماذج والطرفية. وقد استُبعدت اللقطات التي تحمل طبقات الصانع أو الوجوه أو ترجمات مدمجة، وأُعيد استخراج لقطة واحدة لطول السياق عند طابع زمني دقيق بعد أن وقع التقديم السريع على مشهد خاطئ.
روجعت أسماء المنتجات وعناصر القوائم وأرقام الإصدارات مقابل docs.cline.bot (Local models) وdocs.ollama.com/integrations/cline وصفحات النماذج على ollama.com وملاحظات إصدار cline/cline v4.1.21. وتقتبس اللقطات مقتطفات قصيرة من التسجيلات للتعليق.
جهّز Cline على النماذج المحلية في 13 خطوة
ثبّت Cline وبيئة تشغيل Ollama
- 1
ثبّت إضافة Cline في VS Code
افتح عرض الإضافات (Ctrl+Shift+X) وابحث عن Cline، ثم ثبّت الإضافة المنشورة من cline.bot. قائمة المتجر مزدحمة بالنسخ المشابهة — Cline Chinese وCline Max وCline Pro - CodeAI وBao Cline — وليس رسميًا إلا بند cline.bot. ويستخدم Cline Desktop وواجهة الطرفية إعدادات المزوّد نفسها الموصوفة أدناه.
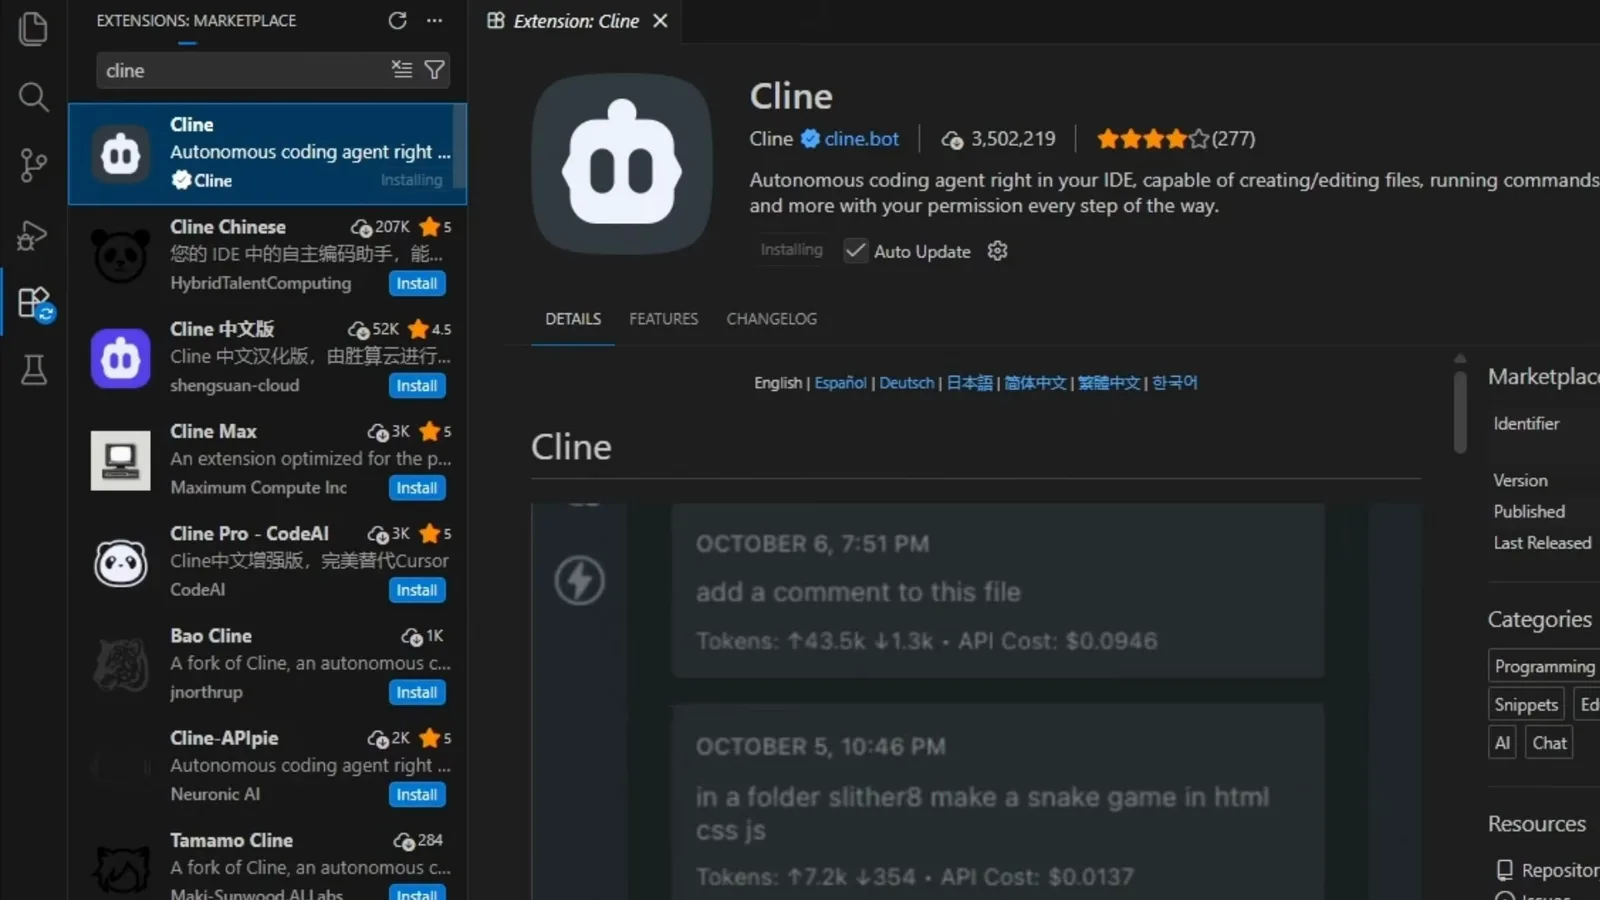
البند الرسمي هو المنشور من cline.bot، لا النسخ المشابهة المكدّسة تحته.شاهد عند 0:50 - 2
ثبّت Ollama عبر معالج الإعداد
نزّل Ollama لنظامك وشغّل المثبّت. معالج ويندوز شاشة تأكيد واحدة، ويليه macOS وLinux بالسلوك نفسه. وعند الانتهاء يبقى Ollama عاملًا كخدمة خلفية تستجيب لواجهة متوافقة مع OpenAI على المنفذ 11434 — وهذه الخدمة، لا نافذة التطبيق، هي ما يخاطبه Cline.
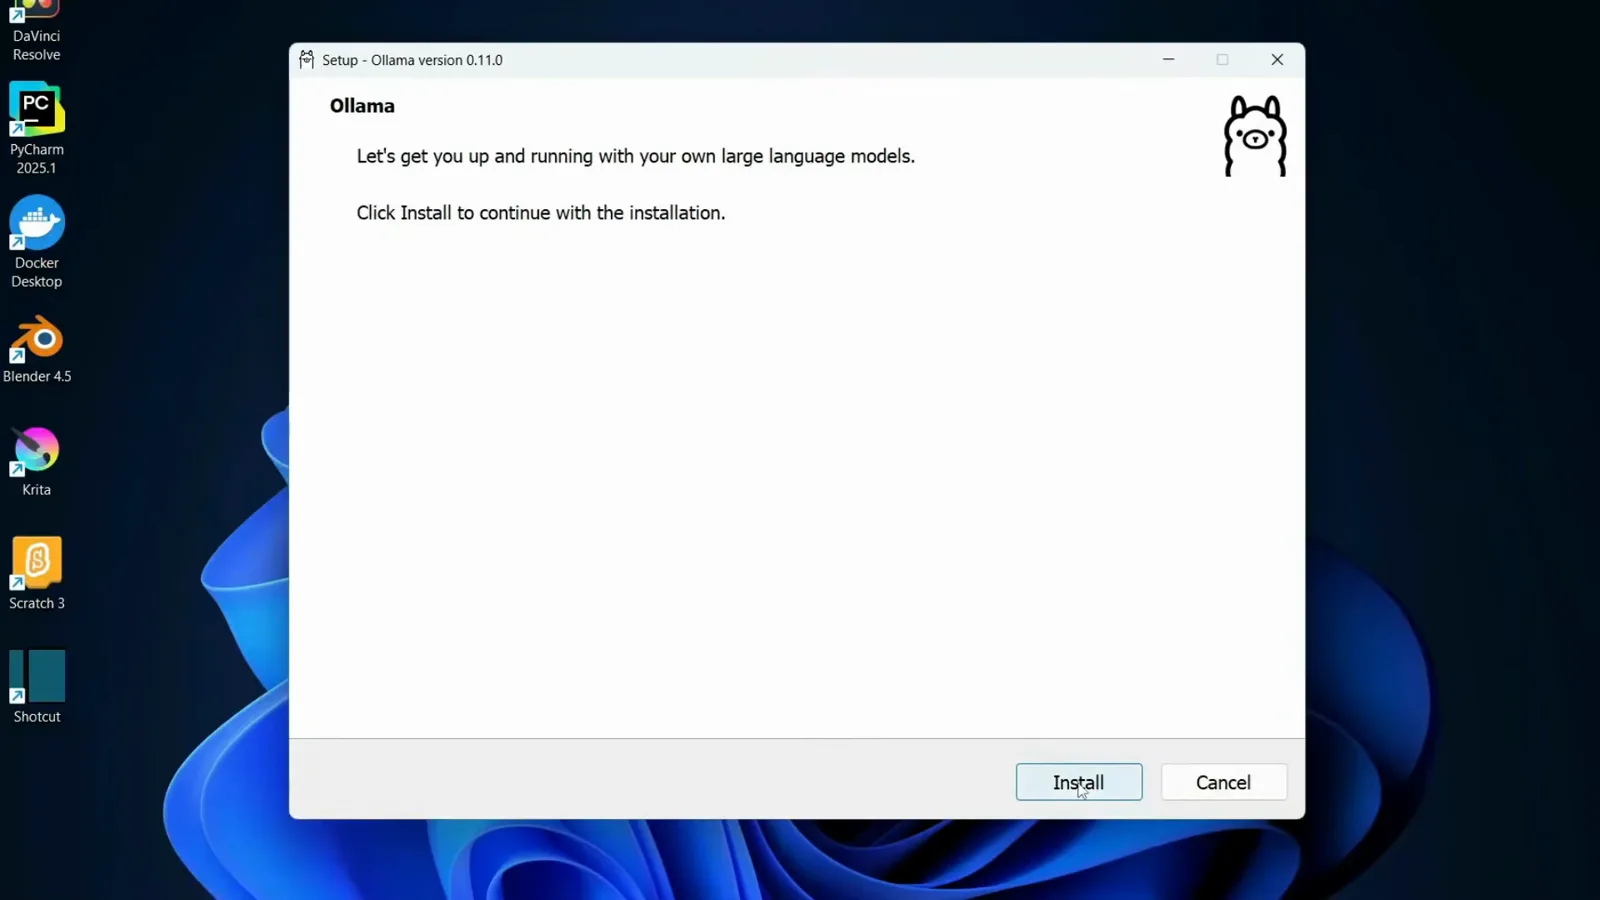
شاشة واحدة وزر Install واحد — يترك المعالج خدمة خلفية تستمع على 11434.شاهد عند 1:00 - 3
اختر نموذجًا يستطيع استدعاء الأدوات
يضم تطبيق Ollama منتقي Find model…؛ ومن الطرفية يفعل الأمر نفسه ollama pull <model>. ومع Cline ابقَ داخل العائلات الداعمة لاستدعاء الأدوات — gpt-oss:20b أو qwen3-coder:30b-a3b أو devstral:24b. وتعرض كل صفحة نموذج في مكتبة Ollama شارات القدرات فوق الوسوم؛ فإن غابت شارة tools، كما هي الحال مع deepseek-coder-v2، فلن تُعالَج استدعاءات أدوات Cline.
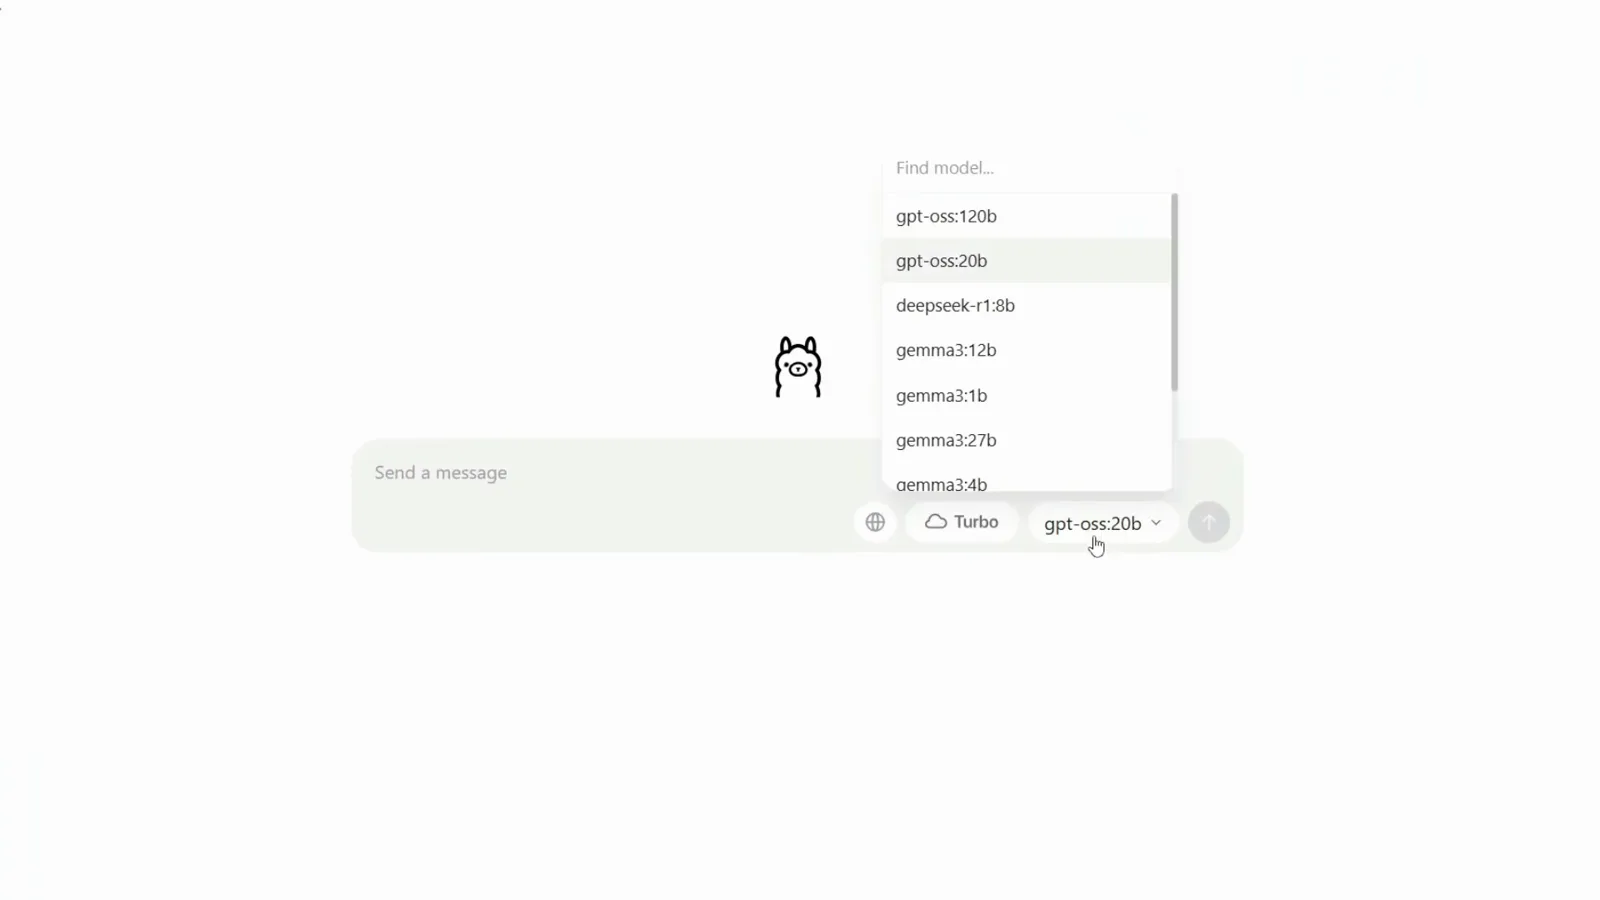
منتقي النماذج في التطبيق يسرد gpt-oss وdeepseek-r1 وgemma3 — والحاسم هنا هو شارة tools في صفحة المكتبة.شاهد عند 2:40 - 4
نزّله وتأكد مما على القرص
يسحب ollama run qwen3 المانيفست ويتحقق من البصمة ثم يدخلك إلى موجه إدخال. ويُظهر ollama list بعدها كل نموذج مثبّت مع حجمه، وهي أسرع طريقة لالتقاط تنزيل لم يكتمل. والأحجام تتذبذب كثيرًا داخل العائلة الواحدة: أصغر وسم لـ qwen3 أقل بكثير من جيجابايت، بينما وسم المبرمج 30B يبلغ 19 جيجابايت.
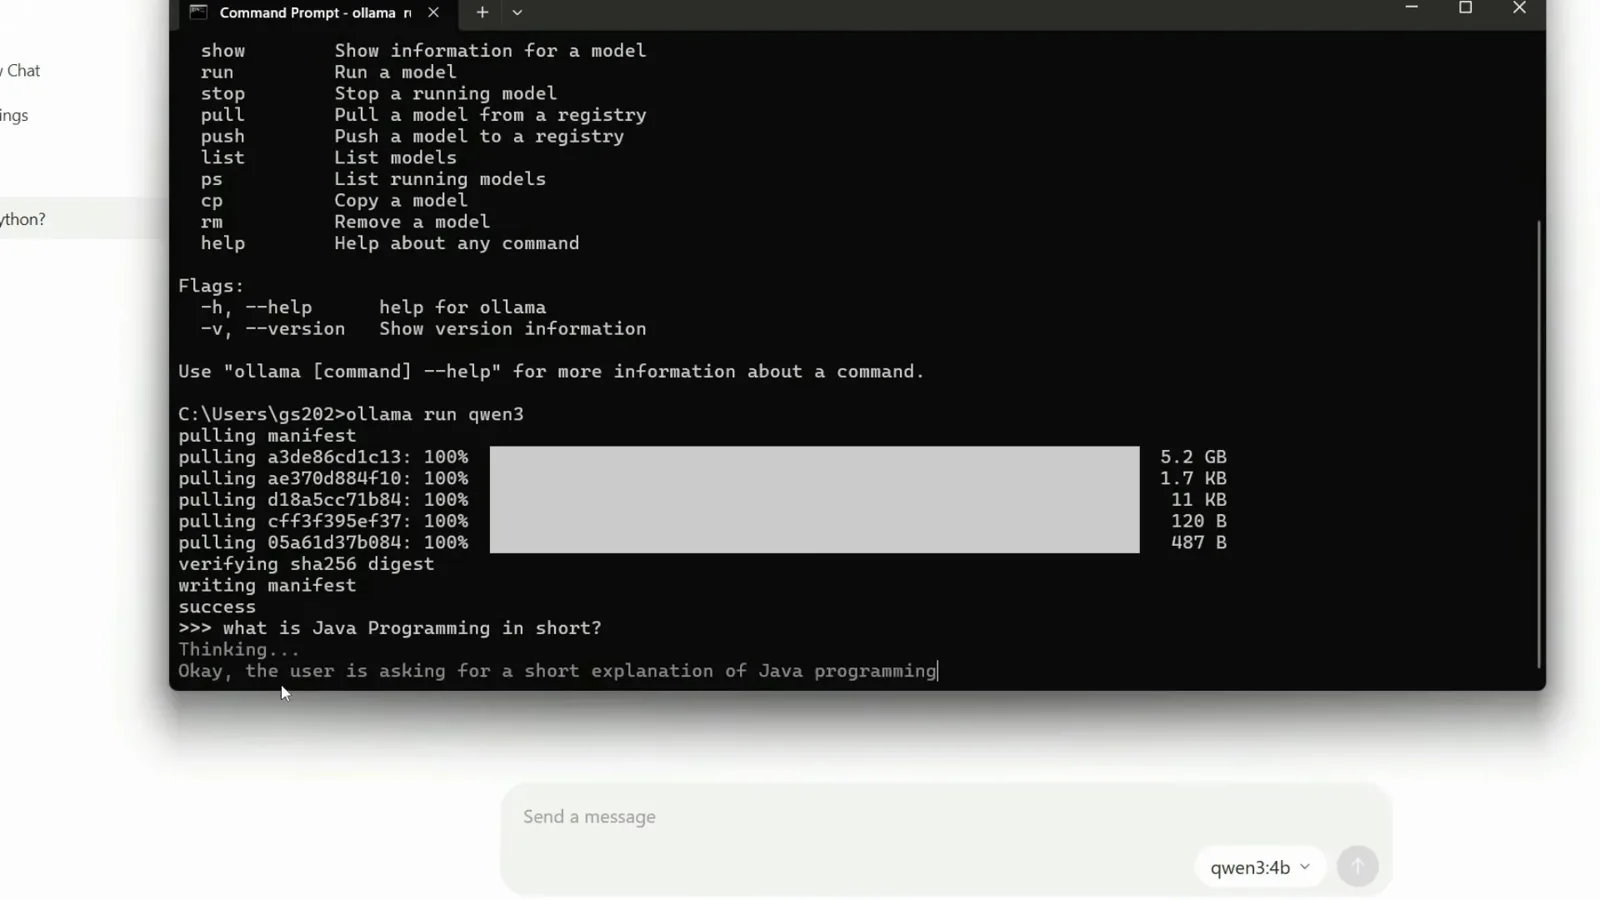
مانيفست ثم بصمة ثم موجه حيّ — ويكفي Cline أن تنجح الخطوتان الأوليان.شاهد عند 3:20
حمّل نموذجًا في LM Studio وشغّل خادمه
- 5
نزّل النموذج داخل LM Studio
يبحث تبويب Discover في LM Studio في كتالوجه الخاص. وبنود Staff Picks موسومة بما تبرع فيه — فـ Qwen3 Coder Next موصوف بأنه 80B MoE بـ 3B معاملات نشطة، مصمم لوكلاء البرمجة ويتفوق في الاستدلال طويل المدى واستخدام الأدوات المعقّد، وتضم نتائج المجتمع إصدارات DeepSeek-Coder-V2. واقرأ حجم التنزيل قبل الالتزام: إصدار Q4_K_M الظاهر هنا 48.49 جيجابايت.
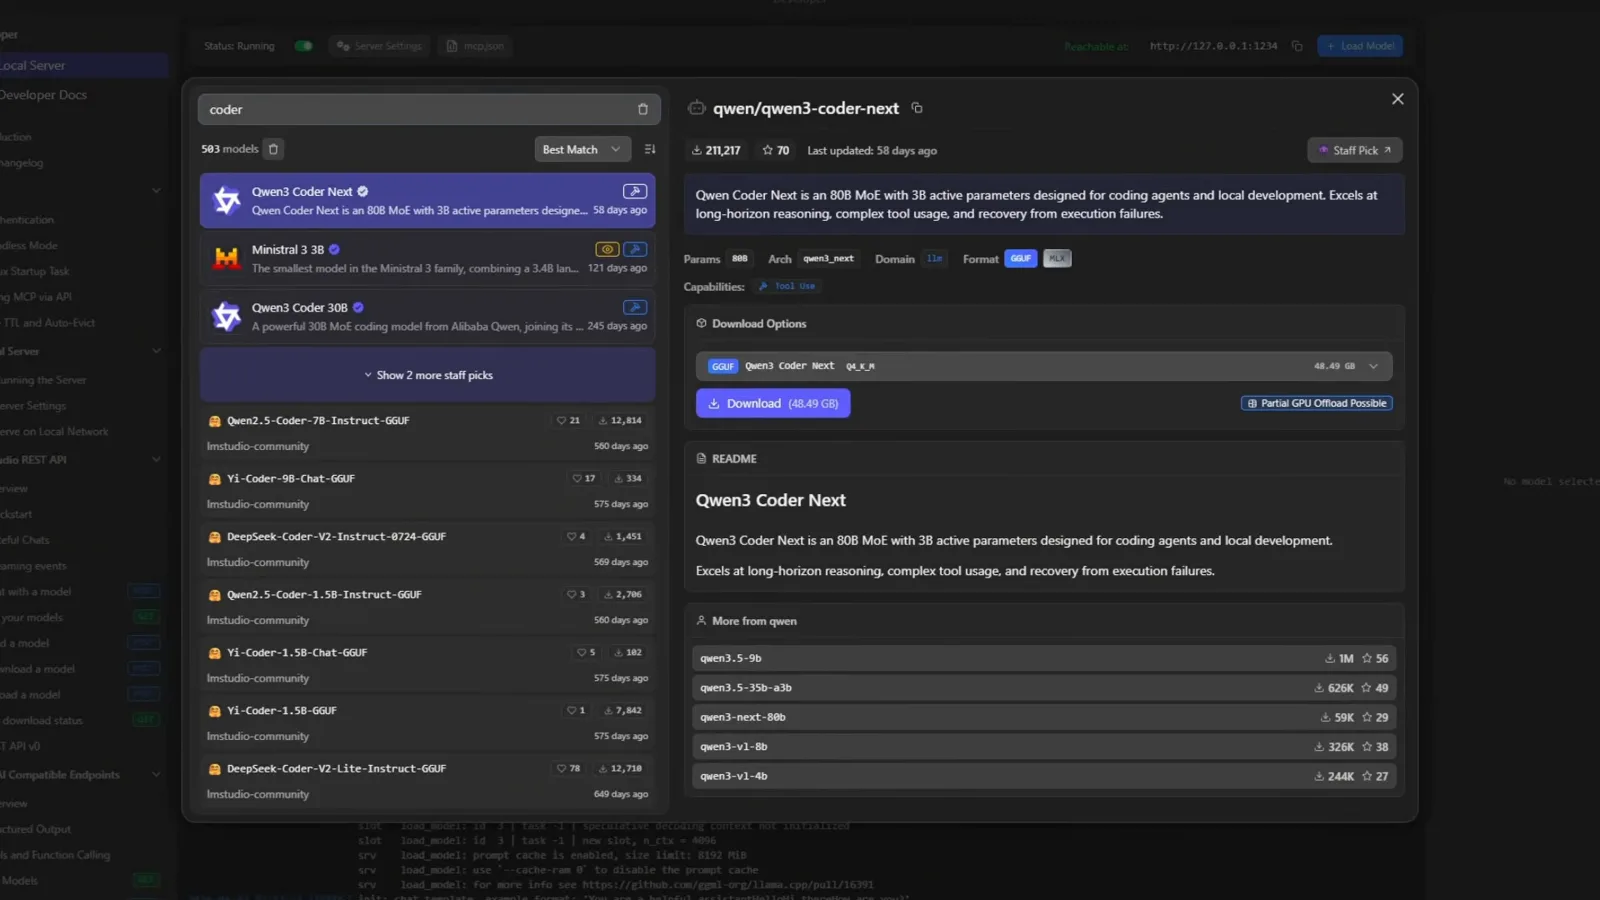
Tool Use قدرة موسومة هنا، وكذلك حجم التنزيل — افحص الاثنين قبل بدء النقل.شاهد عند 1:45 - 6
شغّل خادم LM Studio المحلي
افتح تبويب Developer → Local Server وشغّل الخادم؛ وStatus: Running يعني أن التطبيقات الأخرى تستطيع الاتصال. ويعلن LM Studio نقطة نهاية متوافقة مع OpenAI على http://127.0.0.1:1234 ويسرد نقاط النهاية المدعومة (LM Studio API وOpenAI-compatible وAnthropic-compatible) أسفل المفتاح مباشرة. والخادم مطفأ حتى تشغّله، وهذا أشيع سبب لخطأ الاتصال في Cline.
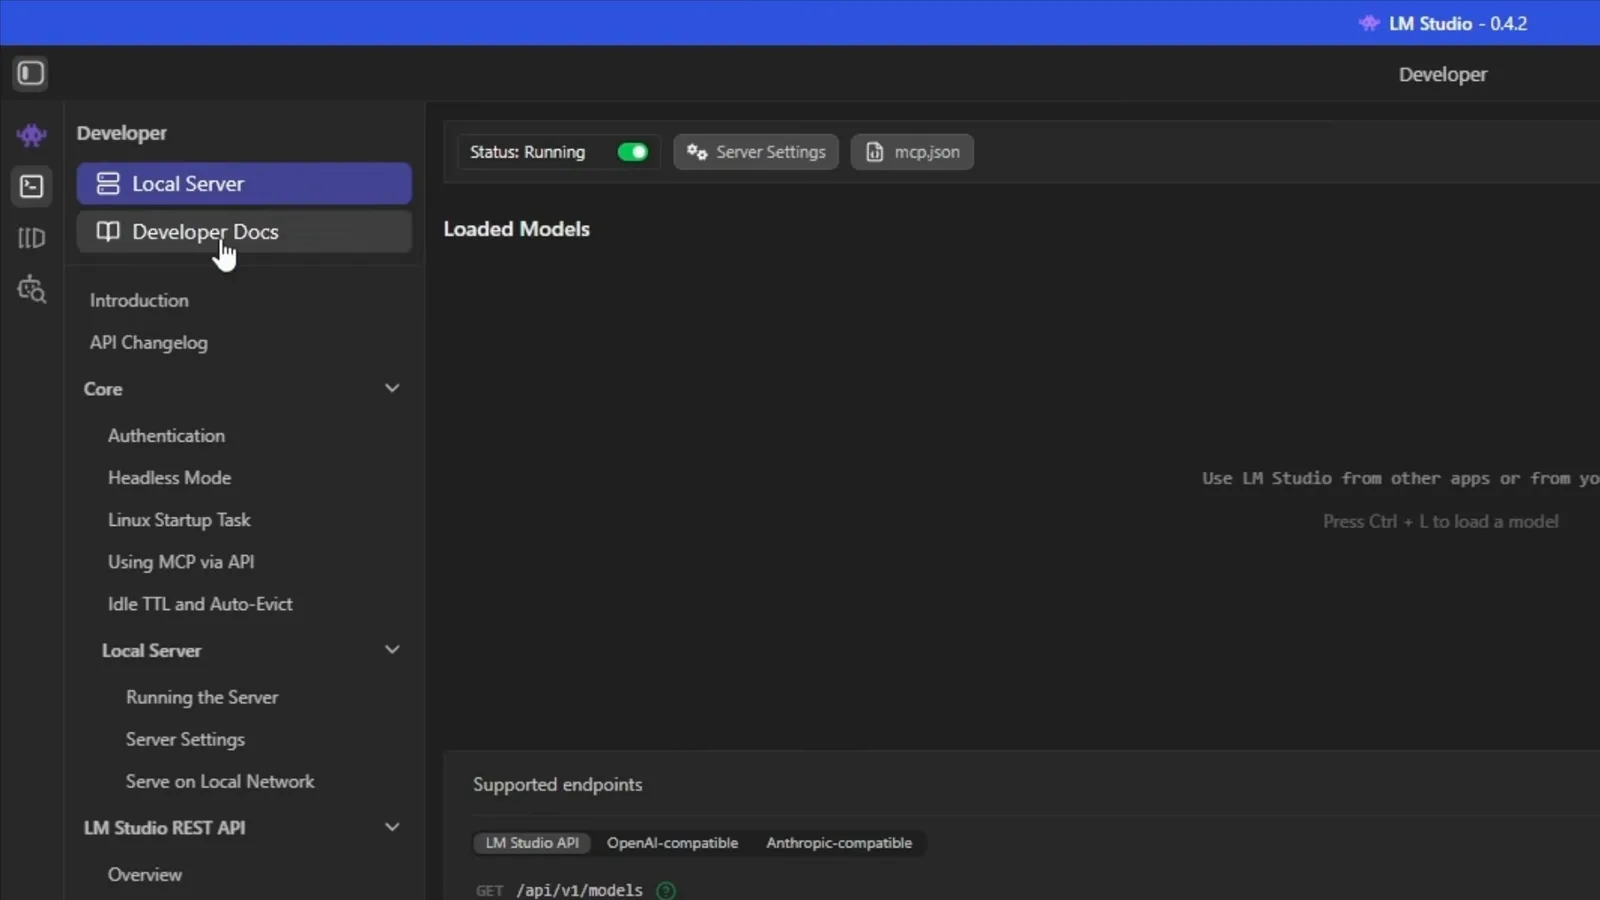
Status: Running هو الضوء الأخضر — ونقطة النهاية متوافقة مع OpenAI على 127.0.0.1:1234.شاهد عند 2:10
وجّه Cline إلى الخادم المحلي
- 7
اضبط مزوّد API في إعدادات Cline
افتح Settings → API Configuration في Cline واضبط API Provider على LM Studio (أو Ollama). واترك Use custom base URL دون تحديد ما دمت على المنافذ المحلية الافتراضية، ولا تملأه إلا إذا انتقل الخادم إلى منفذ آخر أو جهاز آخر. واقرأ ملاحظة Cline نفسها في هذه اللوحة: تقول إن Cline يستخدم موجّهات معقّدة ويعمل أفضل مع نماذج Claude، وإن النماذج الأقل قدرة قد لا تعمل كما هو متوقع.
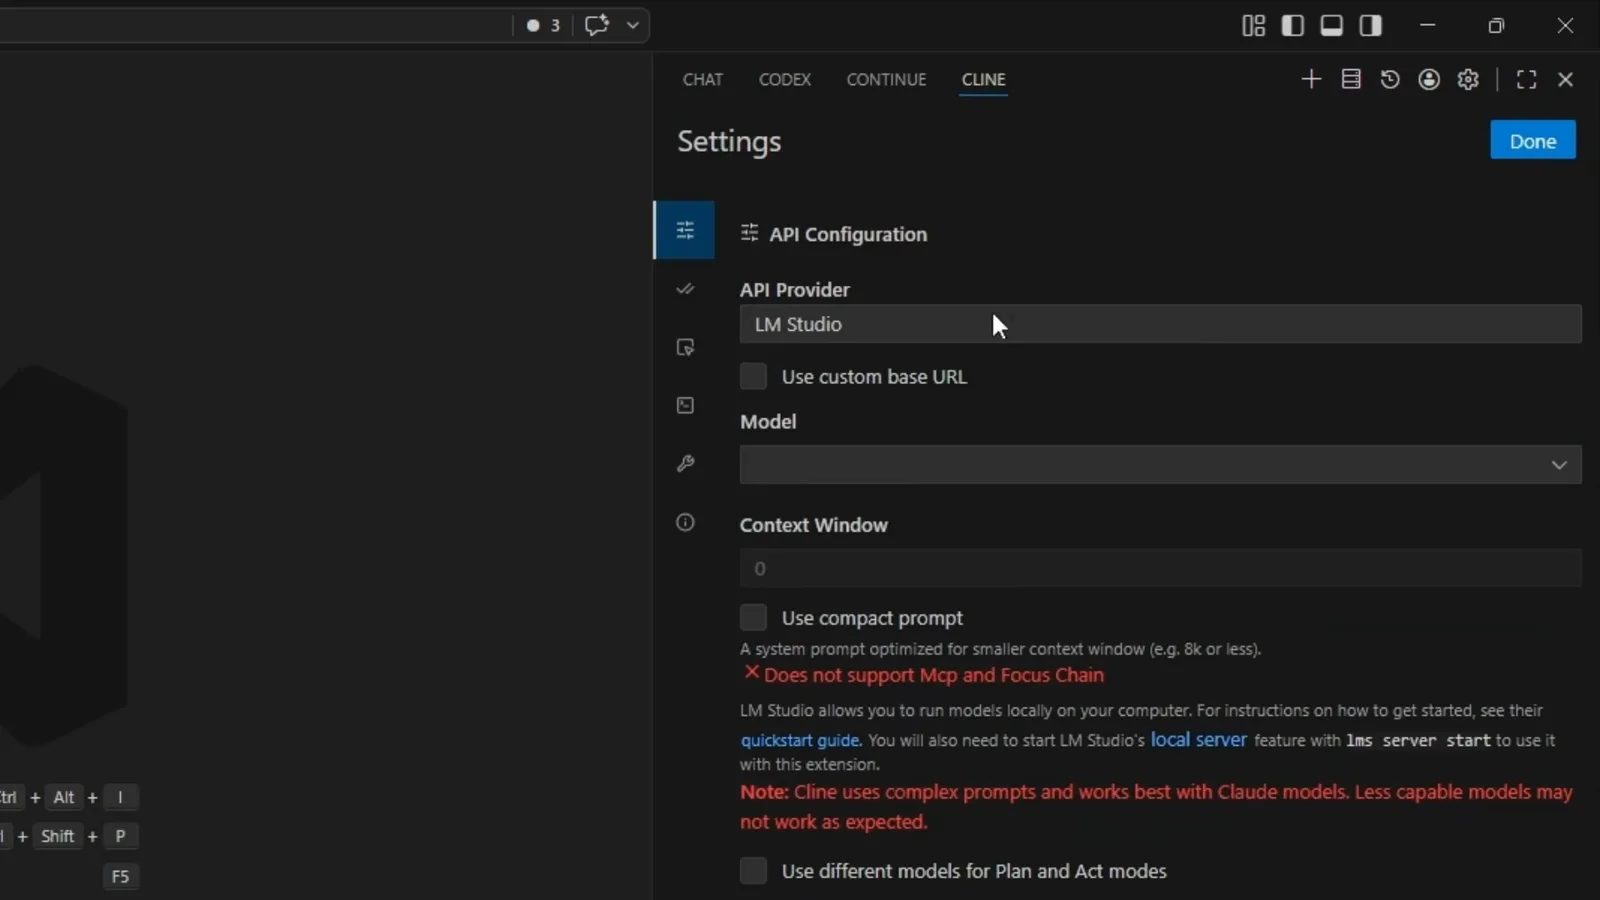
المزوّد أولًا؛ ويبقى base URL دون مساس ما لم تكن قد نقلت الخادم فعلًا.شاهد عند 3:00 - 8
اختر النموذج الذي يقدّمه الخادم
تُملأ القائمة المنسدلة Model من الخادم العامل، لذا تسرد ما تحمله بيئة التشغيل فعلًا — في هذا التسجيل qwen/qwen3-4b وqwen2.5-coder-7b-instruct وqwen2.5-coder-3b-claude_opus_4.6-distilled وgemma-3-27b-it-abliterated وmeta-llama-3-8b-instruct وyi-coder-1.5b ونموذج تضمين. وإن غاب نموذجك عن هذه القائمة فهو غير محمّل في LM Studio أو غير مسحوب في Ollama؛ واختيار نموذج 1.5B أو نموذج تضمين هنا هو ما يجعل الناس يستنتجون أن النماذج المحلية لا تعمل.
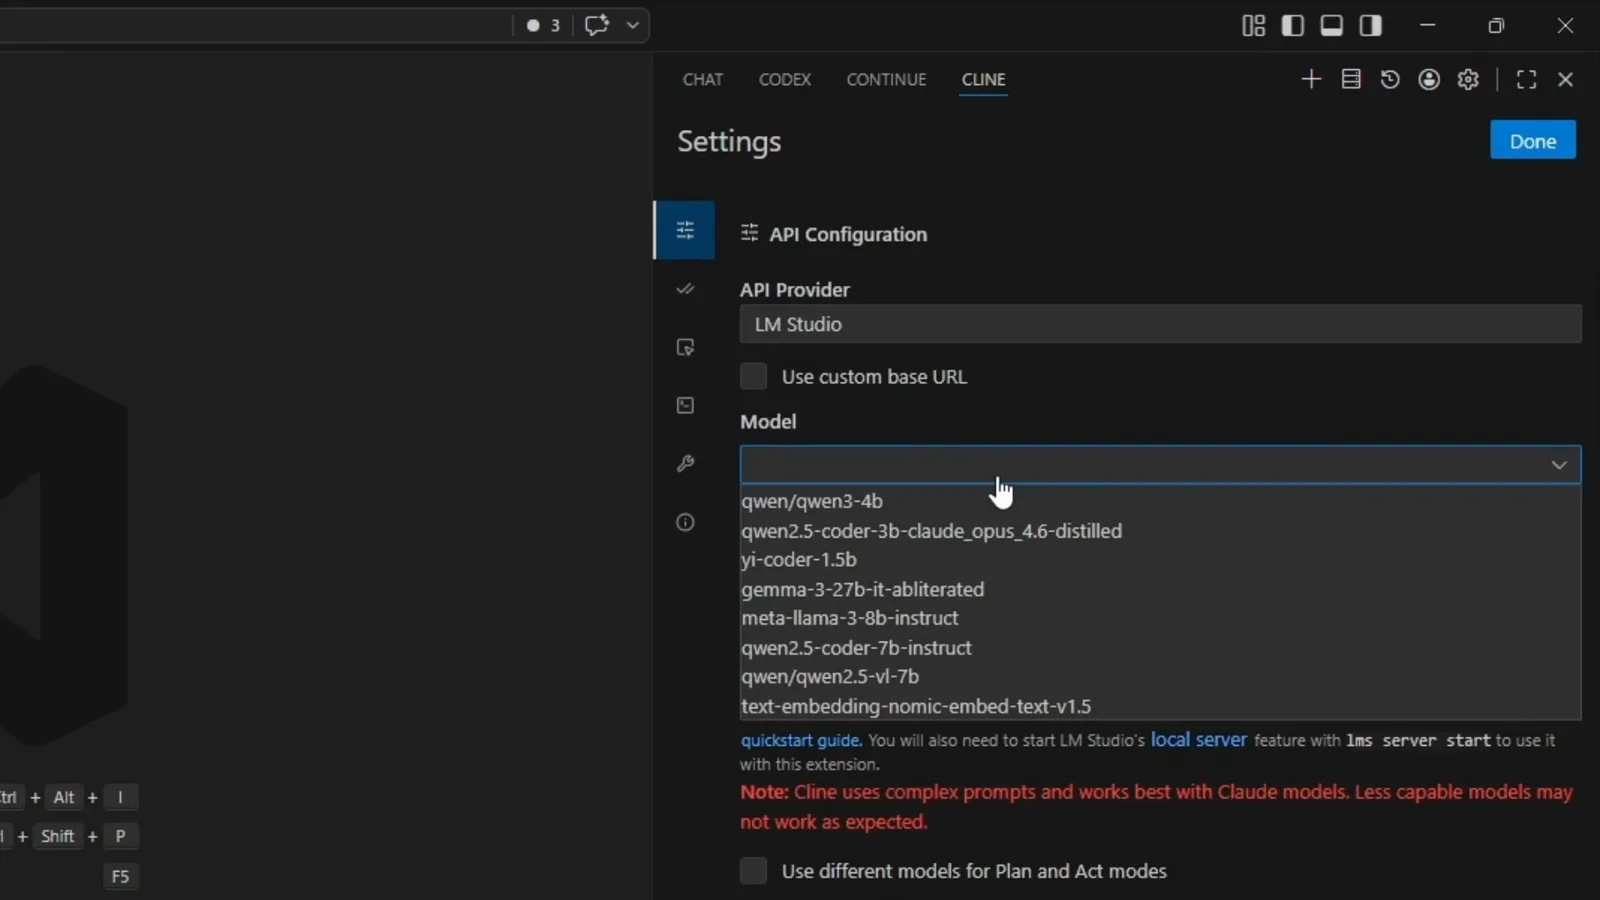
كل ما يبلّغ عنه الخادم يظهر هنا — ونموذج التضمين في القائمة واحد يُترك وشأنه.شاهد عند 3:03 - 9
اقرأ Context Window وفعّل Use compact prompt
يرث Cline حجم السياق الذي حمّلت به بيئة التشغيل النموذج: تُظهر هذه اللقطة Context Window بقيمة 4096، مأخوذة مباشرة من إعداد تحميل 4K في qwen/qwen3-4b، وهو أصغر بكثير مما تحتاجه حلقة الوكيل. وتنتهي البداية السريعة الخاصة بـ Cline للنماذج المحلية بتفعيل Use compact prompt، وتضع صفحة تكامل Ollama مع Cline الحد الأدنى للبرمجة عند 32K توكن. وهذا المفتاح يستبدل الموجّه النظامي بموجّه بحجم يناسب نوافذ نحو 8K أو أقل، ويكلّفك دعم MCP وFocus Chain — فارفع نافذة السياق أولًا واتركه كخيار احتياطي.
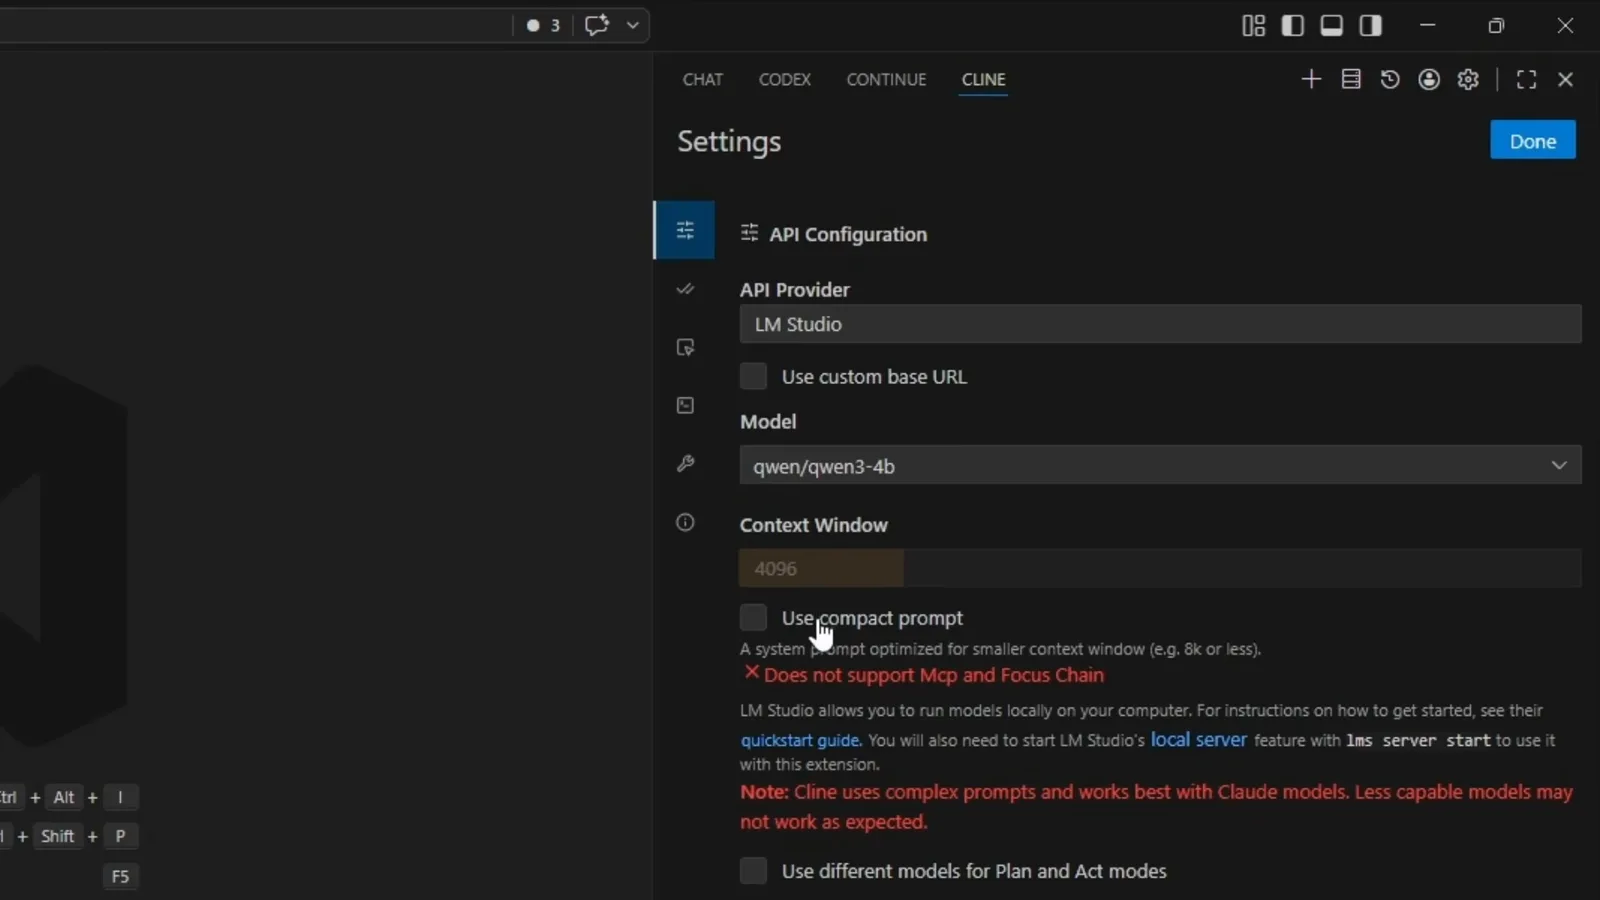
4096 هي العلامة. ارفعها في بيئة التشغيل، ثم أبقِ compact prompt مفعّلًا إن علقت قرب 8K.شاهد عند 3:15
شغّله ثم أصلح ما يتعطل
- 10
شغّل مهمة صغيرة مع تفعيل الموافقة التلقائية
اطلب شيئًا صغيرًا قابلًا للتحقق — اسرد ملفات هذا المجلد، اكتب سكربتًا، شغّله. ومع ضبط الموافقة التلقائية على YOLO يكتب الوكيل الملف ويعرض عليك الفرق ويواصل دون توقف عند كل خطوة؛ ويبقى المحرر ولوحة Problems والطرفية ظاهرين لترى ما نفّذه فعلًا. واترك الموافقة التلقائية مطفأة حتى تثق بالنموذج الذي حمّلته.
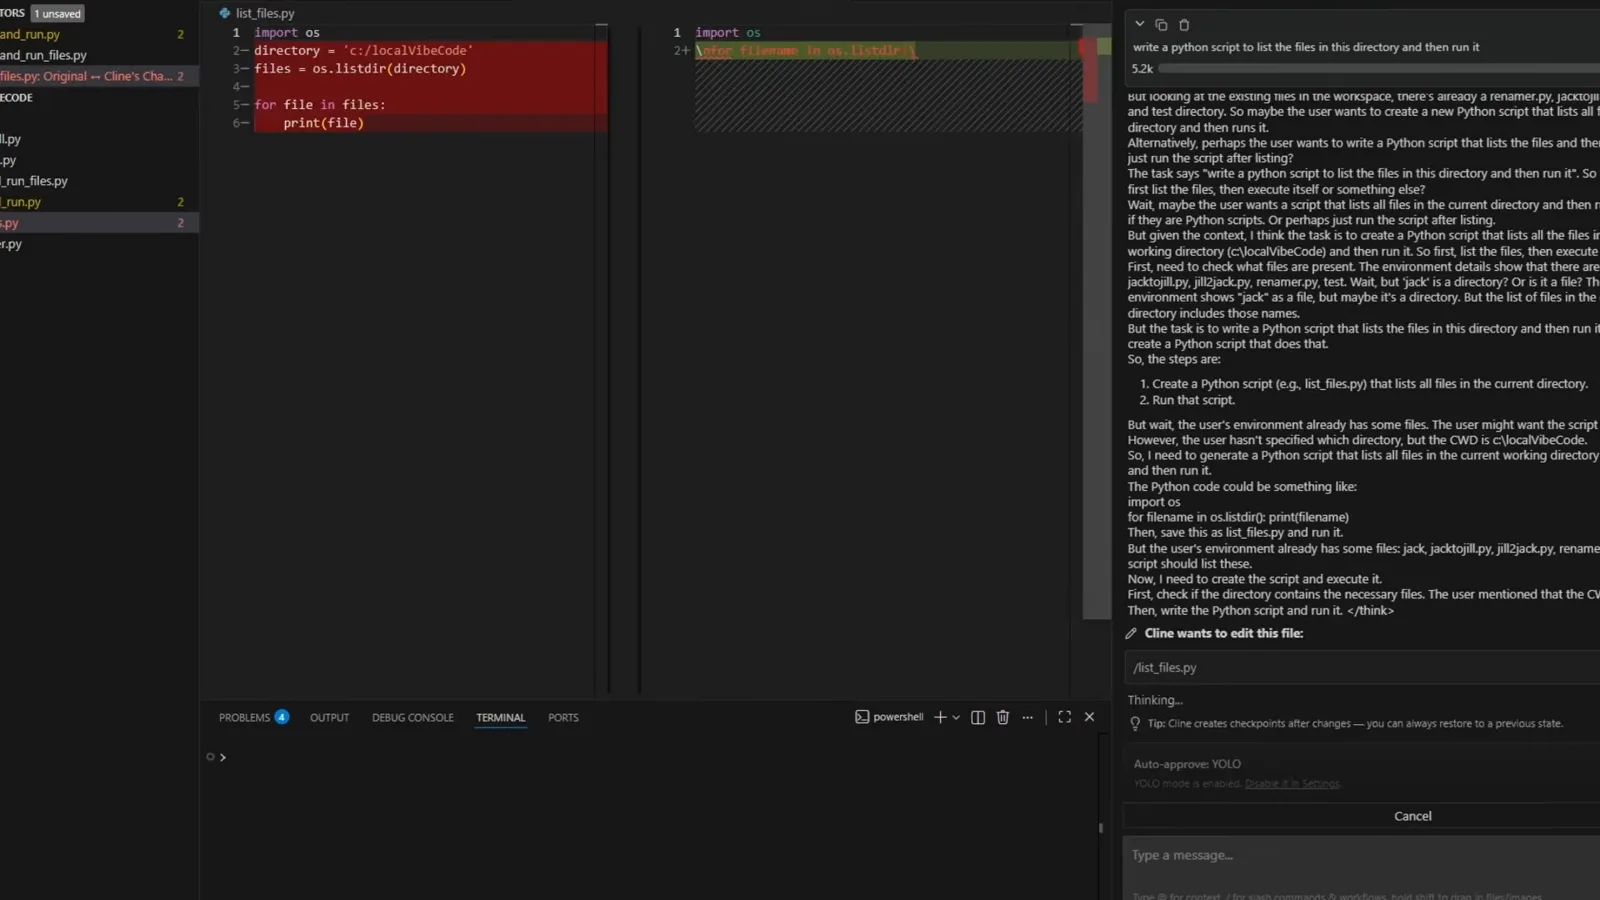
مهمة حقيقية بنموذج محلي: الملف موجود، وCline يريد تعديله، ووضع YOLO هو من يوافق.شاهد عند 4:45 - 11
أصلح «النموذج غير مدرج» بإعادة تحميله
قائمة Cline المنسدلة هي قائمة نماذج الخادم، وLM Studio لا يعلن إلا النماذج المحمّلة حاليًا. ولذلك قد تقرأ صفحة Developer → Local Server عبارة Loaded Models وليس تحتها شيء بينما لا يُظهر Cline أي نموذج. حمّل نموذجًا مرة أخرى (Ctrl + L يفتح المنتقي في LM Studio)، ثم أعد فتح قائمة Model في Cline. وفي Ollama يكون الفحص المكافئ هو ollama list في الطرفية — ويقبل Cline أيضًا وسم نموذج مكتوبًا يدويًا.
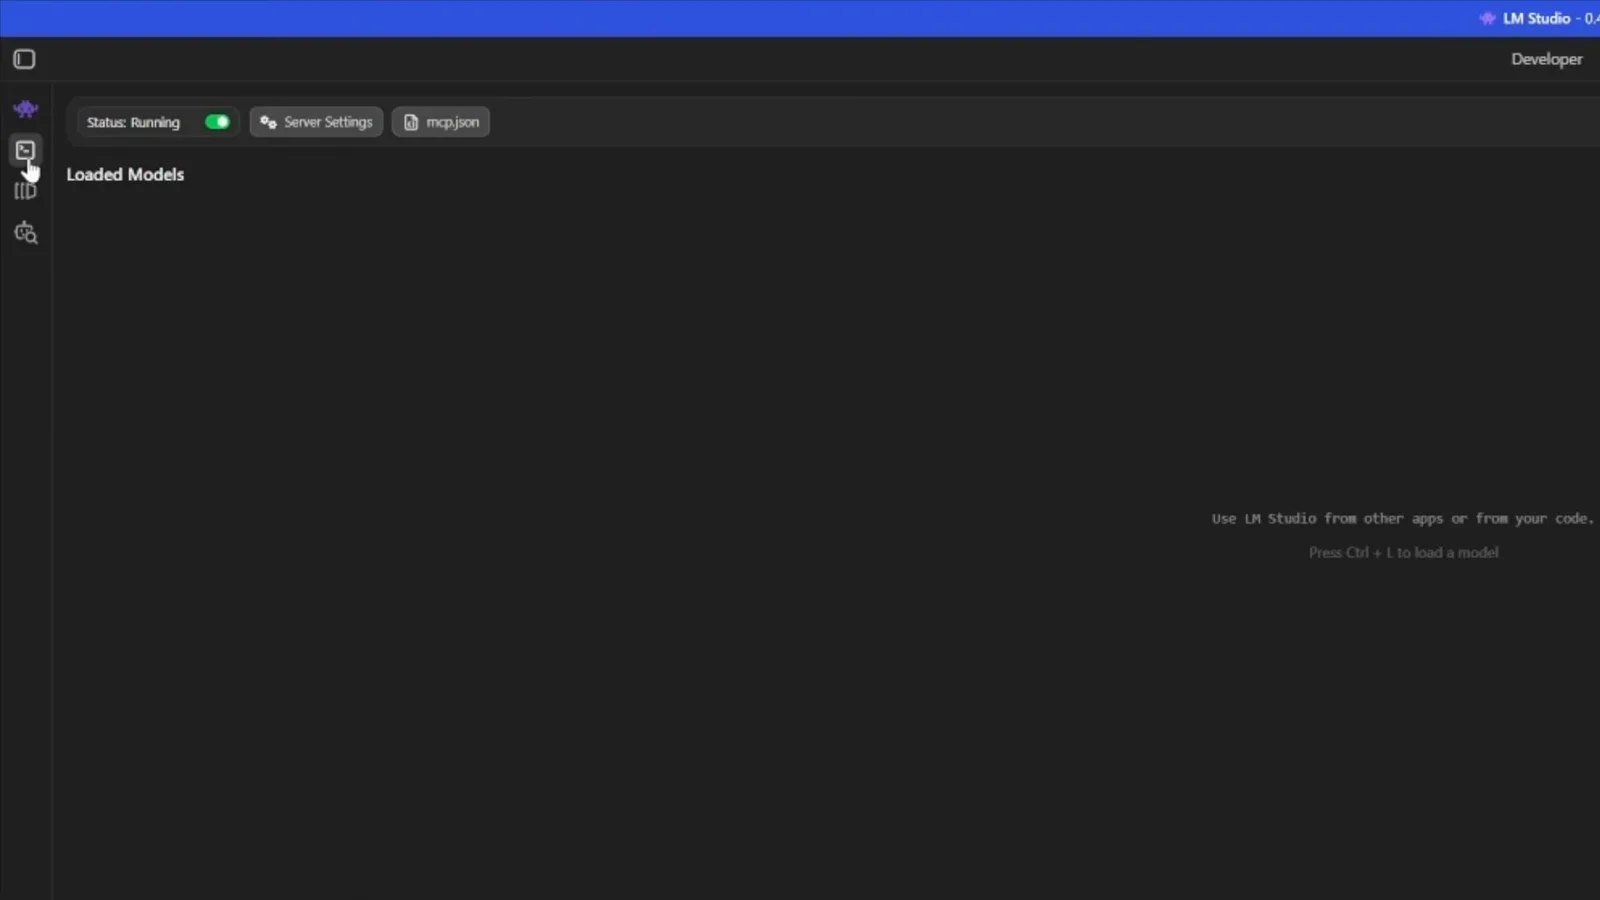
Loaded Models هي قائمة Cline: لا شيء محمّل يعني لا شيء للاختيار.شاهد عند 4:54 - 12
أصلح حلقة التفكير بطول سياق أكبر
حين تكون نافذة السياق صغيرة جدًا يعيد النموذج بدء تفكيره في كل دور ويبدو الوكيل وكأنه نسي المهمة. أخرج النموذج من LM Studio ثم حمّله من جديد مع تفعيل Manually choose model load parameters وارفع Context Length قبل الضغط على Load Model — فقد كان هذا الحوار عند 2048 مع ملاحظة أن النموذج يدعم حتى 262144 توكن. وأضاف Cline v4.1.21 شبكة أمان أيضًا: الرد الطويل على llama.cpp أو Ollama أو LM Studio الذي يبلغ حد توكنات المخرجات يضغط المحادثة ويعيد المحاولة مرة واحدة بدل إنهاء المهمة.
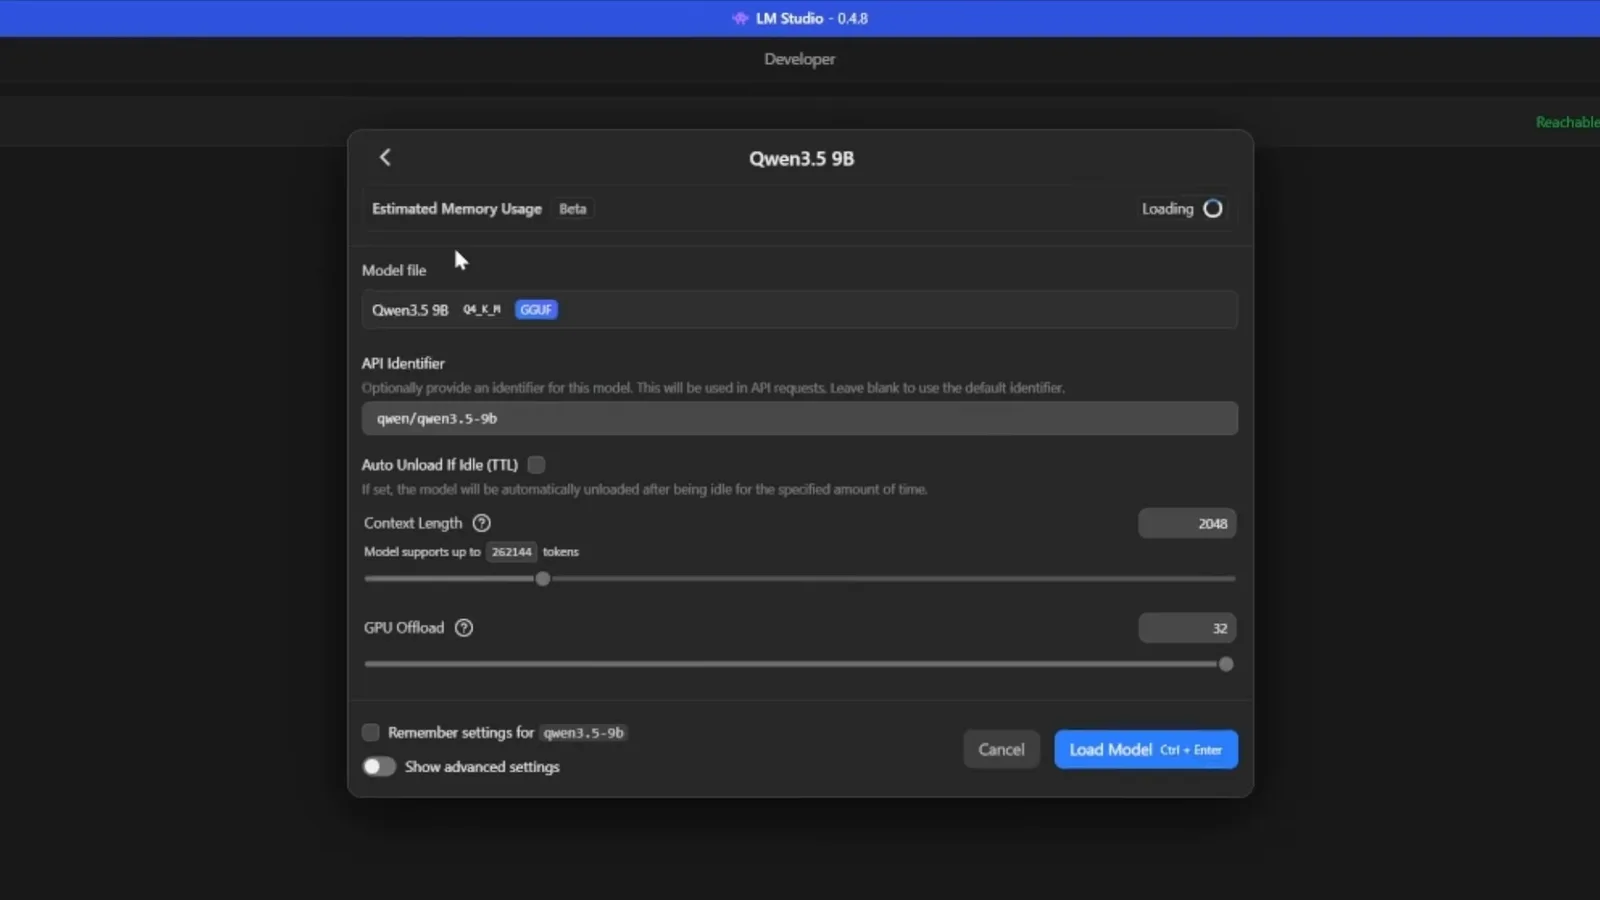
Context Length هو الرافعة، وملاحظة «supports up to» تخبرك بسقف النموذج.شاهد عند 5:06 - 13
تأكد بمهمة تحتاج حلقة طويلة
بنى الإعداد نفسه بعدها لعبة «الثعبان» عاملة بعدّاد أعلى نتيجة: أُنشئت من المحاولة الأولى، وعُدّلت مرة بعد أن أفاد الصانع بأن اللعبة لا تستجيب، وهي قابلة للعب في المتصفح. وكل ذلك عمل محليًا بلا مفتاح API وبلا اشتراك. وإن نجحت إعادة التسمية وفشل البناء، فالحد في السياق أو في استدعاء الأدوات — لا في إعداد Cline.
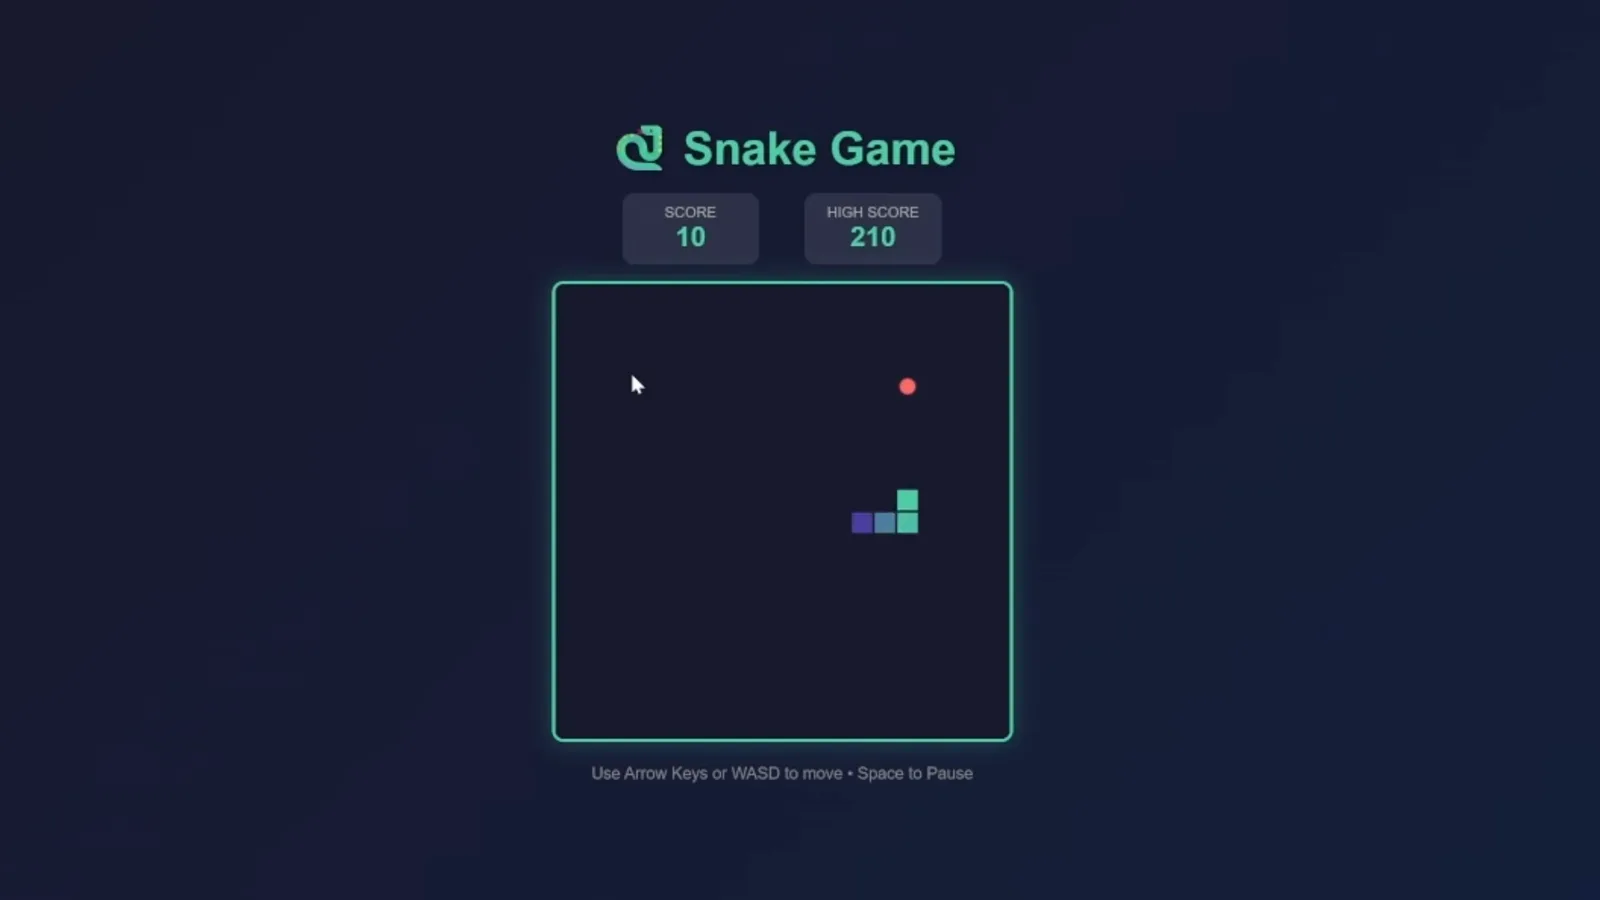
الحالة النهائية: لعبة بناها الوكيل وتعمل محليًا، بلا مفتاح وبلا اشتراك.شاهد عند 5:44
طول سياق Cline + LM Studio: لماذا ينسى الوكيل المهمة
يرسل Cline موجّهًا نظاميًا كبيرًا مع مهمتك، وكل نتيجة أداة، وتفكير النموذج نفسه. وبيئة التشغيل المحلية تحمّل النموذج بطول سياق تختاره هي — فالقيمة الافتراضية في LM Studio لملف GGUF نُزّل للتو صغيرة (يُظهر التسجيل 2048 في حوار التحميل و4096 موروثة في حقل Context Window في Cline) — ويرفض الخادم كل ما يتجاوز ذلك. ونادرًا ما يظهر العطل كرسالة خطأ: النموذج يفقد الخيط ببساطة ويجيب على فكرته الأولى مرة أخرى.
الحل على جهة بيئة التشغيل. أخرج النموذج وأعد تحميله مع خيار المعاملات اليدوي واضبط Context Length على أعلى قيمة تسمح بها ذاكرتك؛ وتضع صفحة تكامل Ollama مع Cline الحد الأدنى للبرمجة عند 32K توكن، وتشير صفحة Cline للنماذج المحلية إلى الإعداد نفسه لنافذة السياق. ثم افحص ما يعرضه Cline في Context Window وأبقِ Use compact prompt مفعّلًا حين لا تستطيع رفع حجم التحميل.
الإصدار يهم هنا. قبل v4.1.21 كان الرد الطويل الذي يستنفد سياق الخادم المحلي ينهي المهمة؛ ومنذ v4.1.21 يضغط Cline المحادثة ويعيد المحاولة مرة واحدة، ثم يلجأ إلى محاولته الموجزة ويحتفظ بالرد الجزئي. وتصرّح ملاحظات الإصدار بالسبب: تلك الخوادم تحصر التوليد عند ما تبقّى من السياق مهما كانت ميزانية المخرجات التي ضبطتها. ويبقى رفع طول السياق المحمّل هو الحل الحقيقي؛ والضغط لا يشتري سوى محاولة ثانية.
Cline + Ollama لا يعمل بعد تحديث: الأسباب الثلاثة الحقيقية
يكاد كل تقرير يعود إلى أحد ثلاثة أسباب، وأولها وحده مشكلة تخصّ Cline.
- 1انحراف صيغة استدعاء الأدوات. غيّر Cline 4.1.x صيغة أدواته مرة أخرى، ويوثّق البلاغ المفتوح cline#13008 تعطّل Ollama المحلي مع Qwen3.6 نتيجة مباشرة لذلك؛ وقد وصل عمل التوافق المقابل على جهة Ollama لصيغ استدعاء الأدوات في qwen3.6 وqwen3-coder. حدّث الإضافة وبيئة التشغيل معًا، ثم أعد الاختبار بنموذج يتفق الطرفان على قالبه — gpt-oss أو qwen3-coder أو devstral.
- 2رفض الاتصال. لا شيء يستمع على المنفذ. فخادم LM Studio المحلي مطفأ حتى تشغّله من Developer → Local Server، ويجب أن تكون خدمة Ollama الخلفية عاملة على 11434. وإن غيّرت المنفذ فحدّد Use custom base URL في Cline وأدخل العنوان كاملًا؛ وإن كانت بيئة التشغيل على جهاز آخر فشغّل Serve on Local Network في LM Studio وافتح المنفذ في جدار الحماية.
- 3النموذج غير مدرج. يسأل Cline الخادم عن قائمة نماذجه، لذا لا يعيد LM Studio إلا المحمّل منها ولا يعيد Ollama إلا المسحوب. حمّل النموذج أو اسحبه ثم أعد فتح القائمة المنسدلة — وتسمح صفحة Ollama الخاصة بـ Cline أيضًا بكتابة وسم النموذج يدويًا، وهي أسرع طريق لتجاوز قائمة قديمة.
- 4تحذير بيئة التشغيل نفسه جدير بالتصديق. تنص لوحة LM Studio في Cline على أن Cline يستخدم موجّهات معقّدة ويعمل أفضل مع نماذج Claude، وأن النماذج الأقل قدرة قد لا تعمل كما هو متوقع. ومبرمج بحجم 1.5B هو نموذج إكمال لا نموذج وكيل — ولا إعداد يحوّله إلى وكيل.
متطلبات بيئة التشغيل والعتاد لـ Cline المحلي
Cline نفسه هو إضافة VS Code ذاتها التي تستخدمها مع مزوّد مستضاف؛ أما النموذج فيعمل خلف بيئة تشغيل تثبّتها أنت. وتسمّي صفحة Cline للنماذج المحلية ثلاث بيئات مدعومة — Ollama وLM Studio وAtomic Chat — وتختصر الإعداد كله في خمسة أسطر: ثبّت بيئة تشغيل، وشغّل خادمها المحلي، واختر المزوّد المطابق في Cline Settings، وحدّد نموذجًا محليًا، وفعّل Use Compact Prompt.
نقاط النهاية والمنافذ: يستجيب Ollama لواجهة متوافقة مع OpenAI على http://localhost:11434 وLM Studio على http://127.0.0.1:1234 تحت /v1. وكلاهما يرتبط بـlocalhost افتراضيًا، فلا شيء يغادر جهازك ما لم تعرّض الخادم للشبكة صراحة.
- 116–32 جيجابايت من ذاكرة RAM — نماذج صغيرة أو مكمّمة في نطاق 7B–14B، ونوافذ سياق متواضعة؛ والاستدلال على المعالج وحده ممكن لكنه بطيء.
- 232–64 جيجابايت من ذاكرة RAM — نماذج برمجية متوسطة الحجم مثل qwen3-coder:30b-a3b (19 جيجابايت) أو devstral:24b، مع متسع لنافذة سياق 32K أو أكبر.
- 364 جيجابايت فأكثر من ذاكرة RAM أو كرت رسومات كبير — نماذج أكبر مع نوافذ سياق أوسع؛ ونموذج 30B بنافذة 64K يحتاج الذاكرة وذاكرة رسومات كافية لتحميله.
يؤكد التسجيل ما تقوله الوثائق: يمكن تشغيل هذه النماذج على المعالج، لكن كرت الرسومات الأقوى يمنح أداءً أفضل بوضوح، وإجمالي ذاكرة النظام يحدد حجم النموذج وحجم نافذة السياق التي تستطيع تحميلها معًا. فاحسب ميزانيتك للنافذة لا للأوزان وحدها.